class: center, middle, titular background-size: contain <img style="border-radius: 50%;" src="img/masapp.jpg" width="250px"/> # Capítulo 4: Análisis exploratorio de datos ## **CAPACITACIÓN** #### LINDA CABRERA ORELLANA #### Mayo, 2023 --- .pull-left[ # Contenido del Capítulo 4 - Análisis exploratorio de datos * Variables numéricas * Variables categóricas * Varias variables numéricas * Variables numéricas con una categórica - Gráficos dinámicos con `plotly` ] .pull-right[ # Paquetes a utilizar * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M374.6 86.6c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 178.7l-57.4-57.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l80 80c12.5 12.5 32.8 12.5 45.3 0l160-160zm96 128c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 402.7 86.6 297.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l128 128c12.5 12.5 32.8 12.5 45.3 0l256-256z"/></svg> `library(tidyverse)` * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M470.6 105.4c12.5 12.5 12.5 32.8 0 45.3l-256 256c-12.5 12.5-32.8 12.5-45.3 0l-128-128c-12.5-12.5-12.5-32.8 0-45.3s32.8-12.5 45.3 0L192 338.7 425.4 105.4c12.5-12.5 32.8-12.5 45.3 0z"/></svg> `library(readr)` * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M470.6 105.4c12.5 12.5 12.5 32.8 0 45.3l-256 256c-12.5 12.5-32.8 12.5-45.3 0l-128-128c-12.5-12.5-12.5-32.8 0-45.3s32.8-12.5 45.3 0L192 338.7 425.4 105.4c12.5-12.5 32.8-12.5 45.3 0z"/></svg> `library(dplyr)` * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M470.6 105.4c12.5 12.5 12.5 32.8 0 45.3l-256 256c-12.5 12.5-32.8 12.5-45.3 0l-128-128c-12.5-12.5-12.5-32.8 0-45.3s32.8-12.5 45.3 0L192 338.7 425.4 105.4c12.5-12.5 32.8-12.5 45.3 0z"/></svg> `library(ggplot2)` * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M374.6 86.6c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 178.7l-57.4-57.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l80 80c12.5 12.5 32.8 12.5 45.3 0l160-160zm96 128c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 402.7 86.6 297.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l128 128c12.5 12.5 32.8 12.5 45.3 0l256-256z"/></svg> `library(magrittr)` * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M374.6 86.6c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 178.7l-57.4-57.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l80 80c12.5 12.5 32.8 12.5 45.3 0l160-160zm96 128c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 402.7 86.6 297.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l128 128c12.5 12.5 32.8 12.5 45.3 0l256-256z"/></svg> `library(plotly)` * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M374.6 86.6c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 178.7l-57.4-57.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l80 80c12.5 12.5 32.8 12.5 45.3 0l160-160zm96 128c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 402.7 86.6 297.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l128 128c12.5 12.5 32.8 12.5 45.3 0l256-256z"/></svg> `library(RColorBrewer)` * <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M374.6 86.6c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 178.7l-57.4-57.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l80 80c12.5 12.5 32.8 12.5 45.3 0l160-160zm96 128c12.5-12.5 12.5-32.8 0-45.3s-32.8-12.5-45.3 0L192 402.7 86.6 297.4c-12.5-12.5-32.8-12.5-45.3 0s-12.5 32.8 0 45.3l128 128c12.5 12.5 32.8 12.5 45.3 0l256-256z"/></svg> `library(scales)` ] --- class: middle, center, inverse <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:3em;width:3em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M24 32C37.25 32 48 42.75 48 56V408C48 421.3 58.75 432 72 432H488C501.3 432 512 442.7 512 456C512 469.3 501.3 480 488 480H72C32.24 480 0 447.8 0 408V56C0 42.75 10.75 32 24 32zM128 136C128 122.7 138.7 112 152 112H360C373.3 112 384 122.7 384 136C384 149.3 373.3 160 360 160H152C138.7 160 128 149.3 128 136zM296 208C309.3 208 320 218.7 320 232C320 245.3 309.3 256 296 256H152C138.7 256 128 245.3 128 232C128 218.7 138.7 208 152 208H296zM424 304C437.3 304 448 314.7 448 328C448 341.3 437.3 352 424 352H152C138.7 352 128 341.3 128 328C128 314.7 138.7 304 152 304H424z"/></svg> # Análisis exploratorio de datos --- ## Análisis exploratorio de datos El análisis exploratorio es un enfoque en el que se "deja hablar a los datos" para que ellos nos den las pistas necesarias para construir modelos o incluso desarrollar supuestos o conclusiones. Conocer los datos "como a la palma de tu mano", este es el primer beneficio del EDA, algo útil seas analista comercial, de marketing, científico, ingeniero o cualquier puesto donde analizar datos sea fundamental. Por conocer, nos referimos a: Comprende las correlaciones entre los elementos, descubrir la estructura subyacente de los datos, detectar valores atípicos y anomalías, etc. Por "dejar a los datos hablar" nos referimos a permitir que los datos sugieran los modelos que se adaptan mejor a ellos datos, encontrar variables importantes o más relacionadas, desarrollar modelos parsimoniosos, etc. --- ## Análisis exploratorio de datos - Permite entender los datos - Sirve para examinar las variables y sus interacciones antes de aplicar las técnicas - Es util para encontrar errores en el set de datos - Se realiza mediante estadísticos descriptivos y principalmente gráficos - Suele ser un proceso iterativo: - se plantea una pregunta - se grafica o se crea una tabla para responder - se obtiene una idea o una nueva pregunta del paso anterior - Proporciona pistas o intuición --- ## Variables numéricas .pull-left[ ### Histograma de frecuencias Para explorar variables continuas graficaremos un histograma de frecuencias con `geom_histogram()`. ```r ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = COMPRAS_RISE)) + geom_histogram(binwidth = 50000, color = "black", fill = "chartreuse4") ``` ] .pull-right[ 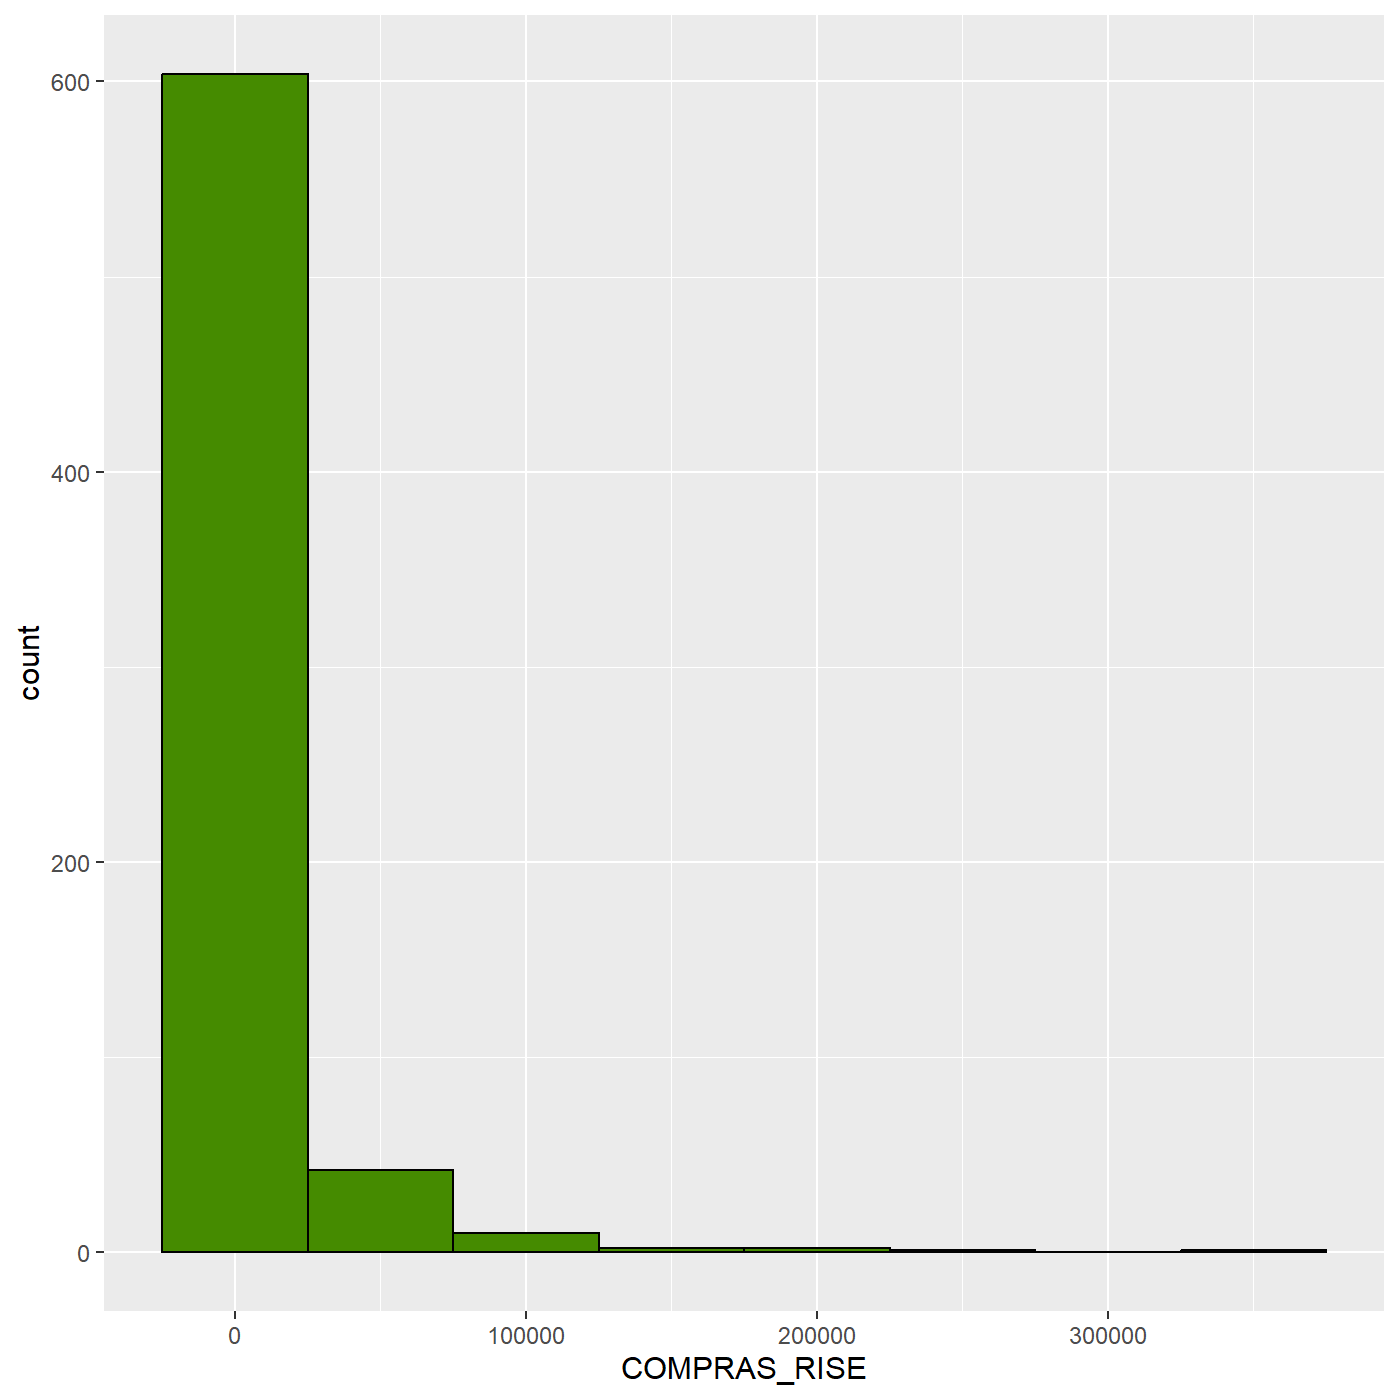<!-- --> ] --- ## Variables numéricas .pull-left[ ### Polígono de frecuencias Para explorar variables continuas también podemos usar un polígono de frecuencias con `geom_frefreqpoly()`. Es más útil si lo usamos junto al `geom_histogram()`. ```r ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = COMPRAS_RISE)) + geom_histogram(binwidth = 50000, color = "black", fill = "chartreuse4") + geom_freqpoly(binwidth = 50000, linewidth = 1, color = "chocolate1") ``` ] .pull-right[ 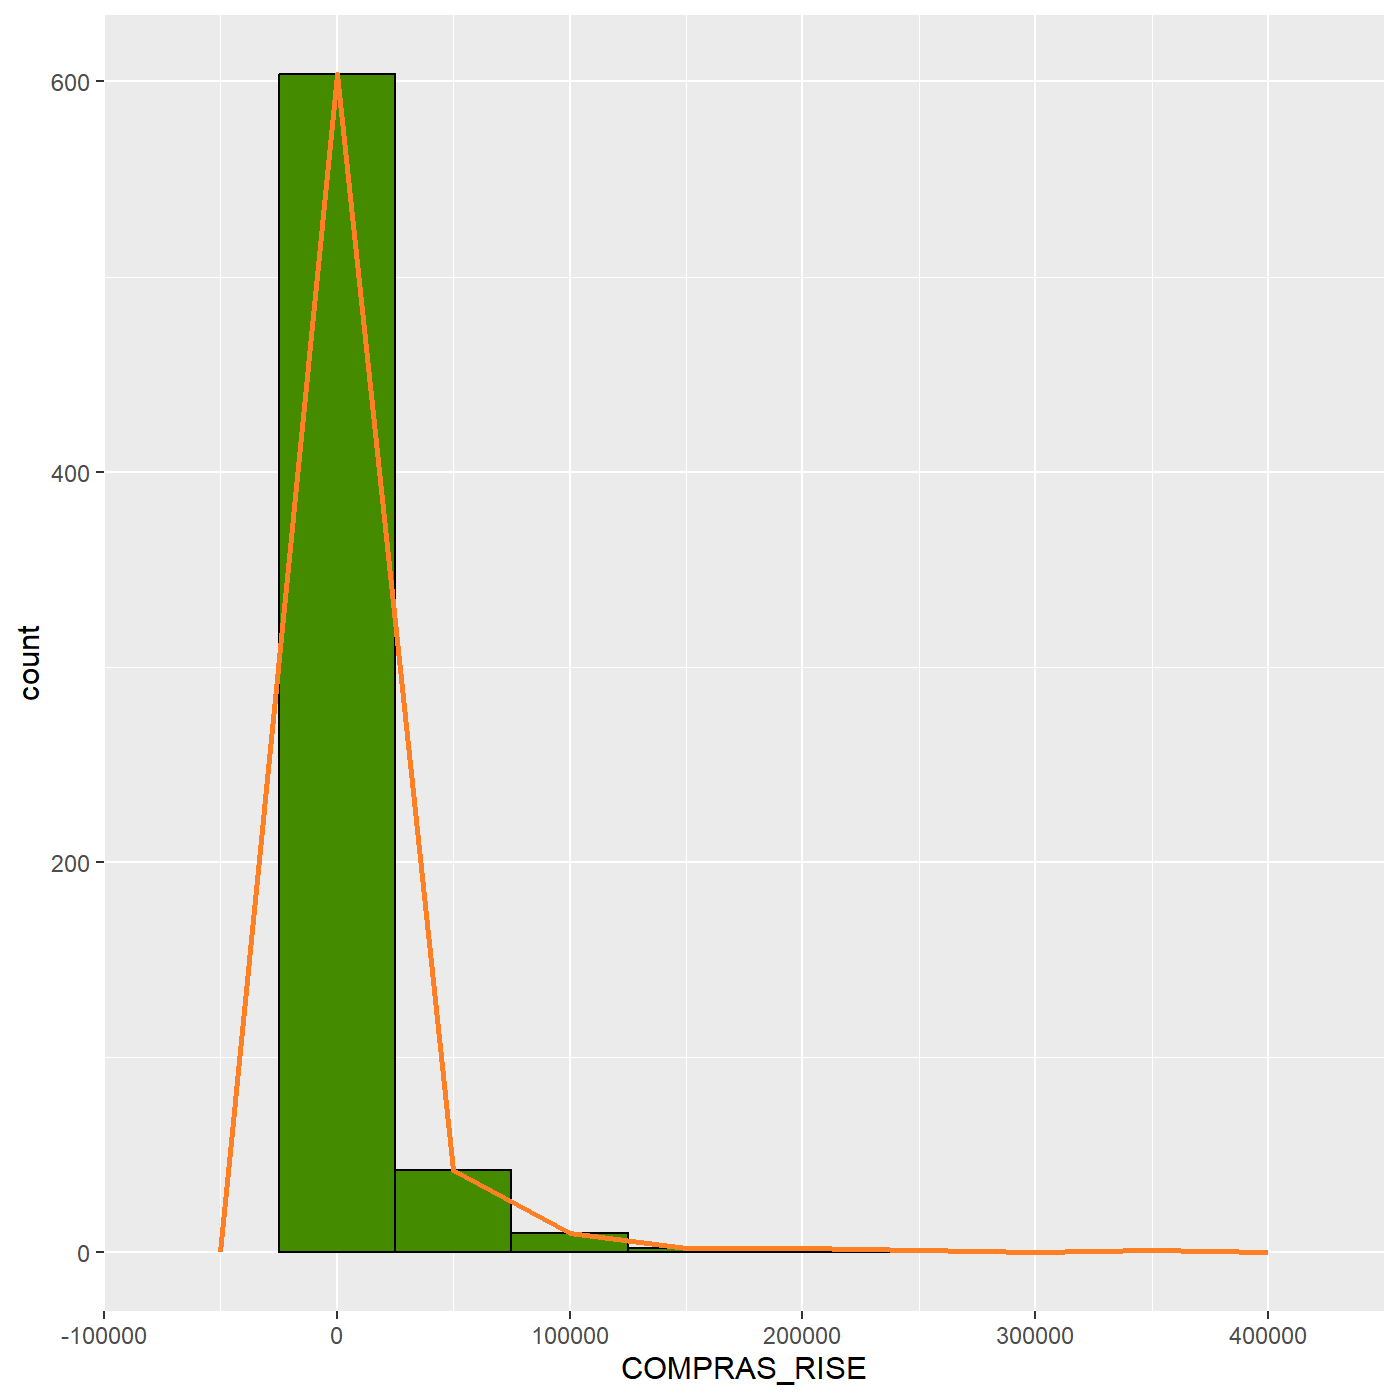<!-- --> ] --- ## Variables numéricas .pull-left[ ### Gráfico de texto Para explorar variables continuas también podemos usar un gráfico de texto con `geom_text()`. En este caso lo usaremos para ubicar las etiquetas a los gráficos anteriores junto al `geom_histogram()` y `geom_freqpoly()`. ```r ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = COMPRAS_RISE)) + geom_histogram(binwidth = 50000, color = "black", fill = "chartreuse4") + geom_freqpoly(binwidth = 50000, linewidth = 1, color = "chocolate1") + geom_text(stat = "bin", # para usar binwidth binwidth = 50000, aes(label=stat(round(count,2)), # etiquetas de los textos y=stat(count)), nudge_y = 30, # posición de etiquetas color = "grey50", size = 3) ``` ] .pull-right[ 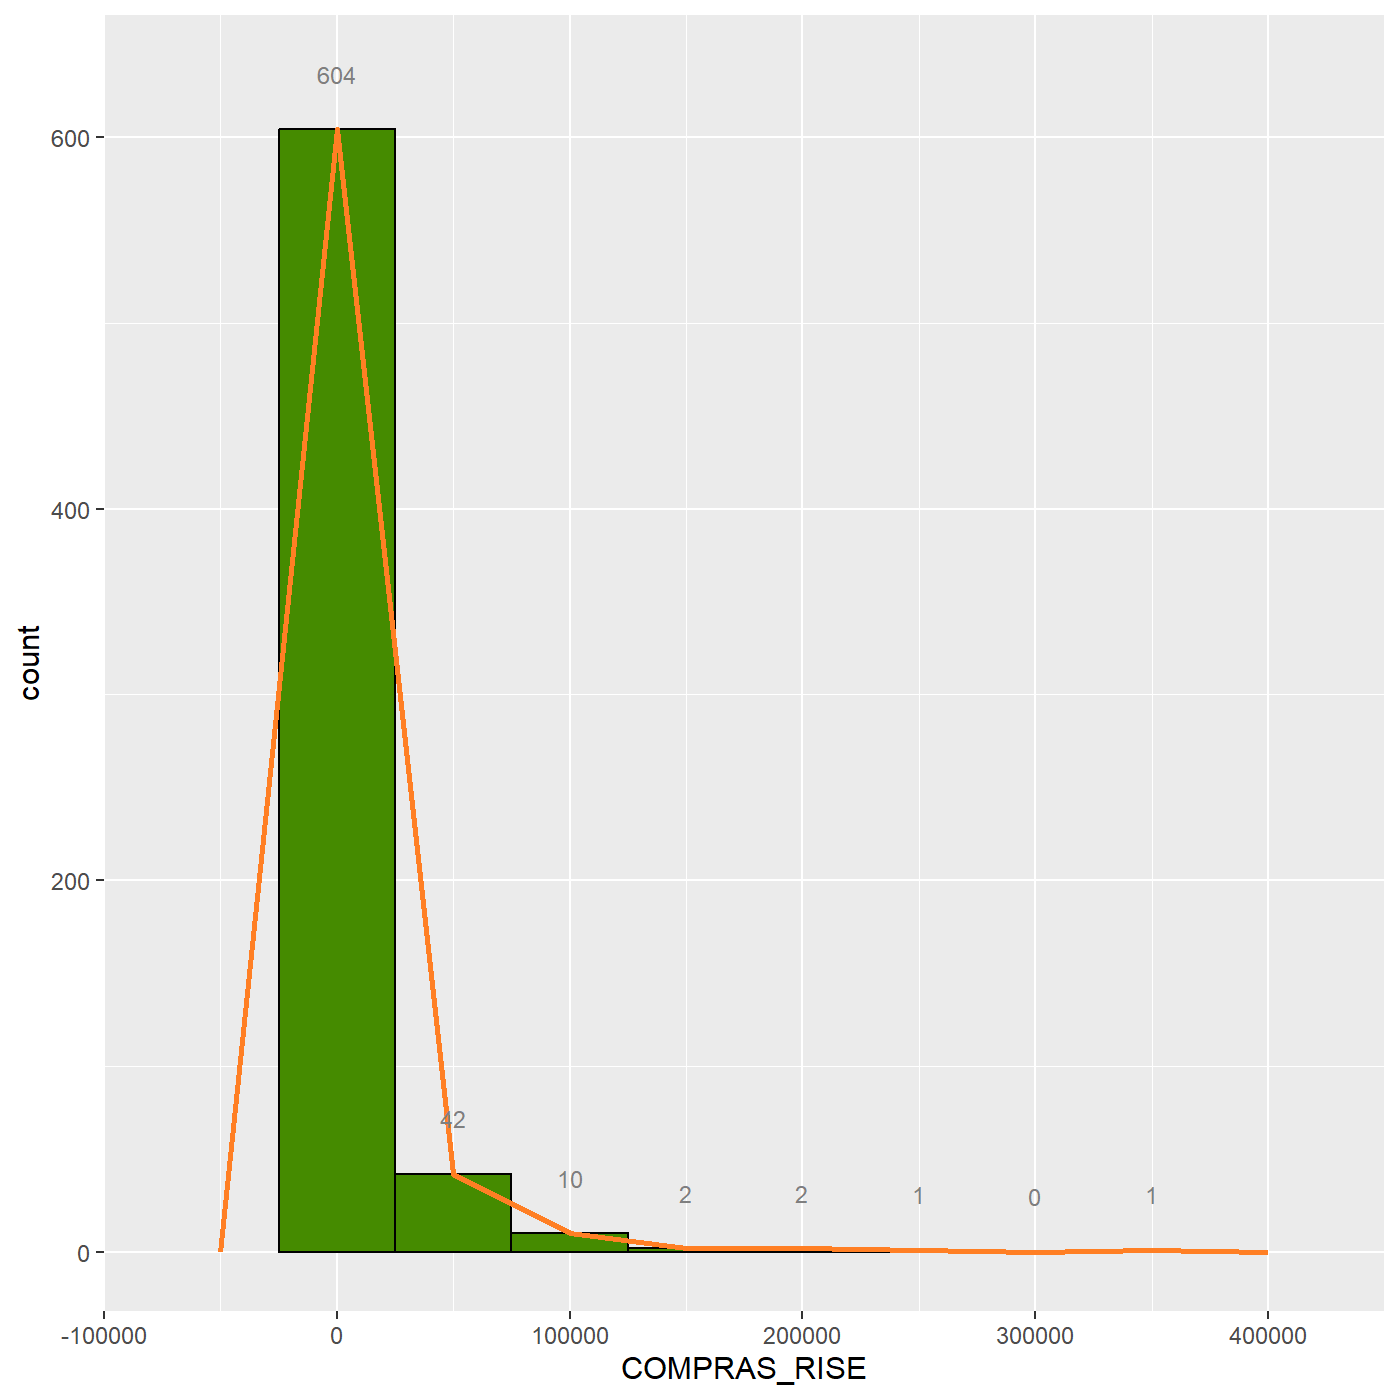<!-- --> ] --- ## Variables numéricas .pull-left[ ### Gráfico de cajas El gráfico de cajas permite conocer cómo se distribuyen los datos dentro de una variable. En R lo obtenemos con un `geom_boxplot()` y la información que se representa en el diagrama de cajas es la siguiente: - **Mediana.** Punto medio de los valores ordenados de menor a mayor o de mayor a menor representando el 50% de los datos. - **Cuartiles.** Dividen al conjunto de observaciones en 4 partes iguales. El `\(Q_1\)` representa el 25% de las observaciones y el `\(Q_3\)` representa el 75% de las observaciones. - **Rango Intercuartílico (RIC).** Es la diferencia entre el tercer y el primer cuartil. ] .pull-right[ <img src="img/boxplot.png" width="600px"/> ] --- ## Variables numéricas .pull-left[ ### Gráfico de cajas El gráfico de cajas permite visualizar los quartiles de nuestra variable: ```r ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = COMPRAS_RISE, y="")) + geom_boxplot(fill = "chocolate1") ``` ] .pull-right[ 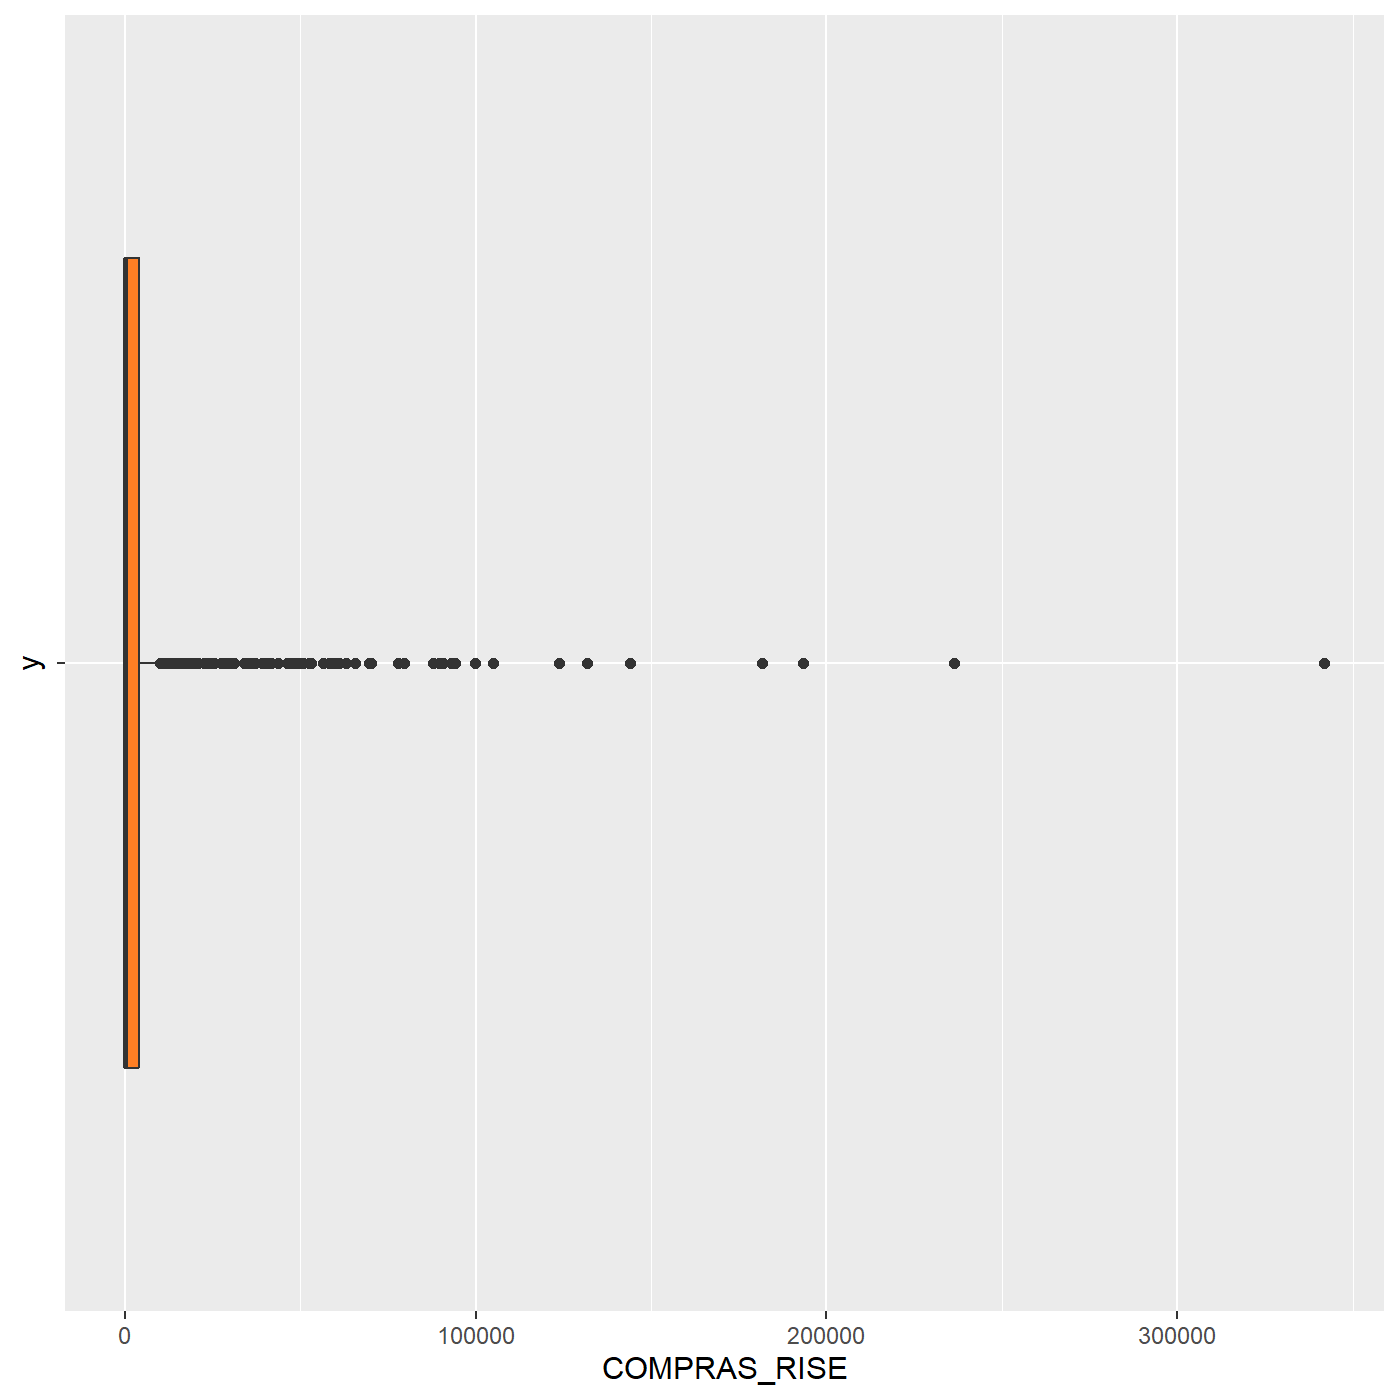<!-- --> ] --- ## Variables numéricas .pull-left[ ### Diagrama de violín A nuestro boxplot le podemos agregar capas como violín que grafica la concentración de las observaciones: ```r ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = COMPRAS_RISE, y="")) + geom_boxplot(fill = "chocolate1") + geom_violin(fill = "chartreuse4", alpha = 0.3, color = NA) ``` ] .pull-right[ 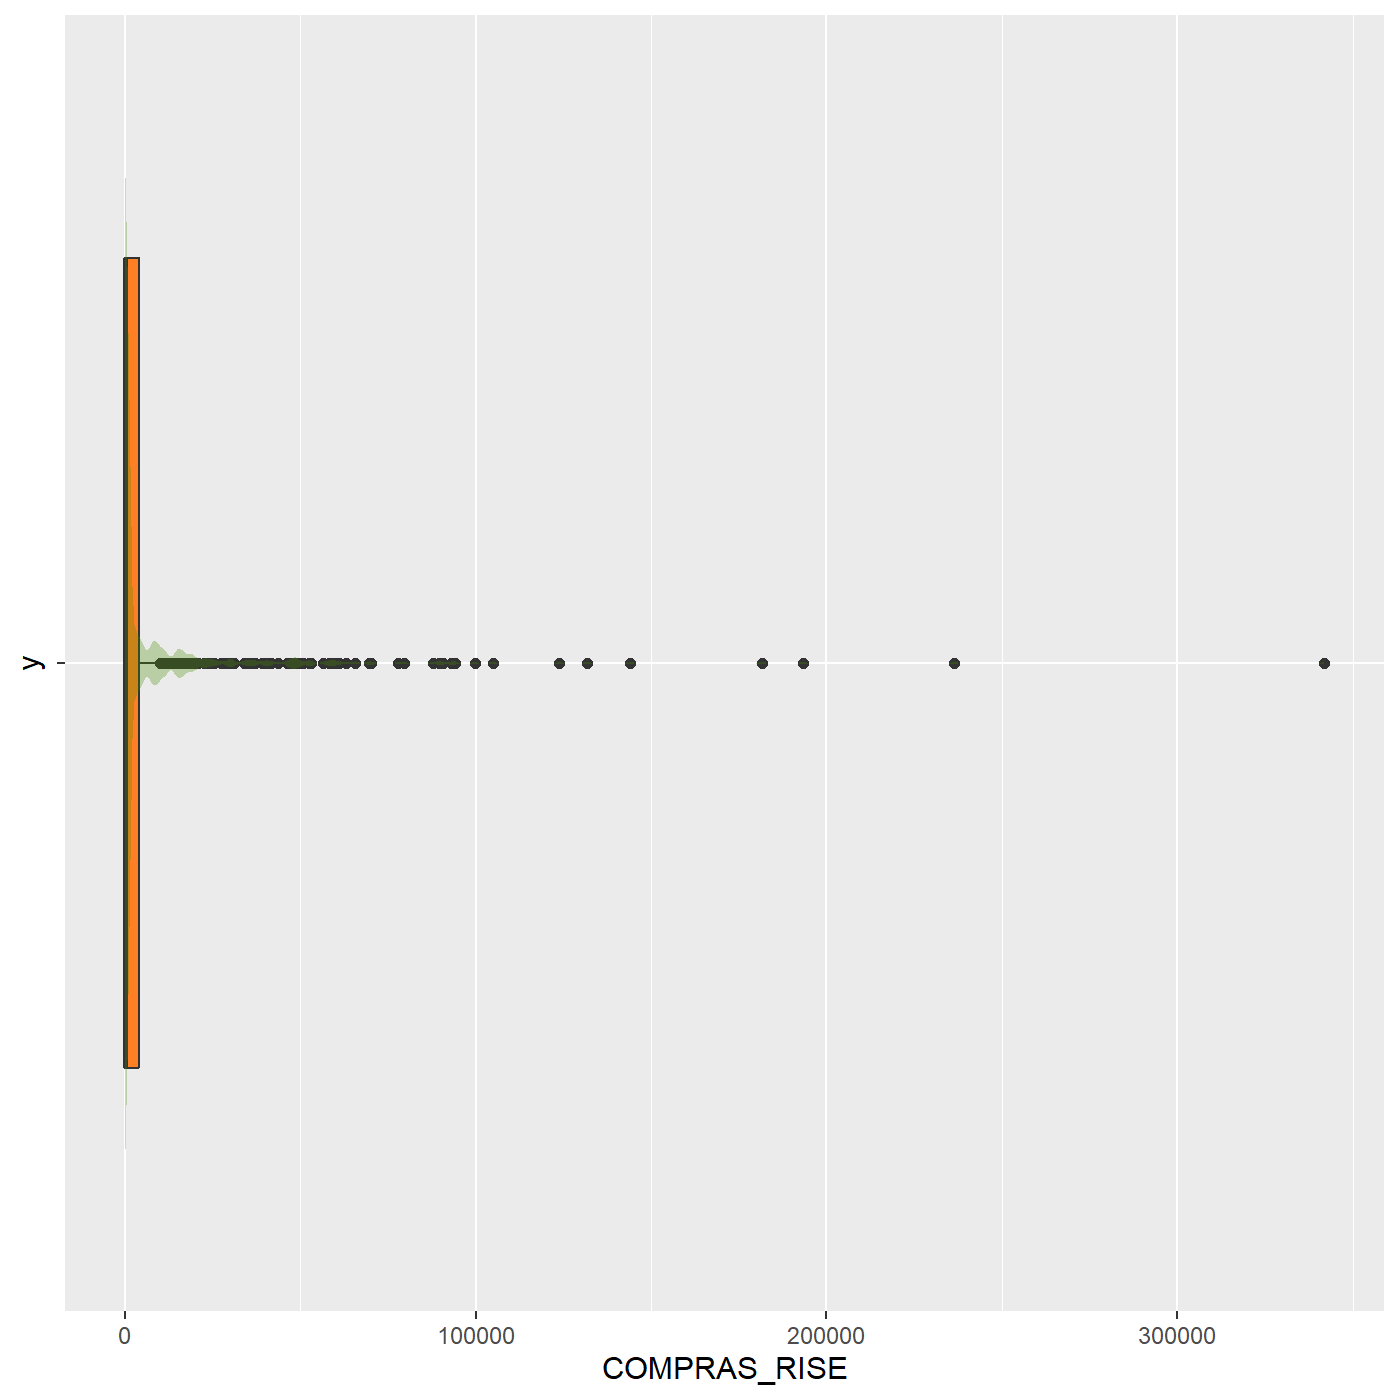<!-- --> ] --- ## Variables categóricas .pull-left[ ### Gráfico de barras ```r ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = CANTON)) + geom_bar() ``` ] .pull-right[ 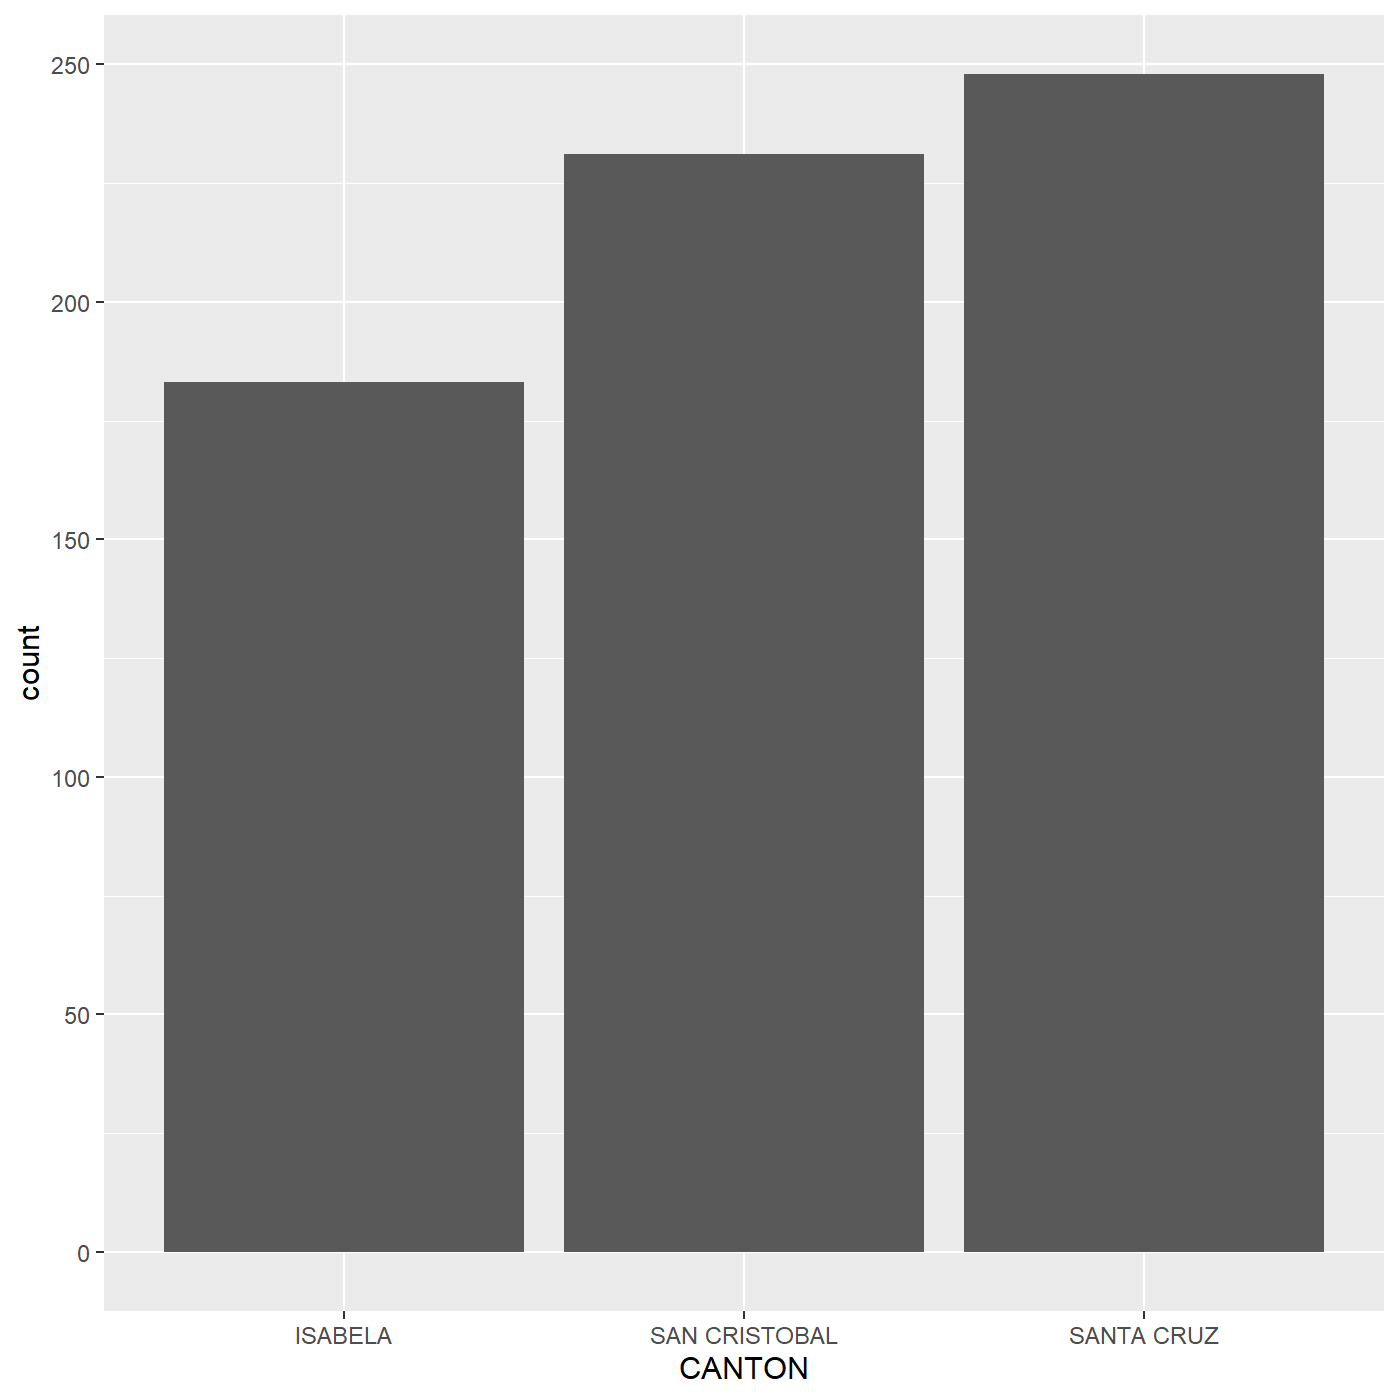<!-- --> ] --- ## Variables categóricas .pull-left[ ### Gráfico de barras apiladas ```r ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% group_by(CANTON) %>% summarise(Frec = n()) %>% arrange(-Frec) %>% mutate(Prop= round((Frec/ sum(Frec)),3), PosLab= cumsum(Prop) - 0.6*Prop) %>% ggplot(aes(x = "", y=Prop, fill = reorder(CANTON, Frec))) + geom_bar(stat = "identity", color="white") + geom_text(aes(y = PosLab, label = scales::percent(Prop)), color = "white", size = 6, nudge_x = 0.2) + scale_y_continuous(label= percent_format()) + labs(title = "Cantidad de transacciones globales por provincia", fill = "Provincia", x = "", y = "") + theme(text = element_text(colour = "grey45", size = 10), plot.title = element_text(face = "bold", size = 14, colour = "grey30"), plot.background = element_rect(fill = "grey92"), panel.grid.minor = element_blank(), panel.grid.major = element_blank(), axis.text.x = element_blank(), legend.position = "bottom", legend.background = element_blank(), legend.key = element_rect(fill = "grey92", color = "grey92")) ``` ] .pull-right[ 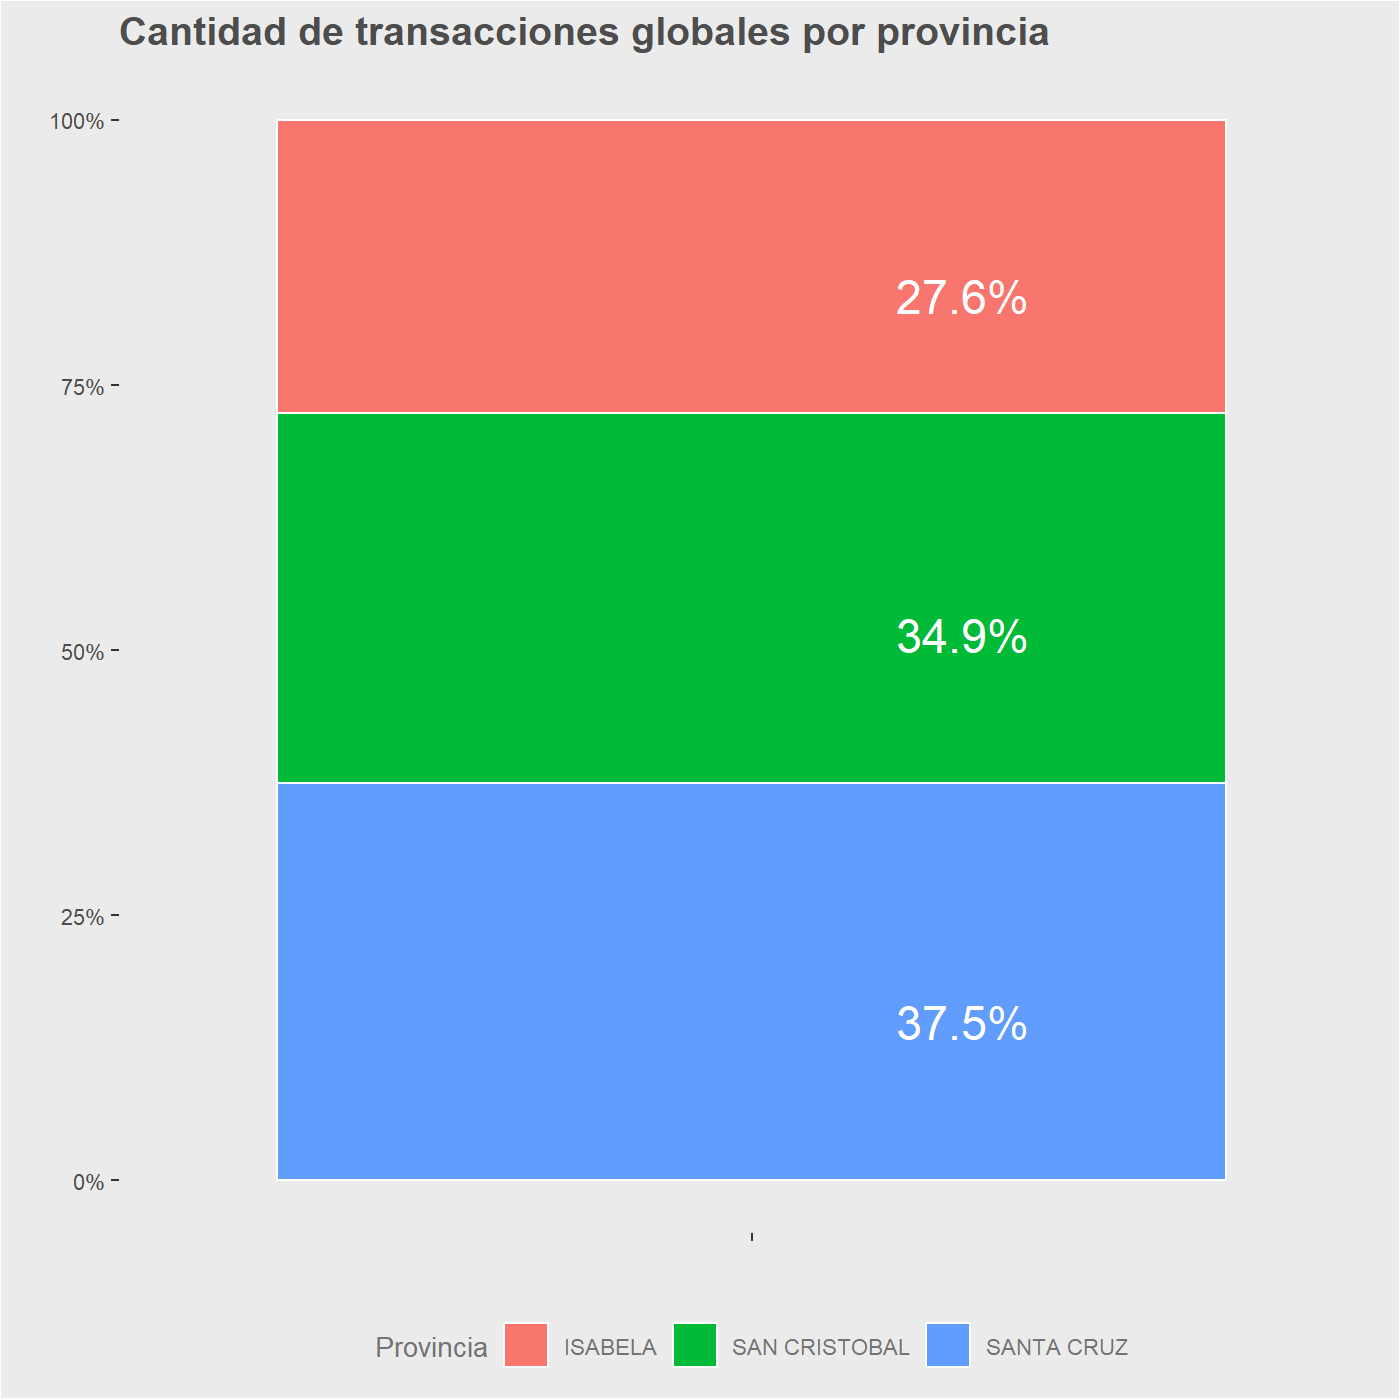<!-- --> ] --- ## Varias Variables numéricas .pull-left[ ### Gráfico de dispersión El gráfico de dispersión se usa para identificar la intensidad de la _relación entre dos variables numéricas_. El eje `\(x\)` representa la variable independiente, mientras que el eje `\(y\)` representa la variable dependiente. En R lo generamos con `geom_point()`. Si no existe una variable dependiente, cualquier variable se puede representar en cada eje y el diagrama de dispersión mostrará el **grado de correlación (no causalidad)** entre las dos variables. Un diagrama de dispersión puede sugerir varios tipos de **correlaciones** entre las variables con un intervalo de confianza determinado (Ver siguiente página). Con `geom_smooth()` se puede dibujar una línea de ajuste (llamada también "línea de tendencia") con el fin de estudiar la correlación entre las variables. ] .pull-right[ <img src="img/dispersion.png" width="600px"/> ] --- ## Varias Variables numéricas .pull-left[ ### Gráfico de dispersión Cuando hay mucha superposición de los puntos es mejor agregar transparencia a los datos: ```r # transaparencia de puntos con alpha ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = TOTAL_VENTAS, y = TOTAL_COMPRAS)) + geom_point(alpha = 0.2) ``` ] .pull-right[ 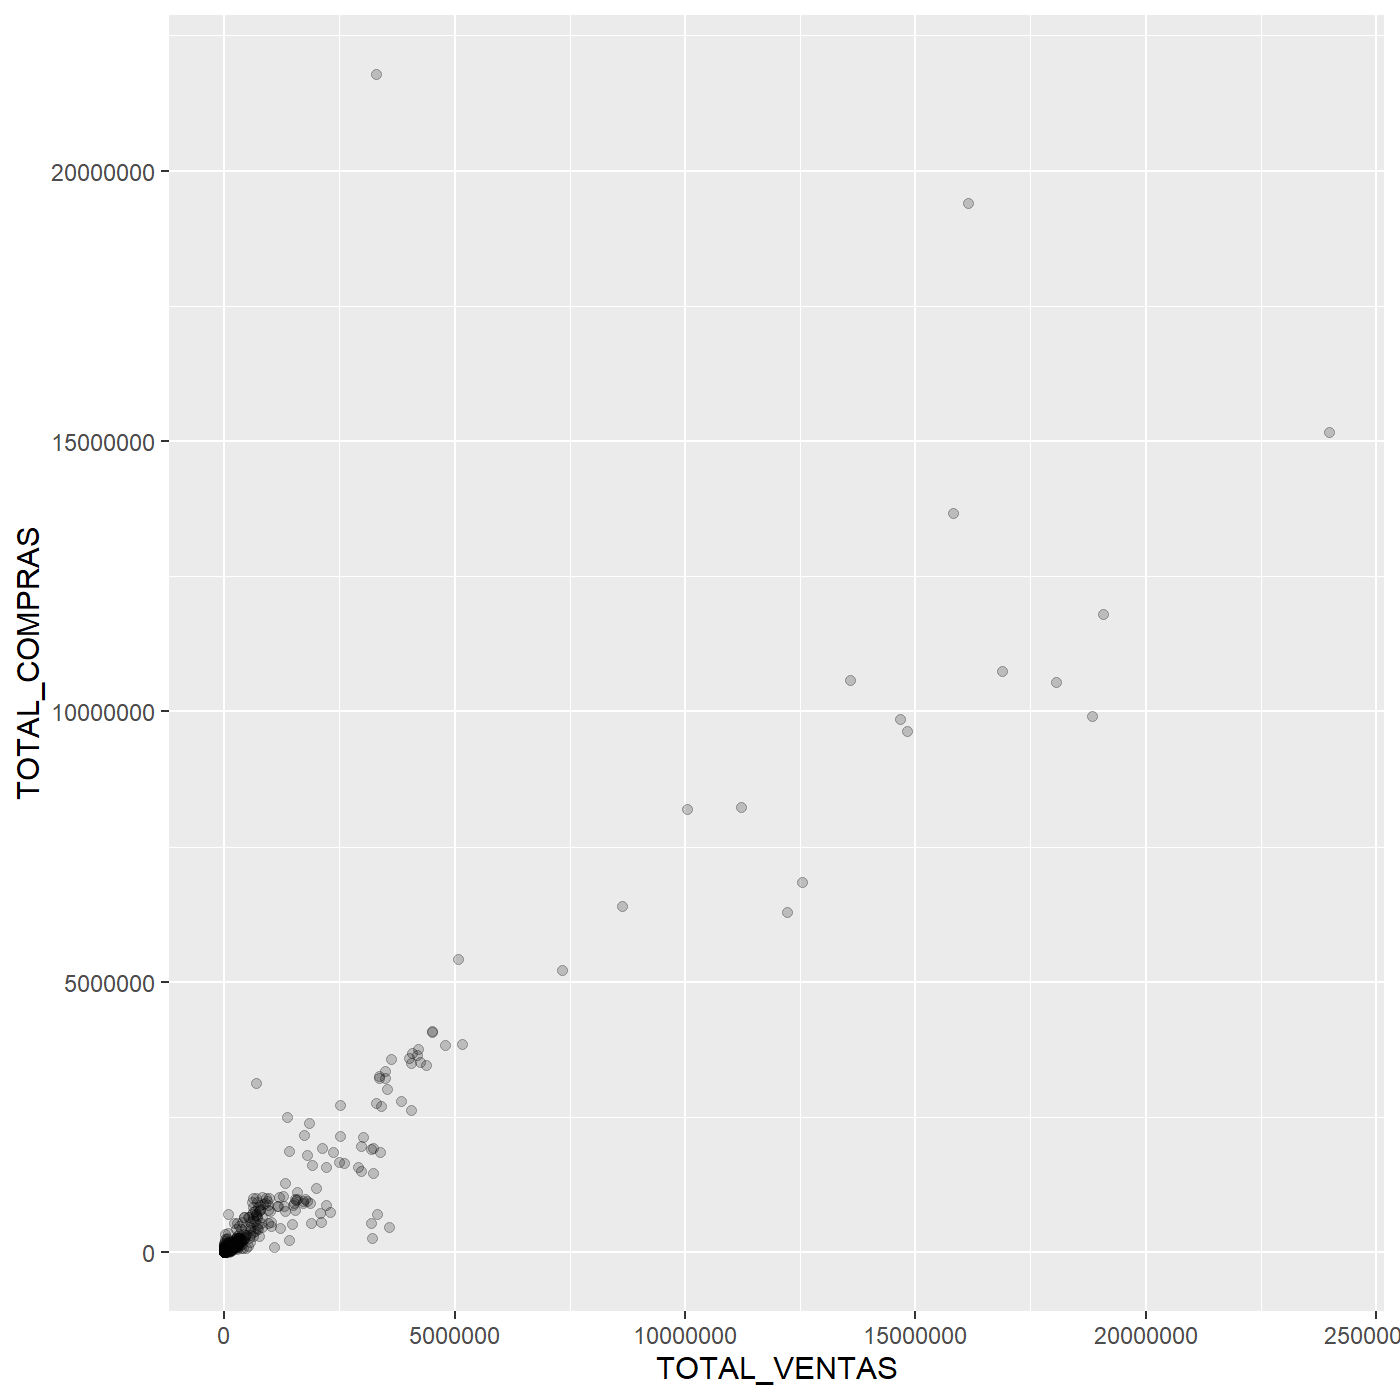<!-- --> ] --- ## Varias Variables numéricas .pull-left[ ### Gráfico smooth Este gráfico `geom_smooth()` agrega una línea de tendencia sobre una gráfica existente: ```r # agregamos una línea de suavizado para ver la tendencia ventas %>% filter(PROVINCIA == "GALAPAGOS") %>% ggplot(aes(x = TOTAL_VENTAS, y = TOTAL_COMPRAS)) + geom_point(alpha = 0.2) + geom_smooth() ``` ] .pull-right[ 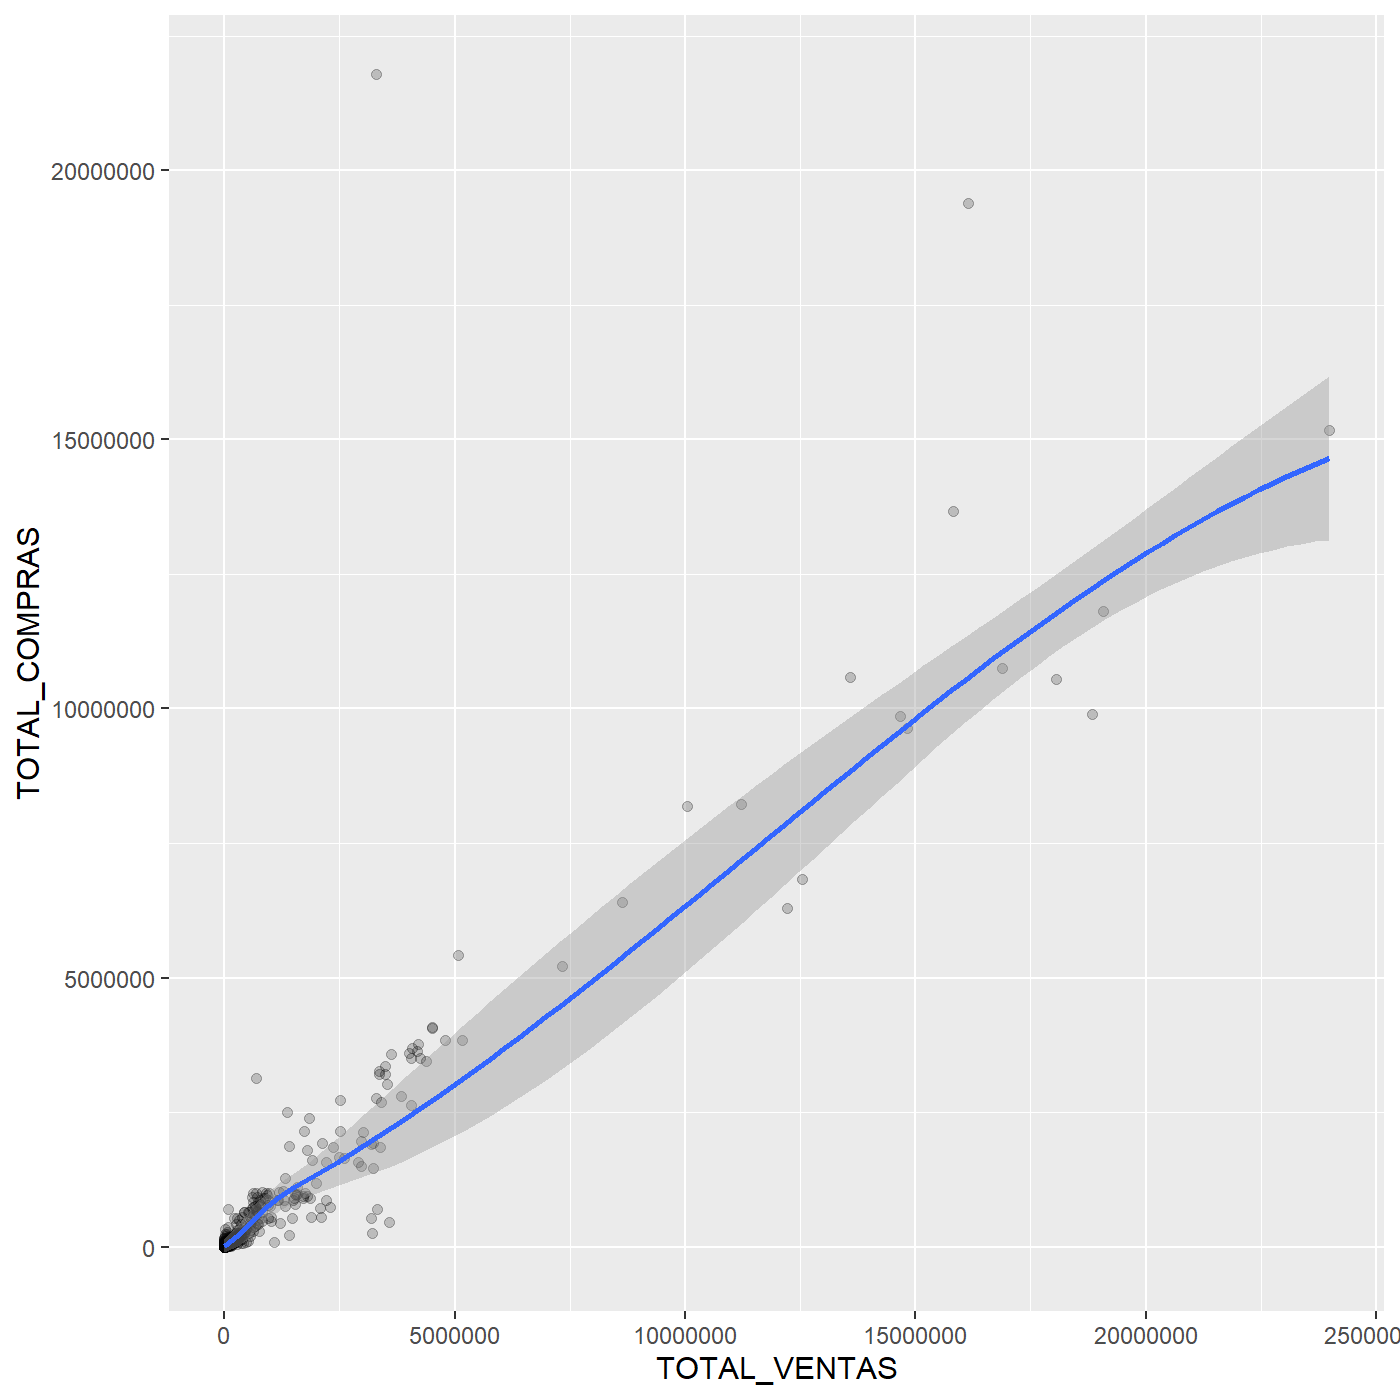<!-- --> ] --- ## Variables numéricas con una categórica .pull-left[ ### Gráfico de densidad Un gráfico de densidad visualiza la distribución de datos cuantitativos en un intervalo o período de tiempo continuo. Este gráfico es una variación de un histograma que usa suavizado de kernel para trazar valores, lo que permite distribuciones más suaves suavizando el ruido. En R lo generamos con `geom_density()`: ```r ## gráfico de densidad con transparencia ventas %>% filter(PROVINCIA == "GALAPAGOS" & TOTAL_VENTAS < 1000000) %>% ggplot(aes(x = TOTAL_VENTAS, fill = CANTON)) + geom_density(alpha = 0.4) + labs(x = "Total de Ventas (USD)", y = "Densidad", title = "Total de Ventas - Densidad", fill = "Canton") ``` ] .pull-right[ 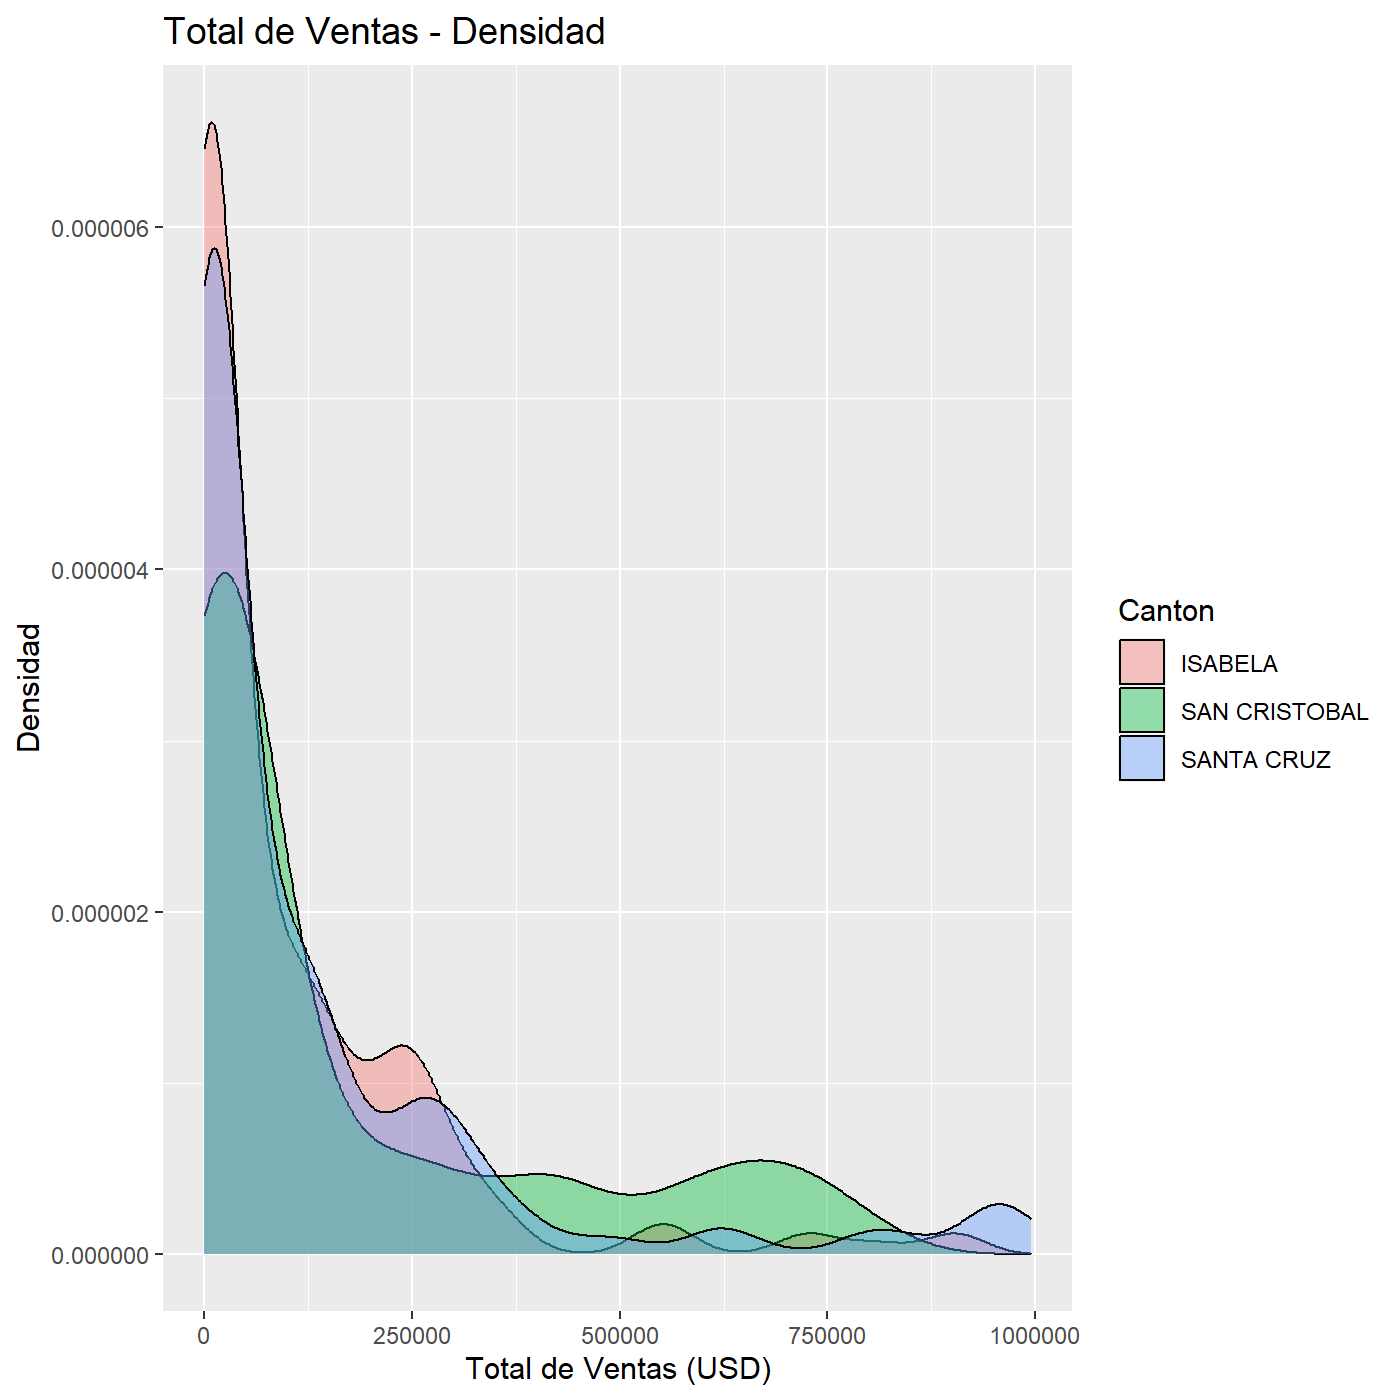<!-- --> ] --- ## Variables numéricas con una categórica .pull-left[ ### Gráfico de líneas verticales Podemos agregar estadísticos al gráfico de densidad mediante un gráfico de líneas verticales con `geom_vline()`: ```r ## calculando estadísticos para el gráfico ventas_medias <- ventas %>% filter(PROVINCIA == "GALAPAGOS" & TOTAL_VENTAS < 1000000) %>% group_by(CANTON) %>% summarise(MEDIA = mean(TOTAL_VENTAS, na.rm= TRUE)) ## agregamos geom_vline() ventas %>% filter(PROVINCIA == "GALAPAGOS" & TOTAL_VENTAS < 1000000) %>% ggplot(aes(x = TOTAL_VENTAS, fill = CANTON)) + geom_density(alpha = 0.4) + geom_vline(data = ventas_medias, aes(xintercept = MEDIA, colour= CANTON), linetype= "dashed", size= 1) + labs(x = "Total de Ventas (USD)", y = "Densidad", title = "Total de Ventas - Densidad", fill = "Canton") ``` ] .pull-right[ 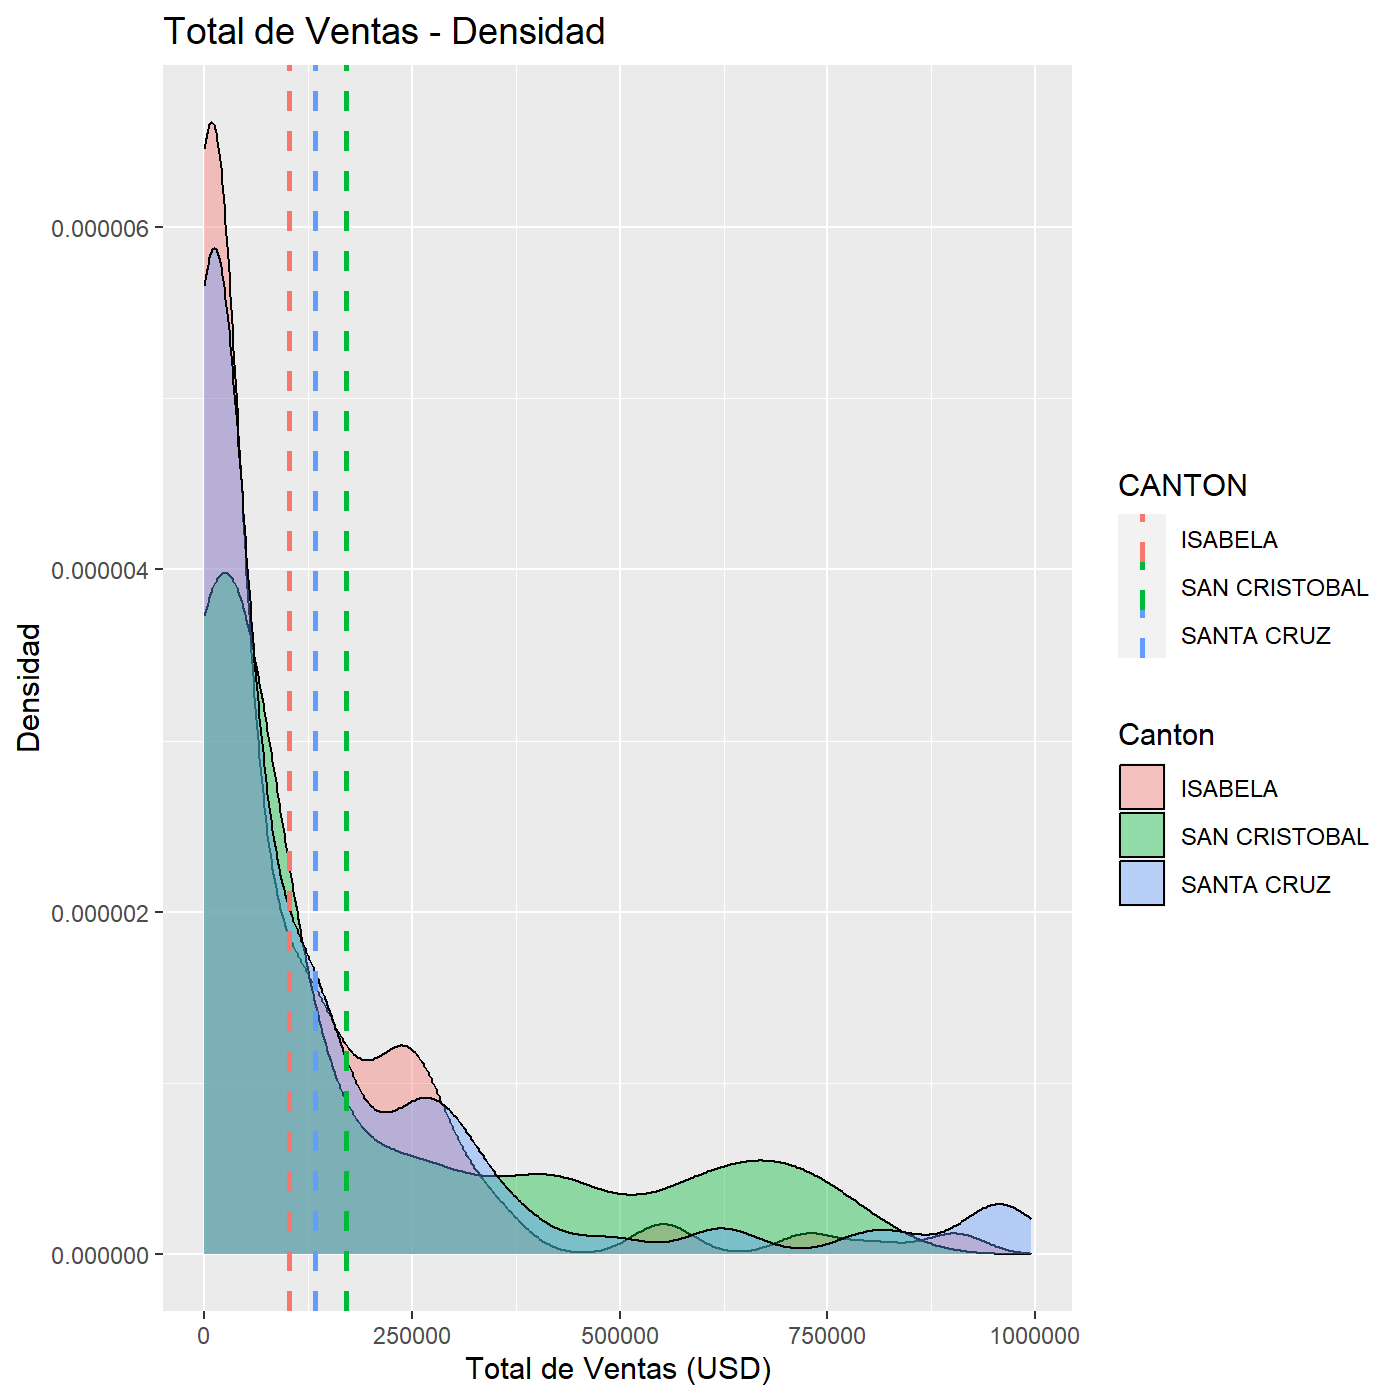<!-- --> ] --- ## Variables numéricas con una categórica .pull-left[ ### Gráfico de texto Podemos agregar estadísticos al gráfico de densidad y de líneas verticales con `geom_text()`: ```r ## incluir los valores de medias en texto con geom_text() ventas %>% filter(PROVINCIA == "GALAPAGOS" & TOTAL_VENTAS < 1000000) %>% ggplot(aes(x = TOTAL_VENTAS, fill = CANTON)) + geom_density(alpha = 0.4) + geom_vline(data = ventas_medias, aes(xintercept = MEDIA, colour= CANTON), linetype= "dashed", size= 1) + geom_text(data = ventas_medias, aes(x=MEDIA-10000, label= paste("Media: USD ", round(MEDIA,2)), y=0.000005, colour= CANTON), angle=90, size = 3) + labs(x = "Total de Ventas (USD)", y = "Densidad", title = "Total de Ventas - Densidad", fill = "Canton") ``` ] .pull-right[ 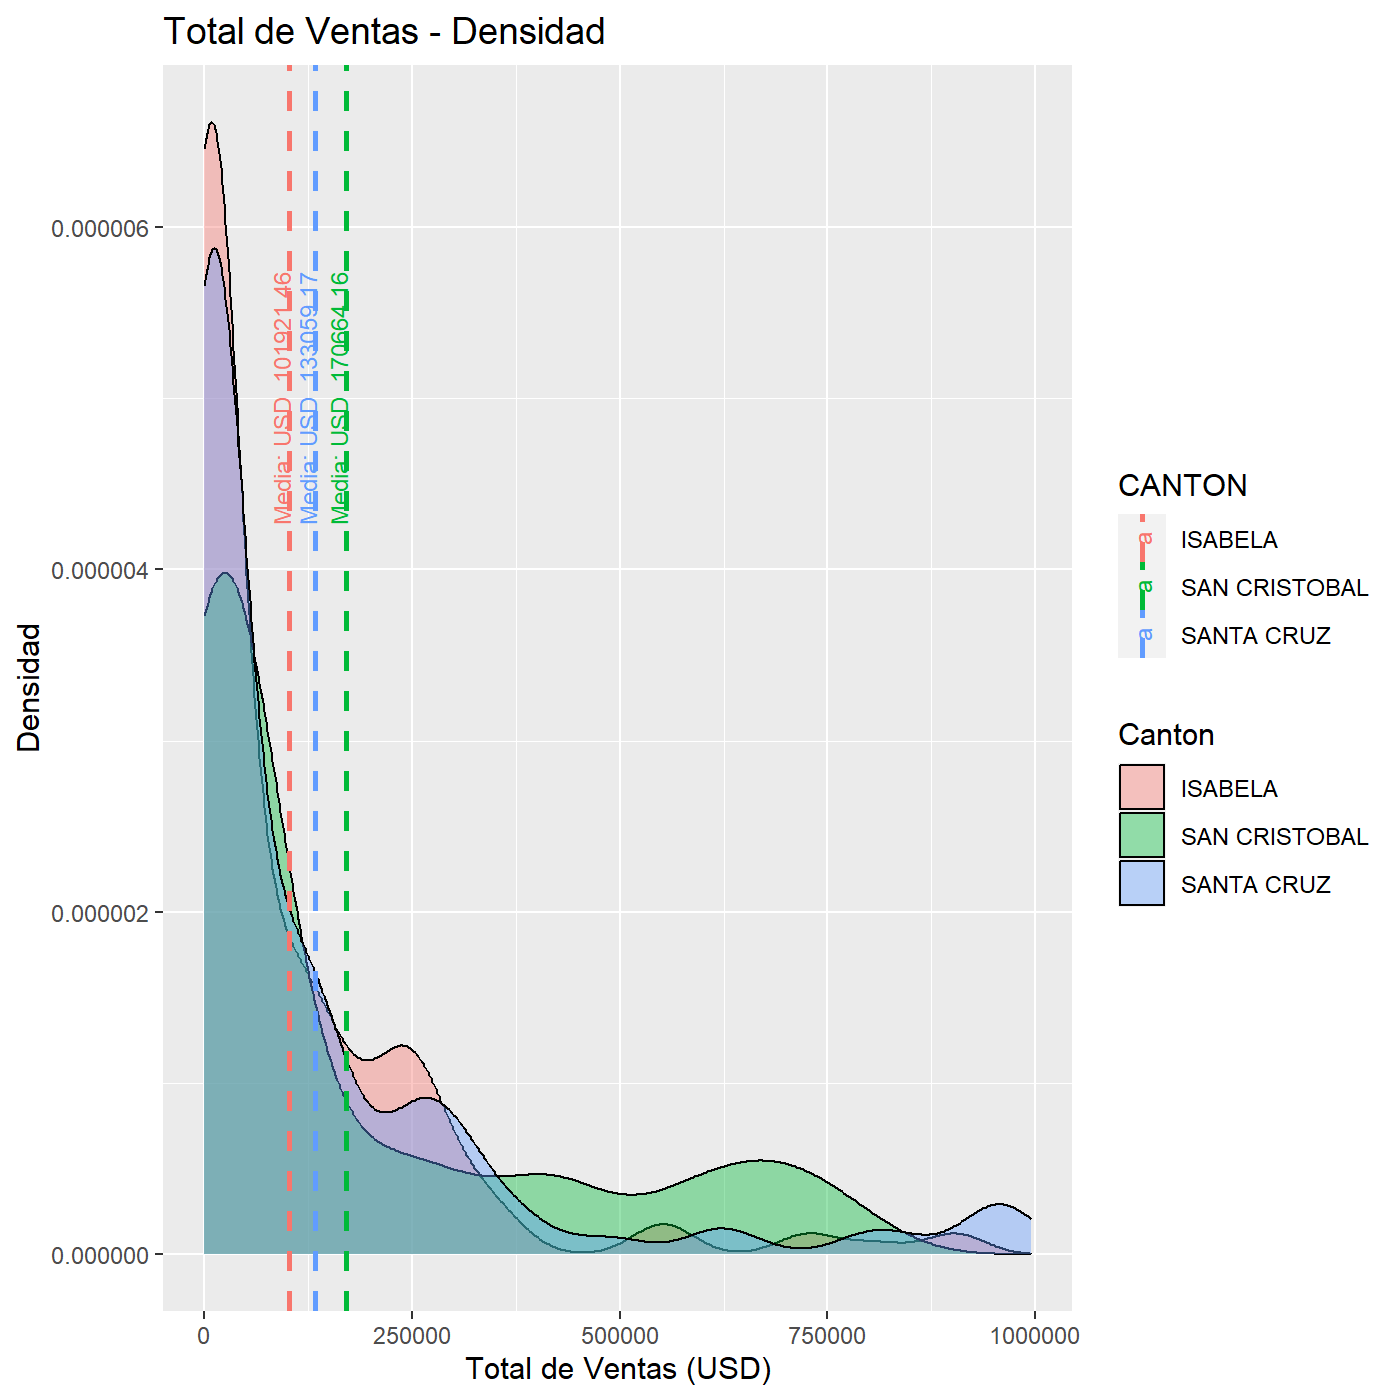<!-- --> ] --- class: middle, center, inverse <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:3em;width:3em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M24 32C37.25 32 48 42.75 48 56V408C48 421.3 58.75 432 72 432H488C501.3 432 512 442.7 512 456C512 469.3 501.3 480 488 480H72C32.24 480 0 447.8 0 408V56C0 42.75 10.75 32 24 32zM128 136C128 122.7 138.7 112 152 112H360C373.3 112 384 122.7 384 136C384 149.3 373.3 160 360 160H152C138.7 160 128 149.3 128 136zM296 208C309.3 208 320 218.7 320 232C320 245.3 309.3 256 296 256H152C138.7 256 128 245.3 128 232C128 218.7 138.7 208 152 208H296zM424 304C437.3 304 448 314.7 448 328C448 341.3 437.3 352 424 352H152C138.7 352 128 341.3 128 328C128 314.7 138.7 304 152 304H424z"/></svg> # Gráficos dinámicos con `plotly` --- ## Gráficos html .pull-left[ Web oficial: [https://plotly.com/r/](https://plotly.com/r/) ```r library(plotly) ## gráfico dinámico de un gráfico de densidad g1 <- ventas %>% filter(PROVINCIA == "GALAPAGOS" & TOTAL_VENTAS < 1000000) %>% ggplot(aes(x = TOTAL_VENTAS, fill = CANTON)) + geom_density(alpha = 0.4) + labs(x = "Total de Ventas (USD)", y = "Densidad", title = "Total de Ventas - Densidad", fill = "Canton") ggplotly(g1) ``` ] .pull-right[ <div id="htmlwidget-dda9b88d2ef7779142ed" style="width:500px;height:540px;" class="plotly html-widget"></div> <script type="application/json" data-for="htmlwidget-dda9b88d2ef7779142ed">{"x":{"data":[{"x":[0,1947.16,3894.32,5841.48,7788.64,9735.8,11682.96,13630.12,15577.28,17524.44,19471.6,21418.76,23365.92,25313.08,27260.24,29207.4,31154.56,33101.72,35048.88,36996.04,38943.2,40890.36,42837.52,44784.68,46731.84,48679,50626.16,52573.32,54520.48,56467.64,58414.8,60361.96,62309.12,64256.28,66203.44,68150.6,70097.76,72044.92,73992.08,75939.24,77886.4,79833.56,81780.72,83727.88,85675.04,87622.2,89569.36,91516.52,93463.68,95410.84,97358,99305.16,101252.32,103199.48,105146.64,107093.8,109040.96,110988.12,112935.28,114882.44,116829.6,118776.76,120723.92,122671.08,124618.24,126565.4,128512.56,130459.72,132406.88,134354.04,136301.2,138248.36,140195.52,142142.68,144089.84,146037,147984.16,149931.32,151878.48,153825.64,155772.8,157719.96,159667.12,161614.28,163561.44,165508.6,167455.76,169402.92,171350.08,173297.24,175244.4,177191.56,179138.72,181085.88,183033.04,184980.2,186927.36,188874.52,190821.68,192768.84,194716,196663.16,198610.32,200557.48,202504.64,204451.8,206398.96,208346.12,210293.28,212240.44,214187.6,216134.76,218081.92,220029.08,221976.24,223923.4,225870.56,227817.72,229764.88,231712.04,233659.2,235606.36,237553.52,239500.68,241447.84,243395,245342.16,247289.32,249236.48,251183.64,253130.8,255077.96,257025.12,258972.28,260919.44,262866.6,264813.76,266760.92,268708.08,270655.24,272602.4,274549.56,276496.72,278443.88,280391.04,282338.2,284285.36,286232.52,288179.68,290126.84,292074,294021.16,295968.32,297915.48,299862.64,301809.8,303756.96,305704.12,307651.28,309598.44,311545.6,313492.76,315439.92,317387.08,319334.24,321281.4,323228.56,325175.72,327122.88,329070.04,331017.2,332964.36,334911.52,336858.68,338805.84,340753,342700.16,344647.32,346594.48,348541.64,350488.8,352435.96,354383.12,356330.28,358277.44,360224.6,362171.76,364118.92,366066.08,368013.24,369960.4,371907.56,373854.72,375801.88,377749.04,379696.2,381643.36,383590.52,385537.68,387484.84,389432,391379.16,393326.32,395273.48,397220.64,399167.8,401114.96,403062.12,405009.28,406956.44,408903.6,410850.76,412797.92,414745.08,416692.24,418639.4,420586.56,422533.72,424480.88,426428.04,428375.2,430322.36,432269.52,434216.68,436163.84,438111,440058.16,442005.32,443952.48,445899.64,447846.8,449793.96,451741.12,453688.28,455635.44,457582.6,459529.76,461476.92,463424.08,465371.24,467318.4,469265.56,471212.72,473159.88,475107.04,477054.2,479001.36,480948.52,482895.68,484842.84,486790,488737.16,490684.32,492631.48,494578.64,496525.8,498472.96,500420.12,502367.28,504314.44,506261.6,508208.76,510155.92,512103.08,514050.24,515997.4,517944.56,519891.72,521838.88,523786.04,525733.2,527680.36,529627.52,531574.68,533521.84,535469,537416.16,539363.32,541310.48,543257.64,545204.8,547151.96,549099.12,551046.28,552993.44,554940.6,556887.76,558834.92,560782.08,562729.24,564676.4,566623.56,568570.72,570517.88,572465.04,574412.2,576359.36,578306.52,580253.68,582200.84,584148,586095.16,588042.32,589989.48,591936.64,593883.8,595830.96,597778.12,599725.28,601672.44,603619.6,605566.76,607513.92,609461.08,611408.24,613355.4,615302.56,617249.72,619196.88,621144.04,623091.2,625038.36,626985.52,628932.68,630879.84,632827,634774.16,636721.32,638668.48,640615.64,642562.8,644509.96,646457.12,648404.28,650351.44,652298.6,654245.76,656192.92,658140.08,660087.24,662034.4,663981.56,665928.72,667875.88,669823.04,671770.2,673717.36,675664.52,677611.68,679558.84,681506,683453.16,685400.32,687347.48,689294.64,691241.8,693188.96,695136.12,697083.28,699030.44,700977.6,702924.76,704871.92,706819.08,708766.24,710713.4,712660.56,714607.72,716554.88,718502.04,720449.2,722396.36,724343.52,726290.68,728237.84,730185,732132.16,734079.32,736026.48,737973.64,739920.8,741867.96,743815.12,745762.28,747709.44,749656.6,751603.76,753550.92,755498.08,757445.24,759392.4,761339.56,763286.72,765233.88,767181.04,769128.2,771075.36,773022.52,774969.68,776916.84,778864,780811.16,782758.32,784705.48,786652.64,788599.8,790546.96,792494.12,794441.28,796388.44,798335.6,800282.76,802229.92,804177.08,806124.24,808071.4,810018.56,811965.72,813912.88,815860.04,817807.2,819754.36,821701.52,823648.68,825595.84,827543,829490.16,831437.32,833384.48,835331.64,837278.8,839225.96,841173.12,843120.28,845067.44,847014.6,848961.76,850908.92,852856.08,854803.24,856750.4,858697.56,860644.72,862591.88,864539.04,866486.2,868433.36,870380.52,872327.68,874274.84,876222,878169.16,880116.32,882063.48,884010.64,885957.8,887904.96,889852.12,891799.28,893746.44,895693.6,897640.76,899587.92,901535.08,903482.24,905429.4,907376.56,909323.72,911270.88,913218.04,915165.2,917112.36,919059.52,921006.68,922953.84,924901,926848.16,928795.32,930742.48,932689.64,934636.8,936583.96,938531.12,940478.28,942425.44,944372.6,946319.76,948266.92,950214.08,952161.24,954108.4,956055.56,958002.72,959949.88,961897.04,963844.2,965791.36,967738.52,969685.68,971632.84,973580,975527.16,977474.32,979421.48,981368.64,983315.8,985262.96,987210.12,989157.28,991104.44,993051.6,994998.76,994998.76,993051.6,991104.44,989157.28,987210.12,985262.96,983315.8,981368.64,979421.48,977474.32,975527.16,973580,971632.84,969685.68,967738.52,965791.36,963844.2,961897.04,959949.88,958002.72,956055.56,954108.4,952161.24,950214.08,948266.92,946319.76,944372.6,942425.44,940478.28,938531.12,936583.96,934636.8,932689.64,930742.48,928795.32,926848.16,924901,922953.84,921006.68,919059.52,917112.36,915165.2,913218.04,911270.88,909323.72,907376.56,905429.4,903482.24,901535.08,899587.92,897640.76,895693.6,893746.44,891799.28,889852.12,887904.96,885957.8,884010.64,882063.48,880116.32,878169.16,876222,874274.84,872327.68,870380.52,868433.36,866486.2,864539.04,862591.88,860644.72,858697.56,856750.4,854803.24,852856.08,850908.92,848961.76,847014.6,845067.44,843120.28,841173.12,839225.96,837278.8,835331.64,833384.48,831437.32,829490.16,827543,825595.84,823648.68,821701.52,819754.36,817807.2,815860.04,813912.88,811965.72,810018.56,808071.4,806124.24,804177.08,802229.92,800282.76,798335.6,796388.44,794441.28,792494.12,790546.96,788599.8,786652.64,784705.48,782758.32,780811.16,778864,776916.84,774969.68,773022.52,771075.36,769128.2,767181.04,765233.88,763286.72,761339.56,759392.4,757445.24,755498.08,753550.92,751603.76,749656.6,747709.44,745762.28,743815.12,741867.96,739920.8,737973.64,736026.48,734079.32,732132.16,730185,728237.84,726290.68,724343.52,722396.36,720449.2,718502.04,716554.88,714607.72,712660.56,710713.4,708766.24,706819.08,704871.92,702924.76,700977.6,699030.44,697083.28,695136.12,693188.96,691241.8,689294.64,687347.48,685400.32,683453.16,681506,679558.84,677611.68,675664.52,673717.36,671770.2,669823.04,667875.88,665928.72,663981.56,662034.4,660087.24,658140.08,656192.92,654245.76,652298.6,650351.44,648404.28,646457.12,644509.96,642562.8,640615.64,638668.48,636721.32,634774.16,632827,630879.84,628932.68,626985.52,625038.36,623091.2,621144.04,619196.88,617249.72,615302.56,613355.4,611408.24,609461.08,607513.92,605566.76,603619.6,601672.44,599725.28,597778.12,595830.96,593883.8,591936.64,589989.48,588042.32,586095.16,584148,582200.84,580253.68,578306.52,576359.36,574412.2,572465.04,570517.88,568570.72,566623.56,564676.4,562729.24,560782.08,558834.92,556887.76,554940.6,552993.44,551046.28,549099.12,547151.96,545204.8,543257.64,541310.48,539363.32,537416.16,535469,533521.84,531574.68,529627.52,527680.36,525733.2,523786.04,521838.88,519891.72,517944.56,515997.4,514050.24,512103.08,510155.92,508208.76,506261.6,504314.44,502367.28,500420.12,498472.96,496525.8,494578.64,492631.48,490684.32,488737.16,486790,484842.84,482895.68,480948.52,479001.36,477054.2,475107.04,473159.88,471212.72,469265.56,467318.4,465371.24,463424.08,461476.92,459529.76,457582.6,455635.44,453688.28,451741.12,449793.96,447846.8,445899.64,443952.48,442005.32,440058.16,438111,436163.84,434216.68,432269.52,430322.36,428375.2,426428.04,424480.88,422533.72,420586.56,418639.4,416692.24,414745.08,412797.92,410850.76,408903.6,406956.44,405009.28,403062.12,401114.96,399167.8,397220.64,395273.48,393326.32,391379.16,389432,387484.84,385537.68,383590.52,381643.36,379696.2,377749.04,375801.88,373854.72,371907.56,369960.4,368013.24,366066.08,364118.92,362171.76,360224.6,358277.44,356330.28,354383.12,352435.96,350488.8,348541.64,346594.48,344647.32,342700.16,340753,338805.84,336858.68,334911.52,332964.36,331017.2,329070.04,327122.88,325175.72,323228.56,321281.4,319334.24,317387.08,315439.92,313492.76,311545.6,309598.44,307651.28,305704.12,303756.96,301809.8,299862.64,297915.48,295968.32,294021.16,292074,290126.84,288179.68,286232.52,284285.36,282338.2,280391.04,278443.88,276496.72,274549.56,272602.4,270655.24,268708.08,266760.92,264813.76,262866.6,260919.44,258972.28,257025.12,255077.96,253130.8,251183.64,249236.48,247289.32,245342.16,243395,241447.84,239500.68,237553.52,235606.36,233659.2,231712.04,229764.88,227817.72,225870.56,223923.4,221976.24,220029.08,218081.92,216134.76,214187.6,212240.44,210293.28,208346.12,206398.96,204451.8,202504.64,200557.48,198610.32,196663.16,194716,192768.84,190821.68,188874.52,186927.36,184980.2,183033.04,181085.88,179138.72,177191.56,175244.4,173297.24,171350.08,169402.92,167455.76,165508.6,163561.44,161614.28,159667.12,157719.96,155772.8,153825.64,151878.48,149931.32,147984.16,146037,144089.84,142142.68,140195.52,138248.36,136301.2,134354.04,132406.88,130459.72,128512.56,126565.4,124618.24,122671.08,120723.92,118776.76,116829.6,114882.44,112935.28,110988.12,109040.96,107093.8,105146.64,103199.48,101252.32,99305.16,97358,95410.84,93463.68,91516.52,89569.36,87622.2,85675.04,83727.88,81780.72,79833.56,77886.4,75939.24,73992.08,72044.92,70097.76,68150.6,66203.44,64256.28,62309.12,60361.96,58414.8,56467.64,54520.48,52573.32,50626.16,48679,46731.84,44784.68,42837.52,40890.36,38943.2,36996.04,35048.88,33101.72,31154.56,29207.4,27260.24,25313.08,23365.92,21418.76,19471.6,17524.44,15577.28,13630.12,11682.96,9735.8,7788.64,5841.48,3894.32,1947.16,0,0],"y":[0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,4.62844799313655e-09,5.30828418809275e-09,6.08901130367586e-09,6.95487528645317e-09,7.91116722071766e-09,8.96319646780569e-09,1.01404642827338e-08,1.14472781538214e-08,1.28718007039871e-08,1.4418826437929e-08,1.6093009171132e-08,1.79486842252962e-08,1.99469672762519e-08,2.20874448056838e-08,2.43723868782859e-08,2.6820995735962e-08,2.94556884667425e-08,3.22366407737428e-08,3.5161900029453e-08,3.82289259352322e-08,4.14674566895889e-08,4.48491443688864e-08,4.83497123905077e-08,5.19609031062472e-08,5.56752669941736e-08,5.95041162894146e-08,6.3397288382364e-08,6.73407998016632e-08,7.13201090042794e-08,7.53184059195363e-08,7.93038457213075e-08,8.3254776597514e-08,8.71530287389549e-08,9.09802119816392e-08,9.46791706884446e-08,9.82386791942326e-08,1.01648564378658e-07,1.0489093062496e-07,1.07935681424398e-07,1.10698850843396e-07,1.13226491805078e-07,1.15505547955218e-07,1.17523800276401e-07,1.19212573741043e-07,1.20561234405577e-07,1.216150825924e-07,1.22370773103691e-07,1.22826102989563e-07,1.22880547530901e-07,1.22629562057903e-07,1.22092374175562e-07,1.21277050951009e-07,1.20168311763357e-07,1.18743305534402e-07,1.17093001365283e-07,1.15234100921938e-07,1.13184060826072e-07,1.1092948703249e-07,1.08523940867482e-07,1.06012008300477e-07,1.0341516020322e-07,1.00755051826433e-07,9.80558502832872e-08,9.53625025109571e-08,9.26952866746185e-08,9.00739521916746e-08,8.7531368941457e-08,8.51088484770355e-08,8.28041327072356e-08,8.06305357304781e-08,7.86004310627042e-08,7.67730547099006e-08,7.51331981460212e-08,7.36693808623372e-08,7.2384863477713e-08,7.12891336581541e-08,7.04350503403719e-08,6.97564277867248e-08,6.92479353058207e-08,6.89034418259705e-08,6.87411469412327e-08,6.87461344170255e-08,6.88767034972275e-08,6.91216888406928e-08,6.94696095062303e-08,6.99295816551515e-08,7.04588672365749e-08,7.10408148552509e-08,7.16641040744343e-08,7.23187118129668e-08,7.29903008275724e-08,7.36624419208292e-08,7.43281306962665e-08,7.49810551167182e-08,7.561021226562e-08,7.62113066616146e-08,7.67870172993875e-08,7.73377033022229e-08,7.78644941450283e-08,7.83651486623869e-08,7.8853962678914e-08,7.93375011005989e-08,7.98224248731961e-08,8.03187713041234e-08,8.08445370850431e-08,8.14059192936703e-08,8.20115941953149e-08,8.26701788869504e-08,8.34104988906611e-08,8.42368333251844e-08,8.51477375956797e-08,8.61487525661766e-08,8.72470957450789e-08,8.84814788691181e-08,8.9817725808028e-08,9.12547437705703e-08,9.27905403920744e-08,9.44360361430526e-08,9.61848543798928e-08,9.80074748814851e-08,9.98940815764296e-08,1.01834032462611e-07,1.03819444265734e-07,1.05817871263416e-07,1.07810883319822e-07,1.09782376959206e-07,1.11711522067191e-07,1.13551504638845e-07,1.15297319655123e-07,1.16931638460597e-07,1.18437333794992e-07,1.19761587745051e-07,1.20878783771776e-07,1.21801780706783e-07,1.22517594302793e-07,1.23013949377915e-07,1.2319387908219e-07,1.23116420439831e-07,1.22784822708367e-07,1.22194793661914e-07,1.21315828370946e-07,1.20102513027396e-07,1.18630826877637e-07,1.1690541925134e-07,1.14931904913324e-07,1.12662732947555e-07,1.10141500514975e-07,1.07412684799819e-07,1.04489066991606e-07,1.01383405280066e-07,9.80613634428235e-08,9.4607625582408e-08,9.1038857972985e-08,8.73718863102928e-08,8.36166145073081e-08,7.98002409901472e-08,7.5957790147654e-08,7.21058297694167e-08,6.82607008132817e-08,6.44538370762915e-08,6.07057173054981e-08,5.70270408179535e-08,5.34308577455323e-08,4.99349007950355e-08,4.65911382183051e-08,4.33766683706036e-08,4.03002254259921e-08,3.73700632546657e-08,3.46247104799695e-08,3.20776856958148e-08,2.97035340307759e-08,2.75068464026314e-08,2.54918762497712e-08,2.37250018556277e-08,2.2160476606441e-08,2.07905657990362e-08,1.96176094048627e-08,1.86612047939919e-08,1.79670545612228e-08,1.74783508895331e-08,1.71970080231561e-08,1.71249570148327e-08,1.73128382571159e-08,1.77491980944464e-08,1.84035660403571e-08,1.92781122338699e-08,2.03750191312578e-08,2.17804205026051e-08,2.34179333962166e-08,2.52861628709802e-08,2.73866210161116e-08,2.97503933996867e-08,3.24083450124589e-08,3.5300635317109e-08,3.84261764487139e-08,4.17834338814513e-08,4.54295928669091e-08,4.93223597831216e-08,5.34299226729189e-08,5.77455527706079e-08,6.22668300474041e-08,6.70383664767979e-08,7.19768070347611e-08,7.70686460917474e-08,8.22995704072322e-08,8.76696041239814e-08,9.31495047831713e-08,9.8693637903655e-08,1.04281108323159e-07,1.09890375244319e-07,1.15483393719359e-07,1.21021401477166e-07,1.26480213368516e-07,1.31834590652309e-07,1.37047253129234e-07,1.42031585723137e-07,1.46803953097454e-07,1.51339808652839e-07,1.55615037387763e-07,1.59537942560942e-07,1.63078348371444e-07,1.66267584396873e-07,1.69087893413133e-07,1.71522502783649e-07,1.7340740419334e-07,1.74853483451565e-07,1.75866267550743e-07,1.76439721070708e-07,1.76520866291463e-07,1.7603639697875e-07,1.7511164388365e-07,1.73752689938516e-07,1.7196695846333e-07,1.69665933585931e-07,1.66922381767142e-07,1.638072733445e-07,1.60338344037099e-07,1.56531614622027e-07,1.52312234772878e-07,1.47828224556819e-07,1.43103627534641e-07,1.38162832821236e-07,1.33009127426522e-07,1.27677765843733e-07,1.22236829988349e-07,1.16711317347269e-07,1.11125995757765e-07,1.05509053959765e-07,9.99055972738501e-08,9.43390022146021e-08,8.88297156068604e-08,8.34028545393118e-08,7.81184255872724e-08,7.2965010993853e-08,6.79562545073268e-08,6.31049600258151e-08,5.84586152926892e-08,5.40347841273011e-08,4.98071843309882e-08,4.57815477776648e-08,4.19628660976337e-08,3.84263270385522e-08,3.51153864100546e-08,3.20197351861507e-08,2.91391874893751e-08,2.64922058966899e-08,2.41178200255016e-08,2.19512583996876e-08,1.99897026707573e-08,1.82302101065208e-08,1.67141399251332e-08,1.54195281972094e-08,1.43138878239971e-08,1.33944251958082e-08,1.26584737825694e-08,1.21692873541914e-08,1.18590511500413e-08,1.17251867704197e-08,1.17670213486564e-08,1.20072895925005e-08,1.24676630380195e-08,1.31060837328798e-08,1.39244229354052e-08,1.49248328855787e-08,1.61617485167998e-08,1.7610887448697e-08,1.92560875305108e-08,2.11015396254681e-08,2.3158360207958e-08,2.5501737750714e-08,2.80654011355329e-08,3.08544151897881e-08,3.3873837543691e-08,3.7170834573068e-08,4.07634239722202e-08,4.46067642467932e-08,4.8705079672604e-08,5.30624072469014e-08,5.77665823788117e-08,6.27578502552607e-08,6.80202047230644e-08,7.35551973707533e-08,7.93838905432719e-08,8.55708635944296e-08,9.20303464961808e-08,9.8760352225064e-08,1.05758449155905e-07,1.13076333798346e-07,1.20693670428466e-07,1.28560436271789e-07,1.36670326456467e-07,1.45016616346254e-07,1.53666423654756e-07,1.62532393243263e-07,1.71599078829793e-07,1.80856895306505e-07,1.90314437437922e-07,1.99978316157986e-07,2.09790251211845e-07,2.19740033759516e-07,2.29817585828894e-07,2.40038172991151e-07,2.50371149201729e-07,2.60794529617557e-07,2.7130140548843e-07,2.81886377151897e-07,2.92566604354172e-07,3.03312593999155e-07,3.1412413041833e-07,3.25001970172459e-07,3.35959721330078e-07,3.47012335453778e-07,3.58152932424968e-07,3.69391349490866e-07,3.80738470441951e-07,3.92251398953952e-07,4.03930794032088e-07,4.15783743775505e-07,4.27828976928203e-07,4.40099415122063e-07,4.52697698724858e-07,4.65576362628897e-07,4.78757238665626e-07,4.92262021042275e-07,5.06187273752415e-07,5.20568200489899e-07,5.35357153376032e-07,5.50570485082859e-07,5.66223465845749e-07,5.82488347777519e-07,5.99245956891326e-07,6.16478771752134e-07,6.34187922100972e-07,6.52416654606277e-07,6.71240044704809e-07,6.90507118881667e-07,7.10199645207988e-07,7.30297027483599e-07,7.50851455184633e-07,7.71771404545663e-07,7.9296473911665e-07,8.14390763059774e-07,8.36006636208938e-07,8.5777784348155e-07,8.79577501647415e-07,9.01348804339071e-07,9.23034254123845e-07,9.44539969867788e-07,9.65725231691599e-07,9.8656531046031e-07,1.00699711435303e-06,1.02695760909176e-06,1.04620146283527e-06,1.06471742830183e-06,1.08250652200701e-06,1.09951309067673e-06,1.11564950630876e-06,1.13055145456289e-06,1.1444676220248e-06,1.15736122439021e-06,1.16919836472367e-06,1.17974887129736e-06,1.18894366796566e-06,1.19699653664769e-06,1.20390257963462e-06,1.20966055380239e-06,1.21392142276583e-06,1.2170033133474e-06,1.21900611711868e-06,1.21996162492651e-06,1.21983352674422e-06,1.21849118439553e-06,1.21629827359825e-06,1.21331639343487e-06,1.20960998648379e-06,1.20513607278783e-06,1.20007106979463e-06,1.19459933540145e-06,1.18880369663676e-06,1.18276830790338e-06,1.17659211260302e-06,1.17045341894585e-06,1.16444086926457e-06,1.15863990419386e-06,1.15318749609158e-06,1.14829291904091e-06,1.14394813977502e-06,1.1402239996722e-06,1.13718875529781e-06,1.13513153045622e-06,1.13404465958325e-06,1.13387685897498e-06,1.13466781779337e-06,1.1364725376578e-06,1.13968940068787e-06,1.14396785764456e-06,1.14931357179163e-06,1.15572834826157e-06,1.16337506454216e-06,1.17229271162162e-06,1.18221948933247e-06,1.19312619913857e-06,1.20498058879001e-06,1.21799160948358e-06,1.23188716406613e-06,1.24654424321131e-06,1.26191077162875e-06,1.2779660347051e-06,1.29475951749833e-06,1.31202349685794e-06,1.32969957188314e-06,1.34772960920233e-06,1.36609314253883e-06,1.38467974168069e-06,1.40338813758133e-06,1.42216930486119e-06,1.44097596178553e-06,1.45972903898688e-06,1.47837995354968e-06,1.49690178581789e-06,1.51526909042591e-06,1.53343945098819e-06,1.55135466565245e-06,1.56906591710063e-06,1.58657839047639e-06,1.60390130428803e-06,1.62101928074591e-06,1.63800210494726e-06,1.65491679309484e-06,1.6718124089192e-06,1.68874306589202e-06,1.7058730165736e-06,1.72328023164485e-06,1.74106239980954e-06,1.7593234243445e-06,1.77828978698812e-06,1.79828354949852e-06,1.8193108462646e-06,1.84153276549935e-06,1.86511711652241e-06,1.89078592463347e-06,1.91859691060749e-06,1.94860616184257e-06,1.98103656603128e-06,2.01624203448509e-06,2.05553850932332e-06,2.09827754049747e-06,2.14471445307768e-06,2.19510509276974e-06,2.25055749274079e-06,2.31163235778843e-06,2.37771409405116e-06,2.44902939878558e-06,2.52579704598084e-06,2.61016152104366e-06,2.70088380930098e-06,2.79773993302806e-06,2.90082110396579e-06,3.01071473707862e-06,3.12879054133498e-06,3.25306992291237e-06,3.38341964642152e-06,3.51967513746292e-06,3.66277177778954e-06,3.81176363716297e-06,3.96533719203874e-06,4.12302783251862e-06,4.28433541110826e-06,4.44930100431507e-06,4.61589178391273e-06,4.78330323633549e-06,4.95075152400054e-06,5.11713197089629e-06,5.28052357978752e-06,5.44022539475827e-06,5.5952877472866e-06,5.74475386169992e-06,5.88541964411906e-06,6.01658125568757e-06,6.13814062004044e-06,6.24920649536245e-06,6.3486158050355e-06,6.43081867812932e-06,6.49923397203682e-06,6.55326420686566e-06,6.59235991318372e-06,6.61339534777358e-06,6.61489173480233e-06,6.60008489276967e-06,6.56890542847915e-06,6.5213434085622e-06,6.45267047729545e-06,0],"text":["density: 6.452670e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: ISABELA","density: 6.521343e-06<br />TOTAL_VENTAS: 1947.16<br />CANTON: ISABELA","density: 6.568905e-06<br />TOTAL_VENTAS: 3894.32<br />CANTON: ISABELA","density: 6.600085e-06<br />TOTAL_VENTAS: 5841.48<br />CANTON: ISABELA","density: 6.614892e-06<br />TOTAL_VENTAS: 7788.64<br />CANTON: ISABELA","density: 6.613395e-06<br />TOTAL_VENTAS: 9735.80<br />CANTON: ISABELA","density: 6.592360e-06<br />TOTAL_VENTAS: 11682.96<br />CANTON: ISABELA","density: 6.553264e-06<br />TOTAL_VENTAS: 13630.12<br />CANTON: ISABELA","density: 6.499234e-06<br />TOTAL_VENTAS: 15577.28<br />CANTON: ISABELA","density: 6.430819e-06<br />TOTAL_VENTAS: 17524.44<br />CANTON: ISABELA","density: 6.348616e-06<br />TOTAL_VENTAS: 19471.60<br />CANTON: ISABELA","density: 6.249206e-06<br />TOTAL_VENTAS: 21418.76<br />CANTON: ISABELA","density: 6.138141e-06<br />TOTAL_VENTAS: 23365.92<br />CANTON: ISABELA","density: 6.016581e-06<br />TOTAL_VENTAS: 25313.08<br />CANTON: ISABELA","density: 5.885420e-06<br />TOTAL_VENTAS: 27260.24<br />CANTON: ISABELA","density: 5.744754e-06<br />TOTAL_VENTAS: 29207.40<br />CANTON: ISABELA","density: 5.595288e-06<br />TOTAL_VENTAS: 31154.56<br />CANTON: ISABELA","density: 5.440225e-06<br />TOTAL_VENTAS: 33101.72<br />CANTON: ISABELA","density: 5.280524e-06<br />TOTAL_VENTAS: 35048.88<br />CANTON: ISABELA","density: 5.117132e-06<br />TOTAL_VENTAS: 36996.04<br />CANTON: ISABELA","density: 4.950752e-06<br />TOTAL_VENTAS: 38943.20<br />CANTON: ISABELA","density: 4.783303e-06<br />TOTAL_VENTAS: 40890.36<br />CANTON: ISABELA","density: 4.615892e-06<br />TOTAL_VENTAS: 42837.52<br />CANTON: ISABELA","density: 4.449301e-06<br />TOTAL_VENTAS: 44784.68<br />CANTON: ISABELA","density: 4.284335e-06<br />TOTAL_VENTAS: 46731.84<br />CANTON: ISABELA","density: 4.123028e-06<br />TOTAL_VENTAS: 48679.00<br />CANTON: ISABELA","density: 3.965337e-06<br />TOTAL_VENTAS: 50626.16<br />CANTON: ISABELA","density: 3.811764e-06<br />TOTAL_VENTAS: 52573.32<br />CANTON: ISABELA","density: 3.662772e-06<br />TOTAL_VENTAS: 54520.48<br />CANTON: ISABELA","density: 3.519675e-06<br />TOTAL_VENTAS: 56467.64<br />CANTON: ISABELA","density: 3.383420e-06<br />TOTAL_VENTAS: 58414.80<br />CANTON: ISABELA","density: 3.253070e-06<br />TOTAL_VENTAS: 60361.96<br />CANTON: ISABELA","density: 3.128791e-06<br />TOTAL_VENTAS: 62309.12<br />CANTON: ISABELA","density: 3.010715e-06<br />TOTAL_VENTAS: 64256.28<br />CANTON: ISABELA","density: 2.900821e-06<br />TOTAL_VENTAS: 66203.44<br />CANTON: ISABELA","density: 2.797740e-06<br />TOTAL_VENTAS: 68150.60<br />CANTON: ISABELA","density: 2.700884e-06<br />TOTAL_VENTAS: 70097.76<br />CANTON: ISABELA","density: 2.610162e-06<br />TOTAL_VENTAS: 72044.92<br />CANTON: ISABELA","density: 2.525797e-06<br />TOTAL_VENTAS: 73992.08<br />CANTON: ISABELA","density: 2.449029e-06<br />TOTAL_VENTAS: 75939.24<br />CANTON: ISABELA","density: 2.377714e-06<br />TOTAL_VENTAS: 77886.40<br />CANTON: ISABELA","density: 2.311632e-06<br />TOTAL_VENTAS: 79833.56<br />CANTON: ISABELA","density: 2.250557e-06<br />TOTAL_VENTAS: 81780.72<br />CANTON: ISABELA","density: 2.195105e-06<br />TOTAL_VENTAS: 83727.88<br />CANTON: ISABELA","density: 2.144714e-06<br />TOTAL_VENTAS: 85675.04<br />CANTON: ISABELA","density: 2.098278e-06<br />TOTAL_VENTAS: 87622.20<br />CANTON: ISABELA","density: 2.055539e-06<br />TOTAL_VENTAS: 89569.36<br />CANTON: ISABELA","density: 2.016242e-06<br />TOTAL_VENTAS: 91516.52<br />CANTON: ISABELA","density: 1.981037e-06<br />TOTAL_VENTAS: 93463.68<br />CANTON: ISABELA","density: 1.948606e-06<br />TOTAL_VENTAS: 95410.84<br />CANTON: ISABELA","density: 1.918597e-06<br />TOTAL_VENTAS: 97358.00<br />CANTON: ISABELA","density: 1.890786e-06<br />TOTAL_VENTAS: 99305.16<br />CANTON: ISABELA","density: 1.865117e-06<br />TOTAL_VENTAS: 101252.32<br />CANTON: ISABELA","density: 1.841533e-06<br />TOTAL_VENTAS: 103199.48<br />CANTON: ISABELA","density: 1.819311e-06<br />TOTAL_VENTAS: 105146.64<br />CANTON: ISABELA","density: 1.798284e-06<br />TOTAL_VENTAS: 107093.80<br />CANTON: ISABELA","density: 1.778290e-06<br />TOTAL_VENTAS: 109040.96<br />CANTON: ISABELA","density: 1.759323e-06<br />TOTAL_VENTAS: 110988.12<br />CANTON: ISABELA","density: 1.741062e-06<br />TOTAL_VENTAS: 112935.28<br />CANTON: ISABELA","density: 1.723280e-06<br />TOTAL_VENTAS: 114882.44<br />CANTON: ISABELA","density: 1.705873e-06<br />TOTAL_VENTAS: 116829.60<br />CANTON: ISABELA","density: 1.688743e-06<br />TOTAL_VENTAS: 118776.76<br />CANTON: ISABELA","density: 1.671812e-06<br />TOTAL_VENTAS: 120723.92<br />CANTON: ISABELA","density: 1.654917e-06<br />TOTAL_VENTAS: 122671.08<br />CANTON: ISABELA","density: 1.638002e-06<br />TOTAL_VENTAS: 124618.24<br />CANTON: ISABELA","density: 1.621019e-06<br />TOTAL_VENTAS: 126565.40<br />CANTON: ISABELA","density: 1.603901e-06<br />TOTAL_VENTAS: 128512.56<br />CANTON: ISABELA","density: 1.586578e-06<br />TOTAL_VENTAS: 130459.72<br />CANTON: ISABELA","density: 1.569066e-06<br />TOTAL_VENTAS: 132406.88<br />CANTON: ISABELA","density: 1.551355e-06<br />TOTAL_VENTAS: 134354.04<br />CANTON: ISABELA","density: 1.533439e-06<br />TOTAL_VENTAS: 136301.20<br />CANTON: ISABELA","density: 1.515269e-06<br />TOTAL_VENTAS: 138248.36<br />CANTON: ISABELA","density: 1.496902e-06<br />TOTAL_VENTAS: 140195.52<br />CANTON: ISABELA","density: 1.478380e-06<br />TOTAL_VENTAS: 142142.68<br />CANTON: ISABELA","density: 1.459729e-06<br />TOTAL_VENTAS: 144089.84<br />CANTON: ISABELA","density: 1.440976e-06<br />TOTAL_VENTAS: 146037.00<br />CANTON: ISABELA","density: 1.422169e-06<br />TOTAL_VENTAS: 147984.16<br />CANTON: ISABELA","density: 1.403388e-06<br />TOTAL_VENTAS: 149931.32<br />CANTON: ISABELA","density: 1.384680e-06<br />TOTAL_VENTAS: 151878.48<br />CANTON: ISABELA","density: 1.366093e-06<br />TOTAL_VENTAS: 153825.64<br />CANTON: ISABELA","density: 1.347730e-06<br />TOTAL_VENTAS: 155772.80<br />CANTON: ISABELA","density: 1.329700e-06<br />TOTAL_VENTAS: 157719.96<br />CANTON: ISABELA","density: 1.312023e-06<br />TOTAL_VENTAS: 159667.12<br />CANTON: ISABELA","density: 1.294760e-06<br />TOTAL_VENTAS: 161614.28<br />CANTON: ISABELA","density: 1.277966e-06<br />TOTAL_VENTAS: 163561.44<br />CANTON: ISABELA","density: 1.261911e-06<br />TOTAL_VENTAS: 165508.60<br />CANTON: ISABELA","density: 1.246544e-06<br />TOTAL_VENTAS: 167455.76<br />CANTON: ISABELA","density: 1.231887e-06<br />TOTAL_VENTAS: 169402.92<br />CANTON: ISABELA","density: 1.217992e-06<br />TOTAL_VENTAS: 171350.08<br />CANTON: ISABELA","density: 1.204981e-06<br />TOTAL_VENTAS: 173297.24<br />CANTON: ISABELA","density: 1.193126e-06<br />TOTAL_VENTAS: 175244.40<br />CANTON: ISABELA","density: 1.182219e-06<br />TOTAL_VENTAS: 177191.56<br />CANTON: ISABELA","density: 1.172293e-06<br />TOTAL_VENTAS: 179138.72<br />CANTON: ISABELA","density: 1.163375e-06<br />TOTAL_VENTAS: 181085.88<br />CANTON: ISABELA","density: 1.155728e-06<br />TOTAL_VENTAS: 183033.04<br />CANTON: ISABELA","density: 1.149314e-06<br />TOTAL_VENTAS: 184980.20<br />CANTON: ISABELA","density: 1.143968e-06<br />TOTAL_VENTAS: 186927.36<br />CANTON: ISABELA","density: 1.139689e-06<br />TOTAL_VENTAS: 188874.52<br />CANTON: ISABELA","density: 1.136473e-06<br />TOTAL_VENTAS: 190821.68<br />CANTON: ISABELA","density: 1.134668e-06<br />TOTAL_VENTAS: 192768.84<br />CANTON: ISABELA","density: 1.133877e-06<br />TOTAL_VENTAS: 194716.00<br />CANTON: ISABELA","density: 1.134045e-06<br />TOTAL_VENTAS: 196663.16<br />CANTON: ISABELA","density: 1.135132e-06<br />TOTAL_VENTAS: 198610.32<br />CANTON: ISABELA","density: 1.137189e-06<br />TOTAL_VENTAS: 200557.48<br />CANTON: ISABELA","density: 1.140224e-06<br />TOTAL_VENTAS: 202504.64<br />CANTON: ISABELA","density: 1.143948e-06<br />TOTAL_VENTAS: 204451.80<br />CANTON: ISABELA","density: 1.148293e-06<br />TOTAL_VENTAS: 206398.96<br />CANTON: ISABELA","density: 1.153187e-06<br />TOTAL_VENTAS: 208346.12<br />CANTON: ISABELA","density: 1.158640e-06<br />TOTAL_VENTAS: 210293.28<br />CANTON: ISABELA","density: 1.164441e-06<br />TOTAL_VENTAS: 212240.44<br />CANTON: ISABELA","density: 1.170453e-06<br />TOTAL_VENTAS: 214187.60<br />CANTON: ISABELA","density: 1.176592e-06<br />TOTAL_VENTAS: 216134.76<br />CANTON: ISABELA","density: 1.182768e-06<br />TOTAL_VENTAS: 218081.92<br />CANTON: ISABELA","density: 1.188804e-06<br />TOTAL_VENTAS: 220029.08<br />CANTON: ISABELA","density: 1.194599e-06<br />TOTAL_VENTAS: 221976.24<br />CANTON: ISABELA","density: 1.200071e-06<br />TOTAL_VENTAS: 223923.40<br />CANTON: ISABELA","density: 1.205136e-06<br />TOTAL_VENTAS: 225870.56<br />CANTON: ISABELA","density: 1.209610e-06<br />TOTAL_VENTAS: 227817.72<br />CANTON: ISABELA","density: 1.213316e-06<br />TOTAL_VENTAS: 229764.88<br />CANTON: ISABELA","density: 1.216298e-06<br />TOTAL_VENTAS: 231712.04<br />CANTON: ISABELA","density: 1.218491e-06<br />TOTAL_VENTAS: 233659.20<br />CANTON: ISABELA","density: 1.219834e-06<br />TOTAL_VENTAS: 235606.36<br />CANTON: ISABELA","density: 1.219962e-06<br />TOTAL_VENTAS: 237553.52<br />CANTON: ISABELA","density: 1.219006e-06<br />TOTAL_VENTAS: 239500.68<br />CANTON: ISABELA","density: 1.217003e-06<br />TOTAL_VENTAS: 241447.84<br />CANTON: ISABELA","density: 1.213921e-06<br />TOTAL_VENTAS: 243395.00<br />CANTON: ISABELA","density: 1.209661e-06<br />TOTAL_VENTAS: 245342.16<br />CANTON: ISABELA","density: 1.203903e-06<br />TOTAL_VENTAS: 247289.32<br />CANTON: ISABELA","density: 1.196997e-06<br />TOTAL_VENTAS: 249236.48<br />CANTON: ISABELA","density: 1.188944e-06<br />TOTAL_VENTAS: 251183.64<br />CANTON: ISABELA","density: 1.179749e-06<br />TOTAL_VENTAS: 253130.80<br />CANTON: ISABELA","density: 1.169198e-06<br />TOTAL_VENTAS: 255077.96<br />CANTON: ISABELA","density: 1.157361e-06<br />TOTAL_VENTAS: 257025.12<br />CANTON: ISABELA","density: 1.144468e-06<br />TOTAL_VENTAS: 258972.28<br />CANTON: ISABELA","density: 1.130551e-06<br />TOTAL_VENTAS: 260919.44<br />CANTON: ISABELA","density: 1.115650e-06<br />TOTAL_VENTAS: 262866.60<br />CANTON: ISABELA","density: 1.099513e-06<br />TOTAL_VENTAS: 264813.76<br />CANTON: ISABELA","density: 1.082507e-06<br />TOTAL_VENTAS: 266760.92<br />CANTON: ISABELA","density: 1.064717e-06<br />TOTAL_VENTAS: 268708.08<br />CANTON: ISABELA","density: 1.046201e-06<br />TOTAL_VENTAS: 270655.24<br />CANTON: ISABELA","density: 1.026958e-06<br />TOTAL_VENTAS: 272602.40<br />CANTON: ISABELA","density: 1.006997e-06<br />TOTAL_VENTAS: 274549.56<br />CANTON: ISABELA","density: 9.865653e-07<br />TOTAL_VENTAS: 276496.72<br />CANTON: ISABELA","density: 9.657252e-07<br />TOTAL_VENTAS: 278443.88<br />CANTON: ISABELA","density: 9.445400e-07<br />TOTAL_VENTAS: 280391.04<br />CANTON: ISABELA","density: 9.230343e-07<br />TOTAL_VENTAS: 282338.20<br />CANTON: ISABELA","density: 9.013488e-07<br />TOTAL_VENTAS: 284285.36<br />CANTON: ISABELA","density: 8.795775e-07<br />TOTAL_VENTAS: 286232.52<br />CANTON: ISABELA","density: 8.577778e-07<br />TOTAL_VENTAS: 288179.68<br />CANTON: ISABELA","density: 8.360066e-07<br />TOTAL_VENTAS: 290126.84<br />CANTON: ISABELA","density: 8.143908e-07<br />TOTAL_VENTAS: 292074.00<br />CANTON: ISABELA","density: 7.929647e-07<br />TOTAL_VENTAS: 294021.16<br />CANTON: ISABELA","density: 7.717714e-07<br />TOTAL_VENTAS: 295968.32<br />CANTON: ISABELA","density: 7.508515e-07<br />TOTAL_VENTAS: 297915.48<br />CANTON: ISABELA","density: 7.302970e-07<br />TOTAL_VENTAS: 299862.64<br />CANTON: ISABELA","density: 7.101996e-07<br />TOTAL_VENTAS: 301809.80<br />CANTON: ISABELA","density: 6.905071e-07<br />TOTAL_VENTAS: 303756.96<br />CANTON: ISABELA","density: 6.712400e-07<br />TOTAL_VENTAS: 305704.12<br />CANTON: ISABELA","density: 6.524167e-07<br />TOTAL_VENTAS: 307651.28<br />CANTON: ISABELA","density: 6.341879e-07<br />TOTAL_VENTAS: 309598.44<br />CANTON: ISABELA","density: 6.164788e-07<br />TOTAL_VENTAS: 311545.60<br />CANTON: ISABELA","density: 5.992460e-07<br />TOTAL_VENTAS: 313492.76<br />CANTON: ISABELA","density: 5.824883e-07<br />TOTAL_VENTAS: 315439.92<br />CANTON: ISABELA","density: 5.662235e-07<br />TOTAL_VENTAS: 317387.08<br />CANTON: ISABELA","density: 5.505705e-07<br />TOTAL_VENTAS: 319334.24<br />CANTON: ISABELA","density: 5.353572e-07<br />TOTAL_VENTAS: 321281.40<br />CANTON: ISABELA","density: 5.205682e-07<br />TOTAL_VENTAS: 323228.56<br />CANTON: ISABELA","density: 5.061873e-07<br />TOTAL_VENTAS: 325175.72<br />CANTON: ISABELA","density: 4.922620e-07<br />TOTAL_VENTAS: 327122.88<br />CANTON: ISABELA","density: 4.787572e-07<br />TOTAL_VENTAS: 329070.04<br />CANTON: ISABELA","density: 4.655764e-07<br />TOTAL_VENTAS: 331017.20<br />CANTON: ISABELA","density: 4.526977e-07<br />TOTAL_VENTAS: 332964.36<br />CANTON: ISABELA","density: 4.400994e-07<br />TOTAL_VENTAS: 334911.52<br />CANTON: ISABELA","density: 4.278290e-07<br />TOTAL_VENTAS: 336858.68<br />CANTON: ISABELA","density: 4.157837e-07<br />TOTAL_VENTAS: 338805.84<br />CANTON: ISABELA","density: 4.039308e-07<br />TOTAL_VENTAS: 340753.00<br />CANTON: ISABELA","density: 3.922514e-07<br />TOTAL_VENTAS: 342700.16<br />CANTON: ISABELA","density: 3.807385e-07<br />TOTAL_VENTAS: 344647.32<br />CANTON: ISABELA","density: 3.693913e-07<br />TOTAL_VENTAS: 346594.48<br />CANTON: ISABELA","density: 3.581529e-07<br />TOTAL_VENTAS: 348541.64<br />CANTON: ISABELA","density: 3.470123e-07<br />TOTAL_VENTAS: 350488.80<br />CANTON: ISABELA","density: 3.359597e-07<br />TOTAL_VENTAS: 352435.96<br />CANTON: ISABELA","density: 3.250020e-07<br />TOTAL_VENTAS: 354383.12<br />CANTON: ISABELA","density: 3.141241e-07<br />TOTAL_VENTAS: 356330.28<br />CANTON: ISABELA","density: 3.033126e-07<br />TOTAL_VENTAS: 358277.44<br />CANTON: ISABELA","density: 2.925666e-07<br />TOTAL_VENTAS: 360224.60<br />CANTON: ISABELA","density: 2.818864e-07<br />TOTAL_VENTAS: 362171.76<br />CANTON: ISABELA","density: 2.713014e-07<br />TOTAL_VENTAS: 364118.92<br />CANTON: ISABELA","density: 2.607945e-07<br />TOTAL_VENTAS: 366066.08<br />CANTON: ISABELA","density: 2.503711e-07<br />TOTAL_VENTAS: 368013.24<br />CANTON: ISABELA","density: 2.400382e-07<br />TOTAL_VENTAS: 369960.40<br />CANTON: ISABELA","density: 2.298176e-07<br />TOTAL_VENTAS: 371907.56<br />CANTON: ISABELA","density: 2.197400e-07<br />TOTAL_VENTAS: 373854.72<br />CANTON: ISABELA","density: 2.097903e-07<br />TOTAL_VENTAS: 375801.88<br />CANTON: ISABELA","density: 1.999783e-07<br />TOTAL_VENTAS: 377749.04<br />CANTON: ISABELA","density: 1.903144e-07<br />TOTAL_VENTAS: 379696.20<br />CANTON: ISABELA","density: 1.808569e-07<br />TOTAL_VENTAS: 381643.36<br />CANTON: ISABELA","density: 1.715991e-07<br />TOTAL_VENTAS: 383590.52<br />CANTON: ISABELA","density: 1.625324e-07<br />TOTAL_VENTAS: 385537.68<br />CANTON: ISABELA","density: 1.536664e-07<br />TOTAL_VENTAS: 387484.84<br />CANTON: ISABELA","density: 1.450166e-07<br />TOTAL_VENTAS: 389432.00<br />CANTON: ISABELA","density: 1.366703e-07<br />TOTAL_VENTAS: 391379.16<br />CANTON: ISABELA","density: 1.285604e-07<br />TOTAL_VENTAS: 393326.32<br />CANTON: ISABELA","density: 1.206937e-07<br />TOTAL_VENTAS: 395273.48<br />CANTON: ISABELA","density: 1.130763e-07<br />TOTAL_VENTAS: 397220.64<br />CANTON: ISABELA","density: 1.057584e-07<br />TOTAL_VENTAS: 399167.80<br />CANTON: ISABELA","density: 9.876035e-08<br />TOTAL_VENTAS: 401114.96<br />CANTON: ISABELA","density: 9.203035e-08<br />TOTAL_VENTAS: 403062.12<br />CANTON: ISABELA","density: 8.557086e-08<br />TOTAL_VENTAS: 405009.28<br />CANTON: ISABELA","density: 7.938389e-08<br />TOTAL_VENTAS: 406956.44<br />CANTON: ISABELA","density: 7.355520e-08<br />TOTAL_VENTAS: 408903.60<br />CANTON: ISABELA","density: 6.802020e-08<br />TOTAL_VENTAS: 410850.76<br />CANTON: ISABELA","density: 6.275785e-08<br />TOTAL_VENTAS: 412797.92<br />CANTON: ISABELA","density: 5.776658e-08<br />TOTAL_VENTAS: 414745.08<br />CANTON: ISABELA","density: 5.306241e-08<br />TOTAL_VENTAS: 416692.24<br />CANTON: ISABELA","density: 4.870508e-08<br />TOTAL_VENTAS: 418639.40<br />CANTON: ISABELA","density: 4.460676e-08<br />TOTAL_VENTAS: 420586.56<br />CANTON: ISABELA","density: 4.076342e-08<br />TOTAL_VENTAS: 422533.72<br />CANTON: ISABELA","density: 3.717083e-08<br />TOTAL_VENTAS: 424480.88<br />CANTON: ISABELA","density: 3.387384e-08<br />TOTAL_VENTAS: 426428.04<br />CANTON: ISABELA","density: 3.085442e-08<br />TOTAL_VENTAS: 428375.20<br />CANTON: ISABELA","density: 2.806540e-08<br />TOTAL_VENTAS: 430322.36<br />CANTON: ISABELA","density: 2.550174e-08<br />TOTAL_VENTAS: 432269.52<br />CANTON: ISABELA","density: 2.315836e-08<br />TOTAL_VENTAS: 434216.68<br />CANTON: ISABELA","density: 2.110154e-08<br />TOTAL_VENTAS: 436163.84<br />CANTON: ISABELA","density: 1.925609e-08<br />TOTAL_VENTAS: 438111.00<br />CANTON: ISABELA","density: 1.761089e-08<br />TOTAL_VENTAS: 440058.16<br />CANTON: ISABELA","density: 1.616175e-08<br />TOTAL_VENTAS: 442005.32<br />CANTON: ISABELA","density: 1.492483e-08<br />TOTAL_VENTAS: 443952.48<br />CANTON: ISABELA","density: 1.392442e-08<br />TOTAL_VENTAS: 445899.64<br />CANTON: ISABELA","density: 1.310608e-08<br />TOTAL_VENTAS: 447846.80<br />CANTON: ISABELA","density: 1.246766e-08<br />TOTAL_VENTAS: 449793.96<br />CANTON: ISABELA","density: 1.200729e-08<br />TOTAL_VENTAS: 451741.12<br />CANTON: ISABELA","density: 1.176702e-08<br />TOTAL_VENTAS: 453688.28<br />CANTON: ISABELA","density: 1.172519e-08<br />TOTAL_VENTAS: 455635.44<br />CANTON: ISABELA","density: 1.185905e-08<br />TOTAL_VENTAS: 457582.60<br />CANTON: ISABELA","density: 1.216929e-08<br />TOTAL_VENTAS: 459529.76<br />CANTON: ISABELA","density: 1.265847e-08<br />TOTAL_VENTAS: 461476.92<br />CANTON: ISABELA","density: 1.339443e-08<br />TOTAL_VENTAS: 463424.08<br />CANTON: ISABELA","density: 1.431389e-08<br />TOTAL_VENTAS: 465371.24<br />CANTON: ISABELA","density: 1.541953e-08<br />TOTAL_VENTAS: 467318.40<br />CANTON: ISABELA","density: 1.671414e-08<br />TOTAL_VENTAS: 469265.56<br />CANTON: ISABELA","density: 1.823021e-08<br />TOTAL_VENTAS: 471212.72<br />CANTON: ISABELA","density: 1.998970e-08<br />TOTAL_VENTAS: 473159.88<br />CANTON: ISABELA","density: 2.195126e-08<br />TOTAL_VENTAS: 475107.04<br />CANTON: ISABELA","density: 2.411782e-08<br />TOTAL_VENTAS: 477054.20<br />CANTON: ISABELA","density: 2.649221e-08<br />TOTAL_VENTAS: 479001.36<br />CANTON: ISABELA","density: 2.913919e-08<br />TOTAL_VENTAS: 480948.52<br />CANTON: ISABELA","density: 3.201974e-08<br />TOTAL_VENTAS: 482895.68<br />CANTON: ISABELA","density: 3.511539e-08<br />TOTAL_VENTAS: 484842.84<br />CANTON: ISABELA","density: 3.842633e-08<br />TOTAL_VENTAS: 486790.00<br />CANTON: ISABELA","density: 4.196287e-08<br />TOTAL_VENTAS: 488737.16<br />CANTON: ISABELA","density: 4.578155e-08<br />TOTAL_VENTAS: 490684.32<br />CANTON: ISABELA","density: 4.980718e-08<br />TOTAL_VENTAS: 492631.48<br />CANTON: ISABELA","density: 5.403478e-08<br />TOTAL_VENTAS: 494578.64<br />CANTON: ISABELA","density: 5.845862e-08<br />TOTAL_VENTAS: 496525.80<br />CANTON: ISABELA","density: 6.310496e-08<br />TOTAL_VENTAS: 498472.96<br />CANTON: ISABELA","density: 6.795625e-08<br />TOTAL_VENTAS: 500420.12<br />CANTON: ISABELA","density: 7.296501e-08<br />TOTAL_VENTAS: 502367.28<br />CANTON: ISABELA","density: 7.811843e-08<br />TOTAL_VENTAS: 504314.44<br />CANTON: ISABELA","density: 8.340285e-08<br />TOTAL_VENTAS: 506261.60<br />CANTON: ISABELA","density: 8.882972e-08<br />TOTAL_VENTAS: 508208.76<br />CANTON: ISABELA","density: 9.433900e-08<br />TOTAL_VENTAS: 510155.92<br />CANTON: ISABELA","density: 9.990560e-08<br />TOTAL_VENTAS: 512103.08<br />CANTON: ISABELA","density: 1.055091e-07<br />TOTAL_VENTAS: 514050.24<br />CANTON: ISABELA","density: 1.111260e-07<br />TOTAL_VENTAS: 515997.40<br />CANTON: ISABELA","density: 1.167113e-07<br />TOTAL_VENTAS: 517944.56<br />CANTON: ISABELA","density: 1.222368e-07<br />TOTAL_VENTAS: 519891.72<br />CANTON: ISABELA","density: 1.276778e-07<br />TOTAL_VENTAS: 521838.88<br />CANTON: ISABELA","density: 1.330091e-07<br />TOTAL_VENTAS: 523786.04<br />CANTON: ISABELA","density: 1.381628e-07<br />TOTAL_VENTAS: 525733.20<br />CANTON: ISABELA","density: 1.431036e-07<br />TOTAL_VENTAS: 527680.36<br />CANTON: ISABELA","density: 1.478282e-07<br />TOTAL_VENTAS: 529627.52<br />CANTON: ISABELA","density: 1.523122e-07<br />TOTAL_VENTAS: 531574.68<br />CANTON: ISABELA","density: 1.565316e-07<br />TOTAL_VENTAS: 533521.84<br />CANTON: ISABELA","density: 1.603383e-07<br />TOTAL_VENTAS: 535469.00<br />CANTON: ISABELA","density: 1.638073e-07<br />TOTAL_VENTAS: 537416.16<br />CANTON: ISABELA","density: 1.669224e-07<br />TOTAL_VENTAS: 539363.32<br />CANTON: ISABELA","density: 1.696659e-07<br />TOTAL_VENTAS: 541310.48<br />CANTON: ISABELA","density: 1.719670e-07<br />TOTAL_VENTAS: 543257.64<br />CANTON: ISABELA","density: 1.737527e-07<br />TOTAL_VENTAS: 545204.80<br />CANTON: ISABELA","density: 1.751116e-07<br />TOTAL_VENTAS: 547151.96<br />CANTON: ISABELA","density: 1.760364e-07<br />TOTAL_VENTAS: 549099.12<br />CANTON: ISABELA","density: 1.765209e-07<br />TOTAL_VENTAS: 551046.28<br />CANTON: ISABELA","density: 1.764397e-07<br />TOTAL_VENTAS: 552993.44<br />CANTON: ISABELA","density: 1.758663e-07<br />TOTAL_VENTAS: 554940.60<br />CANTON: ISABELA","density: 1.748535e-07<br />TOTAL_VENTAS: 556887.76<br />CANTON: ISABELA","density: 1.734074e-07<br />TOTAL_VENTAS: 558834.92<br />CANTON: ISABELA","density: 1.715225e-07<br />TOTAL_VENTAS: 560782.08<br />CANTON: ISABELA","density: 1.690879e-07<br />TOTAL_VENTAS: 562729.24<br />CANTON: ISABELA","density: 1.662676e-07<br />TOTAL_VENTAS: 564676.40<br />CANTON: ISABELA","density: 1.630783e-07<br />TOTAL_VENTAS: 566623.56<br />CANTON: ISABELA","density: 1.595379e-07<br />TOTAL_VENTAS: 568570.72<br />CANTON: ISABELA","density: 1.556150e-07<br />TOTAL_VENTAS: 570517.88<br />CANTON: ISABELA","density: 1.513398e-07<br />TOTAL_VENTAS: 572465.04<br />CANTON: ISABELA","density: 1.468040e-07<br />TOTAL_VENTAS: 574412.20<br />CANTON: ISABELA","density: 1.420316e-07<br />TOTAL_VENTAS: 576359.36<br />CANTON: ISABELA","density: 1.370473e-07<br />TOTAL_VENTAS: 578306.52<br />CANTON: ISABELA","density: 1.318346e-07<br />TOTAL_VENTAS: 580253.68<br />CANTON: ISABELA","density: 1.264802e-07<br />TOTAL_VENTAS: 582200.84<br />CANTON: ISABELA","density: 1.210214e-07<br />TOTAL_VENTAS: 584148.00<br />CANTON: ISABELA","density: 1.154834e-07<br />TOTAL_VENTAS: 586095.16<br />CANTON: ISABELA","density: 1.098904e-07<br />TOTAL_VENTAS: 588042.32<br />CANTON: ISABELA","density: 1.042811e-07<br />TOTAL_VENTAS: 589989.48<br />CANTON: ISABELA","density: 9.869364e-08<br />TOTAL_VENTAS: 591936.64<br />CANTON: ISABELA","density: 9.314950e-08<br />TOTAL_VENTAS: 593883.80<br />CANTON: ISABELA","density: 8.766960e-08<br />TOTAL_VENTAS: 595830.96<br />CANTON: ISABELA","density: 8.229957e-08<br />TOTAL_VENTAS: 597778.12<br />CANTON: ISABELA","density: 7.706865e-08<br />TOTAL_VENTAS: 599725.28<br />CANTON: ISABELA","density: 7.197681e-08<br />TOTAL_VENTAS: 601672.44<br />CANTON: ISABELA","density: 6.703837e-08<br />TOTAL_VENTAS: 603619.60<br />CANTON: ISABELA","density: 6.226683e-08<br />TOTAL_VENTAS: 605566.76<br />CANTON: ISABELA","density: 5.774555e-08<br />TOTAL_VENTAS: 607513.92<br />CANTON: ISABELA","density: 5.342992e-08<br />TOTAL_VENTAS: 609461.08<br />CANTON: ISABELA","density: 4.932236e-08<br />TOTAL_VENTAS: 611408.24<br />CANTON: ISABELA","density: 4.542959e-08<br />TOTAL_VENTAS: 613355.40<br />CANTON: ISABELA","density: 4.178343e-08<br />TOTAL_VENTAS: 615302.56<br />CANTON: ISABELA","density: 3.842618e-08<br />TOTAL_VENTAS: 617249.72<br />CANTON: ISABELA","density: 3.530064e-08<br />TOTAL_VENTAS: 619196.88<br />CANTON: ISABELA","density: 3.240835e-08<br />TOTAL_VENTAS: 621144.04<br />CANTON: ISABELA","density: 2.975039e-08<br />TOTAL_VENTAS: 623091.20<br />CANTON: ISABELA","density: 2.738662e-08<br />TOTAL_VENTAS: 625038.36<br />CANTON: ISABELA","density: 2.528616e-08<br />TOTAL_VENTAS: 626985.52<br />CANTON: ISABELA","density: 2.341793e-08<br />TOTAL_VENTAS: 628932.68<br />CANTON: ISABELA","density: 2.178042e-08<br />TOTAL_VENTAS: 630879.84<br />CANTON: ISABELA","density: 2.037502e-08<br />TOTAL_VENTAS: 632827.00<br />CANTON: ISABELA","density: 1.927811e-08<br />TOTAL_VENTAS: 634774.16<br />CANTON: ISABELA","density: 1.840357e-08<br />TOTAL_VENTAS: 636721.32<br />CANTON: ISABELA","density: 1.774920e-08<br />TOTAL_VENTAS: 638668.48<br />CANTON: ISABELA","density: 1.731284e-08<br />TOTAL_VENTAS: 640615.64<br />CANTON: ISABELA","density: 1.712496e-08<br />TOTAL_VENTAS: 642562.80<br />CANTON: ISABELA","density: 1.719701e-08<br />TOTAL_VENTAS: 644509.96<br />CANTON: ISABELA","density: 1.747835e-08<br />TOTAL_VENTAS: 646457.12<br />CANTON: ISABELA","density: 1.796705e-08<br />TOTAL_VENTAS: 648404.28<br />CANTON: ISABELA","density: 1.866120e-08<br />TOTAL_VENTAS: 650351.44<br />CANTON: ISABELA","density: 1.961761e-08<br />TOTAL_VENTAS: 652298.60<br />CANTON: ISABELA","density: 2.079057e-08<br />TOTAL_VENTAS: 654245.76<br />CANTON: ISABELA","density: 2.216048e-08<br />TOTAL_VENTAS: 656192.92<br />CANTON: ISABELA","density: 2.372500e-08<br />TOTAL_VENTAS: 658140.08<br />CANTON: ISABELA","density: 2.549188e-08<br />TOTAL_VENTAS: 660087.24<br />CANTON: ISABELA","density: 2.750685e-08<br />TOTAL_VENTAS: 662034.40<br />CANTON: ISABELA","density: 2.970353e-08<br />TOTAL_VENTAS: 663981.56<br />CANTON: ISABELA","density: 3.207769e-08<br />TOTAL_VENTAS: 665928.72<br />CANTON: ISABELA","density: 3.462471e-08<br />TOTAL_VENTAS: 667875.88<br />CANTON: ISABELA","density: 3.737006e-08<br />TOTAL_VENTAS: 669823.04<br />CANTON: ISABELA","density: 4.030023e-08<br />TOTAL_VENTAS: 671770.20<br />CANTON: ISABELA","density: 4.337667e-08<br />TOTAL_VENTAS: 673717.36<br />CANTON: ISABELA","density: 4.659114e-08<br />TOTAL_VENTAS: 675664.52<br />CANTON: ISABELA","density: 4.993490e-08<br />TOTAL_VENTAS: 677611.68<br />CANTON: ISABELA","density: 5.343086e-08<br />TOTAL_VENTAS: 679558.84<br />CANTON: ISABELA","density: 5.702704e-08<br />TOTAL_VENTAS: 681506.00<br />CANTON: ISABELA","density: 6.070572e-08<br />TOTAL_VENTAS: 683453.16<br />CANTON: ISABELA","density: 6.445384e-08<br />TOTAL_VENTAS: 685400.32<br />CANTON: ISABELA","density: 6.826070e-08<br />TOTAL_VENTAS: 687347.48<br />CANTON: ISABELA","density: 7.210583e-08<br />TOTAL_VENTAS: 689294.64<br />CANTON: ISABELA","density: 7.595779e-08<br />TOTAL_VENTAS: 691241.80<br />CANTON: ISABELA","density: 7.980024e-08<br />TOTAL_VENTAS: 693188.96<br />CANTON: ISABELA","density: 8.361661e-08<br />TOTAL_VENTAS: 695136.12<br />CANTON: ISABELA","density: 8.737189e-08<br />TOTAL_VENTAS: 697083.28<br />CANTON: ISABELA","density: 9.103886e-08<br />TOTAL_VENTAS: 699030.44<br />CANTON: ISABELA","density: 9.460763e-08<br />TOTAL_VENTAS: 700977.60<br />CANTON: ISABELA","density: 9.806136e-08<br />TOTAL_VENTAS: 702924.76<br />CANTON: ISABELA","density: 1.013834e-07<br />TOTAL_VENTAS: 704871.92<br />CANTON: ISABELA","density: 1.044891e-07<br />TOTAL_VENTAS: 706819.08<br />CANTON: ISABELA","density: 1.074127e-07<br />TOTAL_VENTAS: 708766.24<br />CANTON: ISABELA","density: 1.101415e-07<br />TOTAL_VENTAS: 710713.40<br />CANTON: ISABELA","density: 1.126627e-07<br />TOTAL_VENTAS: 712660.56<br />CANTON: ISABELA","density: 1.149319e-07<br />TOTAL_VENTAS: 714607.72<br />CANTON: ISABELA","density: 1.169054e-07<br />TOTAL_VENTAS: 716554.88<br />CANTON: ISABELA","density: 1.186308e-07<br />TOTAL_VENTAS: 718502.04<br />CANTON: ISABELA","density: 1.201025e-07<br />TOTAL_VENTAS: 720449.20<br />CANTON: ISABELA","density: 1.213158e-07<br />TOTAL_VENTAS: 722396.36<br />CANTON: ISABELA","density: 1.221948e-07<br />TOTAL_VENTAS: 724343.52<br />CANTON: ISABELA","density: 1.227848e-07<br />TOTAL_VENTAS: 726290.68<br />CANTON: ISABELA","density: 1.231164e-07<br />TOTAL_VENTAS: 728237.84<br />CANTON: ISABELA","density: 1.231939e-07<br />TOTAL_VENTAS: 730185.00<br />CANTON: ISABELA","density: 1.230139e-07<br />TOTAL_VENTAS: 732132.16<br />CANTON: ISABELA","density: 1.225176e-07<br />TOTAL_VENTAS: 734079.32<br />CANTON: ISABELA","density: 1.218018e-07<br />TOTAL_VENTAS: 736026.48<br />CANTON: ISABELA","density: 1.208788e-07<br />TOTAL_VENTAS: 737973.64<br />CANTON: ISABELA","density: 1.197616e-07<br />TOTAL_VENTAS: 739920.80<br />CANTON: ISABELA","density: 1.184373e-07<br />TOTAL_VENTAS: 741867.96<br />CANTON: ISABELA","density: 1.169316e-07<br />TOTAL_VENTAS: 743815.12<br />CANTON: ISABELA","density: 1.152973e-07<br />TOTAL_VENTAS: 745762.28<br />CANTON: ISABELA","density: 1.135515e-07<br />TOTAL_VENTAS: 747709.44<br />CANTON: ISABELA","density: 1.117115e-07<br />TOTAL_VENTAS: 749656.60<br />CANTON: ISABELA","density: 1.097824e-07<br />TOTAL_VENTAS: 751603.76<br />CANTON: ISABELA","density: 1.078109e-07<br />TOTAL_VENTAS: 753550.92<br />CANTON: ISABELA","density: 1.058179e-07<br />TOTAL_VENTAS: 755498.08<br />CANTON: ISABELA","density: 1.038194e-07<br />TOTAL_VENTAS: 757445.24<br />CANTON: ISABELA","density: 1.018340e-07<br />TOTAL_VENTAS: 759392.40<br />CANTON: ISABELA","density: 9.989408e-08<br />TOTAL_VENTAS: 761339.56<br />CANTON: ISABELA","density: 9.800747e-08<br />TOTAL_VENTAS: 763286.72<br />CANTON: ISABELA","density: 9.618485e-08<br />TOTAL_VENTAS: 765233.88<br />CANTON: ISABELA","density: 9.443604e-08<br />TOTAL_VENTAS: 767181.04<br />CANTON: ISABELA","density: 9.279054e-08<br />TOTAL_VENTAS: 769128.20<br />CANTON: ISABELA","density: 9.125474e-08<br />TOTAL_VENTAS: 771075.36<br />CANTON: ISABELA","density: 8.981773e-08<br />TOTAL_VENTAS: 773022.52<br />CANTON: ISABELA","density: 8.848148e-08<br />TOTAL_VENTAS: 774969.68<br />CANTON: ISABELA","density: 8.724710e-08<br />TOTAL_VENTAS: 776916.84<br />CANTON: ISABELA","density: 8.614875e-08<br />TOTAL_VENTAS: 778864.00<br />CANTON: ISABELA","density: 8.514774e-08<br />TOTAL_VENTAS: 780811.16<br />CANTON: ISABELA","density: 8.423683e-08<br />TOTAL_VENTAS: 782758.32<br />CANTON: ISABELA","density: 8.341050e-08<br />TOTAL_VENTAS: 784705.48<br />CANTON: ISABELA","density: 8.267018e-08<br />TOTAL_VENTAS: 786652.64<br />CANTON: ISABELA","density: 8.201159e-08<br />TOTAL_VENTAS: 788599.80<br />CANTON: ISABELA","density: 8.140592e-08<br />TOTAL_VENTAS: 790546.96<br />CANTON: ISABELA","density: 8.084454e-08<br />TOTAL_VENTAS: 792494.12<br />CANTON: ISABELA","density: 8.031877e-08<br />TOTAL_VENTAS: 794441.28<br />CANTON: ISABELA","density: 7.982242e-08<br />TOTAL_VENTAS: 796388.44<br />CANTON: ISABELA","density: 7.933750e-08<br />TOTAL_VENTAS: 798335.60<br />CANTON: ISABELA","density: 7.885396e-08<br />TOTAL_VENTAS: 800282.76<br />CANTON: ISABELA","density: 7.836515e-08<br />TOTAL_VENTAS: 802229.92<br />CANTON: ISABELA","density: 7.786449e-08<br />TOTAL_VENTAS: 804177.08<br />CANTON: ISABELA","density: 7.733770e-08<br />TOTAL_VENTAS: 806124.24<br />CANTON: ISABELA","density: 7.678702e-08<br />TOTAL_VENTAS: 808071.40<br />CANTON: ISABELA","density: 7.621131e-08<br />TOTAL_VENTAS: 810018.56<br />CANTON: ISABELA","density: 7.561021e-08<br />TOTAL_VENTAS: 811965.72<br />CANTON: ISABELA","density: 7.498106e-08<br />TOTAL_VENTAS: 813912.88<br />CANTON: ISABELA","density: 7.432813e-08<br />TOTAL_VENTAS: 815860.04<br />CANTON: ISABELA","density: 7.366244e-08<br />TOTAL_VENTAS: 817807.20<br />CANTON: ISABELA","density: 7.299030e-08<br />TOTAL_VENTAS: 819754.36<br />CANTON: ISABELA","density: 7.231871e-08<br />TOTAL_VENTAS: 821701.52<br />CANTON: ISABELA","density: 7.166410e-08<br />TOTAL_VENTAS: 823648.68<br />CANTON: ISABELA","density: 7.104081e-08<br />TOTAL_VENTAS: 825595.84<br />CANTON: ISABELA","density: 7.045887e-08<br />TOTAL_VENTAS: 827543.00<br />CANTON: ISABELA","density: 6.992958e-08<br />TOTAL_VENTAS: 829490.16<br />CANTON: ISABELA","density: 6.946961e-08<br />TOTAL_VENTAS: 831437.32<br />CANTON: ISABELA","density: 6.912169e-08<br />TOTAL_VENTAS: 833384.48<br />CANTON: ISABELA","density: 6.887670e-08<br />TOTAL_VENTAS: 835331.64<br />CANTON: ISABELA","density: 6.874613e-08<br />TOTAL_VENTAS: 837278.80<br />CANTON: ISABELA","density: 6.874115e-08<br />TOTAL_VENTAS: 839225.96<br />CANTON: ISABELA","density: 6.890344e-08<br />TOTAL_VENTAS: 841173.12<br />CANTON: ISABELA","density: 6.924794e-08<br />TOTAL_VENTAS: 843120.28<br />CANTON: ISABELA","density: 6.975643e-08<br />TOTAL_VENTAS: 845067.44<br />CANTON: ISABELA","density: 7.043505e-08<br />TOTAL_VENTAS: 847014.60<br />CANTON: ISABELA","density: 7.128913e-08<br />TOTAL_VENTAS: 848961.76<br />CANTON: ISABELA","density: 7.238486e-08<br />TOTAL_VENTAS: 850908.92<br />CANTON: ISABELA","density: 7.366938e-08<br />TOTAL_VENTAS: 852856.08<br />CANTON: ISABELA","density: 7.513320e-08<br />TOTAL_VENTAS: 854803.24<br />CANTON: ISABELA","density: 7.677305e-08<br />TOTAL_VENTAS: 856750.40<br />CANTON: ISABELA","density: 7.860043e-08<br />TOTAL_VENTAS: 858697.56<br />CANTON: ISABELA","density: 8.063054e-08<br />TOTAL_VENTAS: 860644.72<br />CANTON: ISABELA","density: 8.280413e-08<br />TOTAL_VENTAS: 862591.88<br />CANTON: ISABELA","density: 8.510885e-08<br />TOTAL_VENTAS: 864539.04<br />CANTON: ISABELA","density: 8.753137e-08<br />TOTAL_VENTAS: 866486.20<br />CANTON: ISABELA","density: 9.007395e-08<br />TOTAL_VENTAS: 868433.36<br />CANTON: ISABELA","density: 9.269529e-08<br />TOTAL_VENTAS: 870380.52<br />CANTON: ISABELA","density: 9.536250e-08<br />TOTAL_VENTAS: 872327.68<br />CANTON: ISABELA","density: 9.805585e-08<br />TOTAL_VENTAS: 874274.84<br />CANTON: ISABELA","density: 1.007551e-07<br />TOTAL_VENTAS: 876222.00<br />CANTON: ISABELA","density: 1.034152e-07<br />TOTAL_VENTAS: 878169.16<br />CANTON: ISABELA","density: 1.060120e-07<br />TOTAL_VENTAS: 880116.32<br />CANTON: ISABELA","density: 1.085239e-07<br />TOTAL_VENTAS: 882063.48<br />CANTON: ISABELA","density: 1.109295e-07<br />TOTAL_VENTAS: 884010.64<br />CANTON: ISABELA","density: 1.131841e-07<br />TOTAL_VENTAS: 885957.80<br />CANTON: ISABELA","density: 1.152341e-07<br />TOTAL_VENTAS: 887904.96<br />CANTON: ISABELA","density: 1.170930e-07<br />TOTAL_VENTAS: 889852.12<br />CANTON: ISABELA","density: 1.187433e-07<br />TOTAL_VENTAS: 891799.28<br />CANTON: ISABELA","density: 1.201683e-07<br />TOTAL_VENTAS: 893746.44<br />CANTON: ISABELA","density: 1.212771e-07<br />TOTAL_VENTAS: 895693.60<br />CANTON: ISABELA","density: 1.220924e-07<br />TOTAL_VENTAS: 897640.76<br />CANTON: ISABELA","density: 1.226296e-07<br />TOTAL_VENTAS: 899587.92<br />CANTON: ISABELA","density: 1.228805e-07<br />TOTAL_VENTAS: 901535.08<br />CANTON: ISABELA","density: 1.228261e-07<br />TOTAL_VENTAS: 903482.24<br />CANTON: ISABELA","density: 1.223708e-07<br />TOTAL_VENTAS: 905429.40<br />CANTON: ISABELA","density: 1.216151e-07<br />TOTAL_VENTAS: 907376.56<br />CANTON: ISABELA","density: 1.205612e-07<br />TOTAL_VENTAS: 909323.72<br />CANTON: ISABELA","density: 1.192126e-07<br />TOTAL_VENTAS: 911270.88<br />CANTON: ISABELA","density: 1.175238e-07<br />TOTAL_VENTAS: 913218.04<br />CANTON: ISABELA","density: 1.155055e-07<br />TOTAL_VENTAS: 915165.20<br />CANTON: ISABELA","density: 1.132265e-07<br />TOTAL_VENTAS: 917112.36<br />CANTON: ISABELA","density: 1.106989e-07<br />TOTAL_VENTAS: 919059.52<br />CANTON: ISABELA","density: 1.079357e-07<br />TOTAL_VENTAS: 921006.68<br />CANTON: ISABELA","density: 1.048909e-07<br />TOTAL_VENTAS: 922953.84<br />CANTON: ISABELA","density: 1.016486e-07<br />TOTAL_VENTAS: 924901.00<br />CANTON: ISABELA","density: 9.823868e-08<br />TOTAL_VENTAS: 926848.16<br />CANTON: ISABELA","density: 9.467917e-08<br />TOTAL_VENTAS: 928795.32<br />CANTON: ISABELA","density: 9.098021e-08<br />TOTAL_VENTAS: 930742.48<br />CANTON: ISABELA","density: 8.715303e-08<br />TOTAL_VENTAS: 932689.64<br />CANTON: ISABELA","density: 8.325478e-08<br />TOTAL_VENTAS: 934636.80<br />CANTON: ISABELA","density: 7.930385e-08<br />TOTAL_VENTAS: 936583.96<br />CANTON: ISABELA","density: 7.531841e-08<br />TOTAL_VENTAS: 938531.12<br />CANTON: ISABELA","density: 7.132011e-08<br />TOTAL_VENTAS: 940478.28<br />CANTON: ISABELA","density: 6.734080e-08<br />TOTAL_VENTAS: 942425.44<br />CANTON: ISABELA","density: 6.339729e-08<br />TOTAL_VENTAS: 944372.60<br />CANTON: ISABELA","density: 5.950412e-08<br />TOTAL_VENTAS: 946319.76<br />CANTON: ISABELA","density: 5.567527e-08<br />TOTAL_VENTAS: 948266.92<br />CANTON: ISABELA","density: 5.196090e-08<br />TOTAL_VENTAS: 950214.08<br />CANTON: ISABELA","density: 4.834971e-08<br />TOTAL_VENTAS: 952161.24<br />CANTON: ISABELA","density: 4.484914e-08<br />TOTAL_VENTAS: 954108.40<br />CANTON: ISABELA","density: 4.146746e-08<br />TOTAL_VENTAS: 956055.56<br />CANTON: ISABELA","density: 3.822893e-08<br />TOTAL_VENTAS: 958002.72<br />CANTON: ISABELA","density: 3.516190e-08<br />TOTAL_VENTAS: 959949.88<br />CANTON: ISABELA","density: 3.223664e-08<br />TOTAL_VENTAS: 961897.04<br />CANTON: ISABELA","density: 2.945569e-08<br />TOTAL_VENTAS: 963844.20<br />CANTON: ISABELA","density: 2.682100e-08<br />TOTAL_VENTAS: 965791.36<br />CANTON: ISABELA","density: 2.437239e-08<br />TOTAL_VENTAS: 967738.52<br />CANTON: ISABELA","density: 2.208744e-08<br />TOTAL_VENTAS: 969685.68<br />CANTON: ISABELA","density: 1.994697e-08<br />TOTAL_VENTAS: 971632.84<br />CANTON: ISABELA","density: 1.794868e-08<br />TOTAL_VENTAS: 973580.00<br />CANTON: ISABELA","density: 1.609301e-08<br />TOTAL_VENTAS: 975527.16<br />CANTON: ISABELA","density: 1.441883e-08<br />TOTAL_VENTAS: 977474.32<br />CANTON: ISABELA","density: 1.287180e-08<br />TOTAL_VENTAS: 979421.48<br />CANTON: ISABELA","density: 1.144728e-08<br />TOTAL_VENTAS: 981368.64<br />CANTON: ISABELA","density: 1.014046e-08<br />TOTAL_VENTAS: 983315.80<br />CANTON: ISABELA","density: 8.963196e-09<br />TOTAL_VENTAS: 985262.96<br />CANTON: ISABELA","density: 7.911167e-09<br />TOTAL_VENTAS: 987210.12<br />CANTON: ISABELA","density: 6.954875e-09<br />TOTAL_VENTAS: 989157.28<br />CANTON: ISABELA","density: 6.089011e-09<br />TOTAL_VENTAS: 991104.44<br />CANTON: ISABELA","density: 5.308284e-09<br />TOTAL_VENTAS: 993051.60<br />CANTON: ISABELA","density: 4.628448e-09<br />TOTAL_VENTAS: 994998.76<br />CANTON: ISABELA","density: 4.628448e-09<br />TOTAL_VENTAS: 994998.76<br />CANTON: ISABELA","density: 5.308284e-09<br />TOTAL_VENTAS: 993051.60<br />CANTON: ISABELA","density: 6.089011e-09<br />TOTAL_VENTAS: 991104.44<br />CANTON: ISABELA","density: 6.954875e-09<br />TOTAL_VENTAS: 989157.28<br />CANTON: ISABELA","density: 7.911167e-09<br />TOTAL_VENTAS: 987210.12<br />CANTON: ISABELA","density: 8.963196e-09<br />TOTAL_VENTAS: 985262.96<br />CANTON: ISABELA","density: 1.014046e-08<br />TOTAL_VENTAS: 983315.80<br />CANTON: ISABELA","density: 1.144728e-08<br />TOTAL_VENTAS: 981368.64<br />CANTON: ISABELA","density: 1.287180e-08<br />TOTAL_VENTAS: 979421.48<br />CANTON: ISABELA","density: 1.441883e-08<br />TOTAL_VENTAS: 977474.32<br />CANTON: ISABELA","density: 1.609301e-08<br />TOTAL_VENTAS: 975527.16<br />CANTON: ISABELA","density: 1.794868e-08<br />TOTAL_VENTAS: 973580.00<br />CANTON: ISABELA","density: 1.994697e-08<br />TOTAL_VENTAS: 971632.84<br />CANTON: ISABELA","density: 2.208744e-08<br />TOTAL_VENTAS: 969685.68<br />CANTON: ISABELA","density: 2.437239e-08<br />TOTAL_VENTAS: 967738.52<br />CANTON: ISABELA","density: 2.682100e-08<br />TOTAL_VENTAS: 965791.36<br />CANTON: ISABELA","density: 2.945569e-08<br />TOTAL_VENTAS: 963844.20<br />CANTON: ISABELA","density: 3.223664e-08<br />TOTAL_VENTAS: 961897.04<br />CANTON: ISABELA","density: 3.516190e-08<br />TOTAL_VENTAS: 959949.88<br />CANTON: ISABELA","density: 3.822893e-08<br />TOTAL_VENTAS: 958002.72<br />CANTON: ISABELA","density: 4.146746e-08<br />TOTAL_VENTAS: 956055.56<br />CANTON: ISABELA","density: 4.484914e-08<br />TOTAL_VENTAS: 954108.40<br />CANTON: ISABELA","density: 4.834971e-08<br />TOTAL_VENTAS: 952161.24<br />CANTON: ISABELA","density: 5.196090e-08<br />TOTAL_VENTAS: 950214.08<br />CANTON: ISABELA","density: 5.567527e-08<br />TOTAL_VENTAS: 948266.92<br />CANTON: ISABELA","density: 5.950412e-08<br />TOTAL_VENTAS: 946319.76<br />CANTON: ISABELA","density: 6.339729e-08<br />TOTAL_VENTAS: 944372.60<br />CANTON: ISABELA","density: 6.734080e-08<br />TOTAL_VENTAS: 942425.44<br />CANTON: ISABELA","density: 7.132011e-08<br />TOTAL_VENTAS: 940478.28<br />CANTON: ISABELA","density: 7.531841e-08<br />TOTAL_VENTAS: 938531.12<br />CANTON: ISABELA","density: 7.930385e-08<br />TOTAL_VENTAS: 936583.96<br />CANTON: ISABELA","density: 8.325478e-08<br />TOTAL_VENTAS: 934636.80<br />CANTON: ISABELA","density: 8.715303e-08<br />TOTAL_VENTAS: 932689.64<br />CANTON: ISABELA","density: 9.098021e-08<br />TOTAL_VENTAS: 930742.48<br />CANTON: ISABELA","density: 9.467917e-08<br />TOTAL_VENTAS: 928795.32<br />CANTON: ISABELA","density: 9.823868e-08<br />TOTAL_VENTAS: 926848.16<br />CANTON: ISABELA","density: 1.016486e-07<br />TOTAL_VENTAS: 924901.00<br />CANTON: ISABELA","density: 1.048909e-07<br />TOTAL_VENTAS: 922953.84<br />CANTON: ISABELA","density: 1.079357e-07<br />TOTAL_VENTAS: 921006.68<br />CANTON: ISABELA","density: 1.106989e-07<br />TOTAL_VENTAS: 919059.52<br />CANTON: ISABELA","density: 1.132265e-07<br />TOTAL_VENTAS: 917112.36<br />CANTON: ISABELA","density: 1.155055e-07<br />TOTAL_VENTAS: 915165.20<br />CANTON: ISABELA","density: 1.175238e-07<br />TOTAL_VENTAS: 913218.04<br />CANTON: ISABELA","density: 1.192126e-07<br />TOTAL_VENTAS: 911270.88<br />CANTON: ISABELA","density: 1.205612e-07<br />TOTAL_VENTAS: 909323.72<br />CANTON: ISABELA","density: 1.216151e-07<br />TOTAL_VENTAS: 907376.56<br />CANTON: ISABELA","density: 1.223708e-07<br />TOTAL_VENTAS: 905429.40<br />CANTON: ISABELA","density: 1.228261e-07<br />TOTAL_VENTAS: 903482.24<br />CANTON: ISABELA","density: 1.228805e-07<br />TOTAL_VENTAS: 901535.08<br />CANTON: ISABELA","density: 1.226296e-07<br />TOTAL_VENTAS: 899587.92<br />CANTON: ISABELA","density: 1.220924e-07<br />TOTAL_VENTAS: 897640.76<br />CANTON: ISABELA","density: 1.212771e-07<br />TOTAL_VENTAS: 895693.60<br />CANTON: ISABELA","density: 1.201683e-07<br />TOTAL_VENTAS: 893746.44<br />CANTON: ISABELA","density: 1.187433e-07<br />TOTAL_VENTAS: 891799.28<br />CANTON: ISABELA","density: 1.170930e-07<br />TOTAL_VENTAS: 889852.12<br />CANTON: ISABELA","density: 1.152341e-07<br />TOTAL_VENTAS: 887904.96<br />CANTON: ISABELA","density: 1.131841e-07<br />TOTAL_VENTAS: 885957.80<br />CANTON: ISABELA","density: 1.109295e-07<br />TOTAL_VENTAS: 884010.64<br />CANTON: ISABELA","density: 1.085239e-07<br />TOTAL_VENTAS: 882063.48<br />CANTON: ISABELA","density: 1.060120e-07<br />TOTAL_VENTAS: 880116.32<br />CANTON: ISABELA","density: 1.034152e-07<br />TOTAL_VENTAS: 878169.16<br />CANTON: ISABELA","density: 1.007551e-07<br />TOTAL_VENTAS: 876222.00<br />CANTON: ISABELA","density: 9.805585e-08<br />TOTAL_VENTAS: 874274.84<br />CANTON: ISABELA","density: 9.536250e-08<br />TOTAL_VENTAS: 872327.68<br />CANTON: ISABELA","density: 9.269529e-08<br />TOTAL_VENTAS: 870380.52<br />CANTON: ISABELA","density: 9.007395e-08<br />TOTAL_VENTAS: 868433.36<br />CANTON: ISABELA","density: 8.753137e-08<br />TOTAL_VENTAS: 866486.20<br />CANTON: ISABELA","density: 8.510885e-08<br />TOTAL_VENTAS: 864539.04<br />CANTON: ISABELA","density: 8.280413e-08<br />TOTAL_VENTAS: 862591.88<br />CANTON: ISABELA","density: 8.063054e-08<br />TOTAL_VENTAS: 860644.72<br />CANTON: ISABELA","density: 7.860043e-08<br />TOTAL_VENTAS: 858697.56<br />CANTON: ISABELA","density: 7.677305e-08<br />TOTAL_VENTAS: 856750.40<br />CANTON: ISABELA","density: 7.513320e-08<br />TOTAL_VENTAS: 854803.24<br />CANTON: ISABELA","density: 7.366938e-08<br />TOTAL_VENTAS: 852856.08<br />CANTON: ISABELA","density: 7.238486e-08<br />TOTAL_VENTAS: 850908.92<br />CANTON: ISABELA","density: 7.128913e-08<br />TOTAL_VENTAS: 848961.76<br />CANTON: ISABELA","density: 7.043505e-08<br />TOTAL_VENTAS: 847014.60<br />CANTON: ISABELA","density: 6.975643e-08<br />TOTAL_VENTAS: 845067.44<br />CANTON: ISABELA","density: 6.924794e-08<br />TOTAL_VENTAS: 843120.28<br />CANTON: ISABELA","density: 6.890344e-08<br />TOTAL_VENTAS: 841173.12<br />CANTON: ISABELA","density: 6.874115e-08<br />TOTAL_VENTAS: 839225.96<br />CANTON: ISABELA","density: 6.874613e-08<br />TOTAL_VENTAS: 837278.80<br />CANTON: ISABELA","density: 6.887670e-08<br />TOTAL_VENTAS: 835331.64<br />CANTON: ISABELA","density: 6.912169e-08<br />TOTAL_VENTAS: 833384.48<br />CANTON: ISABELA","density: 6.946961e-08<br />TOTAL_VENTAS: 831437.32<br />CANTON: ISABELA","density: 6.992958e-08<br />TOTAL_VENTAS: 829490.16<br />CANTON: ISABELA","density: 7.045887e-08<br />TOTAL_VENTAS: 827543.00<br />CANTON: ISABELA","density: 7.104081e-08<br />TOTAL_VENTAS: 825595.84<br />CANTON: ISABELA","density: 7.166410e-08<br />TOTAL_VENTAS: 823648.68<br />CANTON: ISABELA","density: 7.231871e-08<br />TOTAL_VENTAS: 821701.52<br />CANTON: ISABELA","density: 7.299030e-08<br />TOTAL_VENTAS: 819754.36<br />CANTON: ISABELA","density: 7.366244e-08<br />TOTAL_VENTAS: 817807.20<br />CANTON: ISABELA","density: 7.432813e-08<br />TOTAL_VENTAS: 815860.04<br />CANTON: ISABELA","density: 7.498106e-08<br />TOTAL_VENTAS: 813912.88<br />CANTON: ISABELA","density: 7.561021e-08<br />TOTAL_VENTAS: 811965.72<br />CANTON: ISABELA","density: 7.621131e-08<br />TOTAL_VENTAS: 810018.56<br />CANTON: ISABELA","density: 7.678702e-08<br />TOTAL_VENTAS: 808071.40<br />CANTON: ISABELA","density: 7.733770e-08<br />TOTAL_VENTAS: 806124.24<br />CANTON: ISABELA","density: 7.786449e-08<br />TOTAL_VENTAS: 804177.08<br />CANTON: ISABELA","density: 7.836515e-08<br />TOTAL_VENTAS: 802229.92<br />CANTON: ISABELA","density: 7.885396e-08<br />TOTAL_VENTAS: 800282.76<br />CANTON: ISABELA","density: 7.933750e-08<br />TOTAL_VENTAS: 798335.60<br />CANTON: ISABELA","density: 7.982242e-08<br />TOTAL_VENTAS: 796388.44<br />CANTON: ISABELA","density: 8.031877e-08<br />TOTAL_VENTAS: 794441.28<br />CANTON: ISABELA","density: 8.084454e-08<br />TOTAL_VENTAS: 792494.12<br />CANTON: ISABELA","density: 8.140592e-08<br />TOTAL_VENTAS: 790546.96<br />CANTON: ISABELA","density: 8.201159e-08<br />TOTAL_VENTAS: 788599.80<br />CANTON: ISABELA","density: 8.267018e-08<br />TOTAL_VENTAS: 786652.64<br />CANTON: ISABELA","density: 8.341050e-08<br />TOTAL_VENTAS: 784705.48<br />CANTON: ISABELA","density: 8.423683e-08<br />TOTAL_VENTAS: 782758.32<br />CANTON: ISABELA","density: 8.514774e-08<br />TOTAL_VENTAS: 780811.16<br />CANTON: ISABELA","density: 8.614875e-08<br />TOTAL_VENTAS: 778864.00<br />CANTON: ISABELA","density: 8.724710e-08<br />TOTAL_VENTAS: 776916.84<br />CANTON: ISABELA","density: 8.848148e-08<br />TOTAL_VENTAS: 774969.68<br />CANTON: ISABELA","density: 8.981773e-08<br />TOTAL_VENTAS: 773022.52<br />CANTON: ISABELA","density: 9.125474e-08<br />TOTAL_VENTAS: 771075.36<br />CANTON: ISABELA","density: 9.279054e-08<br />TOTAL_VENTAS: 769128.20<br />CANTON: ISABELA","density: 9.443604e-08<br />TOTAL_VENTAS: 767181.04<br />CANTON: ISABELA","density: 9.618485e-08<br />TOTAL_VENTAS: 765233.88<br />CANTON: ISABELA","density: 9.800747e-08<br />TOTAL_VENTAS: 763286.72<br />CANTON: ISABELA","density: 9.989408e-08<br />TOTAL_VENTAS: 761339.56<br />CANTON: ISABELA","density: 1.018340e-07<br />TOTAL_VENTAS: 759392.40<br />CANTON: ISABELA","density: 1.038194e-07<br />TOTAL_VENTAS: 757445.24<br />CANTON: ISABELA","density: 1.058179e-07<br />TOTAL_VENTAS: 755498.08<br />CANTON: ISABELA","density: 1.078109e-07<br />TOTAL_VENTAS: 753550.92<br />CANTON: ISABELA","density: 1.097824e-07<br />TOTAL_VENTAS: 751603.76<br />CANTON: ISABELA","density: 1.117115e-07<br />TOTAL_VENTAS: 749656.60<br />CANTON: ISABELA","density: 1.135515e-07<br />TOTAL_VENTAS: 747709.44<br />CANTON: ISABELA","density: 1.152973e-07<br />TOTAL_VENTAS: 745762.28<br />CANTON: ISABELA","density: 1.169316e-07<br />TOTAL_VENTAS: 743815.12<br />CANTON: ISABELA","density: 1.184373e-07<br />TOTAL_VENTAS: 741867.96<br />CANTON: ISABELA","density: 1.197616e-07<br />TOTAL_VENTAS: 739920.80<br />CANTON: ISABELA","density: 1.208788e-07<br />TOTAL_VENTAS: 737973.64<br />CANTON: ISABELA","density: 1.218018e-07<br />TOTAL_VENTAS: 736026.48<br />CANTON: ISABELA","density: 1.225176e-07<br />TOTAL_VENTAS: 734079.32<br />CANTON: ISABELA","density: 1.230139e-07<br />TOTAL_VENTAS: 732132.16<br />CANTON: ISABELA","density: 1.231939e-07<br />TOTAL_VENTAS: 730185.00<br />CANTON: ISABELA","density: 1.231164e-07<br />TOTAL_VENTAS: 728237.84<br />CANTON: ISABELA","density: 1.227848e-07<br />TOTAL_VENTAS: 726290.68<br />CANTON: ISABELA","density: 1.221948e-07<br />TOTAL_VENTAS: 724343.52<br />CANTON: ISABELA","density: 1.213158e-07<br />TOTAL_VENTAS: 722396.36<br />CANTON: ISABELA","density: 1.201025e-07<br />TOTAL_VENTAS: 720449.20<br />CANTON: ISABELA","density: 1.186308e-07<br />TOTAL_VENTAS: 718502.04<br />CANTON: ISABELA","density: 1.169054e-07<br />TOTAL_VENTAS: 716554.88<br />CANTON: ISABELA","density: 1.149319e-07<br />TOTAL_VENTAS: 714607.72<br />CANTON: ISABELA","density: 1.126627e-07<br />TOTAL_VENTAS: 712660.56<br />CANTON: ISABELA","density: 1.101415e-07<br />TOTAL_VENTAS: 710713.40<br />CANTON: ISABELA","density: 1.074127e-07<br />TOTAL_VENTAS: 708766.24<br />CANTON: ISABELA","density: 1.044891e-07<br />TOTAL_VENTAS: 706819.08<br />CANTON: ISABELA","density: 1.013834e-07<br />TOTAL_VENTAS: 704871.92<br />CANTON: ISABELA","density: 9.806136e-08<br />TOTAL_VENTAS: 702924.76<br />CANTON: ISABELA","density: 9.460763e-08<br />TOTAL_VENTAS: 700977.60<br />CANTON: ISABELA","density: 9.103886e-08<br />TOTAL_VENTAS: 699030.44<br />CANTON: ISABELA","density: 8.737189e-08<br />TOTAL_VENTAS: 697083.28<br />CANTON: ISABELA","density: 8.361661e-08<br />TOTAL_VENTAS: 695136.12<br />CANTON: ISABELA","density: 7.980024e-08<br />TOTAL_VENTAS: 693188.96<br />CANTON: ISABELA","density: 7.595779e-08<br />TOTAL_VENTAS: 691241.80<br />CANTON: ISABELA","density: 7.210583e-08<br />TOTAL_VENTAS: 689294.64<br />CANTON: ISABELA","density: 6.826070e-08<br />TOTAL_VENTAS: 687347.48<br />CANTON: ISABELA","density: 6.445384e-08<br />TOTAL_VENTAS: 685400.32<br />CANTON: ISABELA","density: 6.070572e-08<br />TOTAL_VENTAS: 683453.16<br />CANTON: ISABELA","density: 5.702704e-08<br />TOTAL_VENTAS: 681506.00<br />CANTON: ISABELA","density: 5.343086e-08<br />TOTAL_VENTAS: 679558.84<br />CANTON: ISABELA","density: 4.993490e-08<br />TOTAL_VENTAS: 677611.68<br />CANTON: ISABELA","density: 4.659114e-08<br />TOTAL_VENTAS: 675664.52<br />CANTON: ISABELA","density: 4.337667e-08<br />TOTAL_VENTAS: 673717.36<br />CANTON: ISABELA","density: 4.030023e-08<br />TOTAL_VENTAS: 671770.20<br />CANTON: ISABELA","density: 3.737006e-08<br />TOTAL_VENTAS: 669823.04<br />CANTON: ISABELA","density: 3.462471e-08<br />TOTAL_VENTAS: 667875.88<br />CANTON: ISABELA","density: 3.207769e-08<br />TOTAL_VENTAS: 665928.72<br />CANTON: ISABELA","density: 2.970353e-08<br />TOTAL_VENTAS: 663981.56<br />CANTON: ISABELA","density: 2.750685e-08<br />TOTAL_VENTAS: 662034.40<br />CANTON: ISABELA","density: 2.549188e-08<br />TOTAL_VENTAS: 660087.24<br />CANTON: ISABELA","density: 2.372500e-08<br />TOTAL_VENTAS: 658140.08<br />CANTON: ISABELA","density: 2.216048e-08<br />TOTAL_VENTAS: 656192.92<br />CANTON: ISABELA","density: 2.079057e-08<br />TOTAL_VENTAS: 654245.76<br />CANTON: ISABELA","density: 1.961761e-08<br />TOTAL_VENTAS: 652298.60<br />CANTON: ISABELA","density: 1.866120e-08<br />TOTAL_VENTAS: 650351.44<br />CANTON: ISABELA","density: 1.796705e-08<br />TOTAL_VENTAS: 648404.28<br />CANTON: ISABELA","density: 1.747835e-08<br />TOTAL_VENTAS: 646457.12<br />CANTON: ISABELA","density: 1.719701e-08<br />TOTAL_VENTAS: 644509.96<br />CANTON: ISABELA","density: 1.712496e-08<br />TOTAL_VENTAS: 642562.80<br />CANTON: ISABELA","density: 1.731284e-08<br />TOTAL_VENTAS: 640615.64<br />CANTON: ISABELA","density: 1.774920e-08<br />TOTAL_VENTAS: 638668.48<br />CANTON: ISABELA","density: 1.840357e-08<br />TOTAL_VENTAS: 636721.32<br />CANTON: ISABELA","density: 1.927811e-08<br />TOTAL_VENTAS: 634774.16<br />CANTON: ISABELA","density: 2.037502e-08<br />TOTAL_VENTAS: 632827.00<br />CANTON: ISABELA","density: 2.178042e-08<br />TOTAL_VENTAS: 630879.84<br />CANTON: ISABELA","density: 2.341793e-08<br />TOTAL_VENTAS: 628932.68<br />CANTON: ISABELA","density: 2.528616e-08<br />TOTAL_VENTAS: 626985.52<br />CANTON: ISABELA","density: 2.738662e-08<br />TOTAL_VENTAS: 625038.36<br />CANTON: ISABELA","density: 2.975039e-08<br />TOTAL_VENTAS: 623091.20<br />CANTON: ISABELA","density: 3.240835e-08<br />TOTAL_VENTAS: 621144.04<br />CANTON: ISABELA","density: 3.530064e-08<br />TOTAL_VENTAS: 619196.88<br />CANTON: ISABELA","density: 3.842618e-08<br />TOTAL_VENTAS: 617249.72<br />CANTON: ISABELA","density: 4.178343e-08<br />TOTAL_VENTAS: 615302.56<br />CANTON: ISABELA","density: 4.542959e-08<br />TOTAL_VENTAS: 613355.40<br />CANTON: ISABELA","density: 4.932236e-08<br />TOTAL_VENTAS: 611408.24<br />CANTON: ISABELA","density: 5.342992e-08<br />TOTAL_VENTAS: 609461.08<br />CANTON: ISABELA","density: 5.774555e-08<br />TOTAL_VENTAS: 607513.92<br />CANTON: ISABELA","density: 6.226683e-08<br />TOTAL_VENTAS: 605566.76<br />CANTON: ISABELA","density: 6.703837e-08<br />TOTAL_VENTAS: 603619.60<br />CANTON: ISABELA","density: 7.197681e-08<br />TOTAL_VENTAS: 601672.44<br />CANTON: ISABELA","density: 7.706865e-08<br />TOTAL_VENTAS: 599725.28<br />CANTON: ISABELA","density: 8.229957e-08<br />TOTAL_VENTAS: 597778.12<br />CANTON: ISABELA","density: 8.766960e-08<br />TOTAL_VENTAS: 595830.96<br />CANTON: ISABELA","density: 9.314950e-08<br />TOTAL_VENTAS: 593883.80<br />CANTON: ISABELA","density: 9.869364e-08<br />TOTAL_VENTAS: 591936.64<br />CANTON: ISABELA","density: 1.042811e-07<br />TOTAL_VENTAS: 589989.48<br />CANTON: ISABELA","density: 1.098904e-07<br />TOTAL_VENTAS: 588042.32<br />CANTON: ISABELA","density: 1.154834e-07<br />TOTAL_VENTAS: 586095.16<br />CANTON: ISABELA","density: 1.210214e-07<br />TOTAL_VENTAS: 584148.00<br />CANTON: ISABELA","density: 1.264802e-07<br />TOTAL_VENTAS: 582200.84<br />CANTON: ISABELA","density: 1.318346e-07<br />TOTAL_VENTAS: 580253.68<br />CANTON: ISABELA","density: 1.370473e-07<br />TOTAL_VENTAS: 578306.52<br />CANTON: ISABELA","density: 1.420316e-07<br />TOTAL_VENTAS: 576359.36<br />CANTON: ISABELA","density: 1.468040e-07<br />TOTAL_VENTAS: 574412.20<br />CANTON: ISABELA","density: 1.513398e-07<br />TOTAL_VENTAS: 572465.04<br />CANTON: ISABELA","density: 1.556150e-07<br />TOTAL_VENTAS: 570517.88<br />CANTON: ISABELA","density: 1.595379e-07<br />TOTAL_VENTAS: 568570.72<br />CANTON: ISABELA","density: 1.630783e-07<br />TOTAL_VENTAS: 566623.56<br />CANTON: ISABELA","density: 1.662676e-07<br />TOTAL_VENTAS: 564676.40<br />CANTON: ISABELA","density: 1.690879e-07<br />TOTAL_VENTAS: 562729.24<br />CANTON: ISABELA","density: 1.715225e-07<br />TOTAL_VENTAS: 560782.08<br />CANTON: ISABELA","density: 1.734074e-07<br />TOTAL_VENTAS: 558834.92<br />CANTON: ISABELA","density: 1.748535e-07<br />TOTAL_VENTAS: 556887.76<br />CANTON: ISABELA","density: 1.758663e-07<br />TOTAL_VENTAS: 554940.60<br />CANTON: ISABELA","density: 1.764397e-07<br />TOTAL_VENTAS: 552993.44<br />CANTON: ISABELA","density: 1.765209e-07<br />TOTAL_VENTAS: 551046.28<br />CANTON: ISABELA","density: 1.760364e-07<br />TOTAL_VENTAS: 549099.12<br />CANTON: ISABELA","density: 1.751116e-07<br />TOTAL_VENTAS: 547151.96<br />CANTON: ISABELA","density: 1.737527e-07<br />TOTAL_VENTAS: 545204.80<br />CANTON: ISABELA","density: 1.719670e-07<br />TOTAL_VENTAS: 543257.64<br />CANTON: ISABELA","density: 1.696659e-07<br />TOTAL_VENTAS: 541310.48<br />CANTON: ISABELA","density: 1.669224e-07<br />TOTAL_VENTAS: 539363.32<br />CANTON: ISABELA","density: 1.638073e-07<br />TOTAL_VENTAS: 537416.16<br />CANTON: ISABELA","density: 1.603383e-07<br />TOTAL_VENTAS: 535469.00<br />CANTON: ISABELA","density: 1.565316e-07<br />TOTAL_VENTAS: 533521.84<br />CANTON: ISABELA","density: 1.523122e-07<br />TOTAL_VENTAS: 531574.68<br />CANTON: ISABELA","density: 1.478282e-07<br />TOTAL_VENTAS: 529627.52<br />CANTON: ISABELA","density: 1.431036e-07<br />TOTAL_VENTAS: 527680.36<br />CANTON: ISABELA","density: 1.381628e-07<br />TOTAL_VENTAS: 525733.20<br />CANTON: ISABELA","density: 1.330091e-07<br />TOTAL_VENTAS: 523786.04<br />CANTON: ISABELA","density: 1.276778e-07<br />TOTAL_VENTAS: 521838.88<br />CANTON: ISABELA","density: 1.222368e-07<br />TOTAL_VENTAS: 519891.72<br />CANTON: ISABELA","density: 1.167113e-07<br />TOTAL_VENTAS: 517944.56<br />CANTON: ISABELA","density: 1.111260e-07<br />TOTAL_VENTAS: 515997.40<br />CANTON: ISABELA","density: 1.055091e-07<br />TOTAL_VENTAS: 514050.24<br />CANTON: ISABELA","density: 9.990560e-08<br />TOTAL_VENTAS: 512103.08<br />CANTON: ISABELA","density: 9.433900e-08<br />TOTAL_VENTAS: 510155.92<br />CANTON: ISABELA","density: 8.882972e-08<br />TOTAL_VENTAS: 508208.76<br />CANTON: ISABELA","density: 8.340285e-08<br />TOTAL_VENTAS: 506261.60<br />CANTON: ISABELA","density: 7.811843e-08<br />TOTAL_VENTAS: 504314.44<br />CANTON: ISABELA","density: 7.296501e-08<br />TOTAL_VENTAS: 502367.28<br />CANTON: ISABELA","density: 6.795625e-08<br />TOTAL_VENTAS: 500420.12<br />CANTON: ISABELA","density: 6.310496e-08<br />TOTAL_VENTAS: 498472.96<br />CANTON: ISABELA","density: 5.845862e-08<br />TOTAL_VENTAS: 496525.80<br />CANTON: ISABELA","density: 5.403478e-08<br />TOTAL_VENTAS: 494578.64<br />CANTON: ISABELA","density: 4.980718e-08<br />TOTAL_VENTAS: 492631.48<br />CANTON: ISABELA","density: 4.578155e-08<br />TOTAL_VENTAS: 490684.32<br />CANTON: ISABELA","density: 4.196287e-08<br />TOTAL_VENTAS: 488737.16<br />CANTON: ISABELA","density: 3.842633e-08<br />TOTAL_VENTAS: 486790.00<br />CANTON: ISABELA","density: 3.511539e-08<br />TOTAL_VENTAS: 484842.84<br />CANTON: ISABELA","density: 3.201974e-08<br />TOTAL_VENTAS: 482895.68<br />CANTON: ISABELA","density: 2.913919e-08<br />TOTAL_VENTAS: 480948.52<br />CANTON: ISABELA","density: 2.649221e-08<br />TOTAL_VENTAS: 479001.36<br />CANTON: ISABELA","density: 2.411782e-08<br />TOTAL_VENTAS: 477054.20<br />CANTON: ISABELA","density: 2.195126e-08<br />TOTAL_VENTAS: 475107.04<br />CANTON: ISABELA","density: 1.998970e-08<br />TOTAL_VENTAS: 473159.88<br />CANTON: ISABELA","density: 1.823021e-08<br />TOTAL_VENTAS: 471212.72<br />CANTON: ISABELA","density: 1.671414e-08<br />TOTAL_VENTAS: 469265.56<br />CANTON: ISABELA","density: 1.541953e-08<br />TOTAL_VENTAS: 467318.40<br />CANTON: ISABELA","density: 1.431389e-08<br />TOTAL_VENTAS: 465371.24<br />CANTON: ISABELA","density: 1.339443e-08<br />TOTAL_VENTAS: 463424.08<br />CANTON: ISABELA","density: 1.265847e-08<br />TOTAL_VENTAS: 461476.92<br />CANTON: ISABELA","density: 1.216929e-08<br />TOTAL_VENTAS: 459529.76<br />CANTON: ISABELA","density: 1.185905e-08<br />TOTAL_VENTAS: 457582.60<br />CANTON: ISABELA","density: 1.172519e-08<br />TOTAL_VENTAS: 455635.44<br />CANTON: ISABELA","density: 1.176702e-08<br />TOTAL_VENTAS: 453688.28<br />CANTON: ISABELA","density: 1.200729e-08<br />TOTAL_VENTAS: 451741.12<br />CANTON: ISABELA","density: 1.246766e-08<br />TOTAL_VENTAS: 449793.96<br />CANTON: ISABELA","density: 1.310608e-08<br />TOTAL_VENTAS: 447846.80<br />CANTON: ISABELA","density: 1.392442e-08<br />TOTAL_VENTAS: 445899.64<br />CANTON: ISABELA","density: 1.492483e-08<br />TOTAL_VENTAS: 443952.48<br />CANTON: ISABELA","density: 1.616175e-08<br />TOTAL_VENTAS: 442005.32<br />CANTON: ISABELA","density: 1.761089e-08<br />TOTAL_VENTAS: 440058.16<br />CANTON: ISABELA","density: 1.925609e-08<br />TOTAL_VENTAS: 438111.00<br />CANTON: ISABELA","density: 2.110154e-08<br />TOTAL_VENTAS: 436163.84<br />CANTON: ISABELA","density: 2.315836e-08<br />TOTAL_VENTAS: 434216.68<br />CANTON: ISABELA","density: 2.550174e-08<br />TOTAL_VENTAS: 432269.52<br />CANTON: ISABELA","density: 2.806540e-08<br />TOTAL_VENTAS: 430322.36<br />CANTON: ISABELA","density: 3.085442e-08<br />TOTAL_VENTAS: 428375.20<br />CANTON: ISABELA","density: 3.387384e-08<br />TOTAL_VENTAS: 426428.04<br />CANTON: ISABELA","density: 3.717083e-08<br />TOTAL_VENTAS: 424480.88<br />CANTON: ISABELA","density: 4.076342e-08<br />TOTAL_VENTAS: 422533.72<br />CANTON: ISABELA","density: 4.460676e-08<br />TOTAL_VENTAS: 420586.56<br />CANTON: ISABELA","density: 4.870508e-08<br />TOTAL_VENTAS: 418639.40<br />CANTON: ISABELA","density: 5.306241e-08<br />TOTAL_VENTAS: 416692.24<br />CANTON: ISABELA","density: 5.776658e-08<br />TOTAL_VENTAS: 414745.08<br />CANTON: ISABELA","density: 6.275785e-08<br />TOTAL_VENTAS: 412797.92<br />CANTON: ISABELA","density: 6.802020e-08<br />TOTAL_VENTAS: 410850.76<br />CANTON: ISABELA","density: 7.355520e-08<br />TOTAL_VENTAS: 408903.60<br />CANTON: ISABELA","density: 7.938389e-08<br />TOTAL_VENTAS: 406956.44<br />CANTON: ISABELA","density: 8.557086e-08<br />TOTAL_VENTAS: 405009.28<br />CANTON: ISABELA","density: 9.203035e-08<br />TOTAL_VENTAS: 403062.12<br />CANTON: ISABELA","density: 9.876035e-08<br />TOTAL_VENTAS: 401114.96<br />CANTON: ISABELA","density: 1.057584e-07<br />TOTAL_VENTAS: 399167.80<br />CANTON: ISABELA","density: 1.130763e-07<br />TOTAL_VENTAS: 397220.64<br />CANTON: ISABELA","density: 1.206937e-07<br />TOTAL_VENTAS: 395273.48<br />CANTON: ISABELA","density: 1.285604e-07<br />TOTAL_VENTAS: 393326.32<br />CANTON: ISABELA","density: 1.366703e-07<br />TOTAL_VENTAS: 391379.16<br />CANTON: ISABELA","density: 1.450166e-07<br />TOTAL_VENTAS: 389432.00<br />CANTON: ISABELA","density: 1.536664e-07<br />TOTAL_VENTAS: 387484.84<br />CANTON: ISABELA","density: 1.625324e-07<br />TOTAL_VENTAS: 385537.68<br />CANTON: ISABELA","density: 1.715991e-07<br />TOTAL_VENTAS: 383590.52<br />CANTON: ISABELA","density: 1.808569e-07<br />TOTAL_VENTAS: 381643.36<br />CANTON: ISABELA","density: 1.903144e-07<br />TOTAL_VENTAS: 379696.20<br />CANTON: ISABELA","density: 1.999783e-07<br />TOTAL_VENTAS: 377749.04<br />CANTON: ISABELA","density: 2.097903e-07<br />TOTAL_VENTAS: 375801.88<br />CANTON: ISABELA","density: 2.197400e-07<br />TOTAL_VENTAS: 373854.72<br />CANTON: ISABELA","density: 2.298176e-07<br />TOTAL_VENTAS: 371907.56<br />CANTON: ISABELA","density: 2.400382e-07<br />TOTAL_VENTAS: 369960.40<br />CANTON: ISABELA","density: 2.503711e-07<br />TOTAL_VENTAS: 368013.24<br />CANTON: ISABELA","density: 2.607945e-07<br />TOTAL_VENTAS: 366066.08<br />CANTON: ISABELA","density: 2.713014e-07<br />TOTAL_VENTAS: 364118.92<br />CANTON: ISABELA","density: 2.818864e-07<br />TOTAL_VENTAS: 362171.76<br />CANTON: ISABELA","density: 2.925666e-07<br />TOTAL_VENTAS: 360224.60<br />CANTON: ISABELA","density: 3.033126e-07<br />TOTAL_VENTAS: 358277.44<br />CANTON: ISABELA","density: 3.141241e-07<br />TOTAL_VENTAS: 356330.28<br />CANTON: ISABELA","density: 3.250020e-07<br />TOTAL_VENTAS: 354383.12<br />CANTON: ISABELA","density: 3.359597e-07<br />TOTAL_VENTAS: 352435.96<br />CANTON: ISABELA","density: 3.470123e-07<br />TOTAL_VENTAS: 350488.80<br />CANTON: ISABELA","density: 3.581529e-07<br />TOTAL_VENTAS: 348541.64<br />CANTON: ISABELA","density: 3.693913e-07<br />TOTAL_VENTAS: 346594.48<br />CANTON: ISABELA","density: 3.807385e-07<br />TOTAL_VENTAS: 344647.32<br />CANTON: ISABELA","density: 3.922514e-07<br />TOTAL_VENTAS: 342700.16<br />CANTON: ISABELA","density: 4.039308e-07<br />TOTAL_VENTAS: 340753.00<br />CANTON: ISABELA","density: 4.157837e-07<br />TOTAL_VENTAS: 338805.84<br />CANTON: ISABELA","density: 4.278290e-07<br />TOTAL_VENTAS: 336858.68<br />CANTON: ISABELA","density: 4.400994e-07<br />TOTAL_VENTAS: 334911.52<br />CANTON: ISABELA","density: 4.526977e-07<br />TOTAL_VENTAS: 332964.36<br />CANTON: ISABELA","density: 4.655764e-07<br />TOTAL_VENTAS: 331017.20<br />CANTON: ISABELA","density: 4.787572e-07<br />TOTAL_VENTAS: 329070.04<br />CANTON: ISABELA","density: 4.922620e-07<br />TOTAL_VENTAS: 327122.88<br />CANTON: ISABELA","density: 5.061873e-07<br />TOTAL_VENTAS: 325175.72<br />CANTON: ISABELA","density: 5.205682e-07<br />TOTAL_VENTAS: 323228.56<br />CANTON: ISABELA","density: 5.353572e-07<br />TOTAL_VENTAS: 321281.40<br />CANTON: ISABELA","density: 5.505705e-07<br />TOTAL_VENTAS: 319334.24<br />CANTON: ISABELA","density: 5.662235e-07<br />TOTAL_VENTAS: 317387.08<br />CANTON: ISABELA","density: 5.824883e-07<br />TOTAL_VENTAS: 315439.92<br />CANTON: ISABELA","density: 5.992460e-07<br />TOTAL_VENTAS: 313492.76<br />CANTON: ISABELA","density: 6.164788e-07<br />TOTAL_VENTAS: 311545.60<br />CANTON: ISABELA","density: 6.341879e-07<br />TOTAL_VENTAS: 309598.44<br />CANTON: ISABELA","density: 6.524167e-07<br />TOTAL_VENTAS: 307651.28<br />CANTON: ISABELA","density: 6.712400e-07<br />TOTAL_VENTAS: 305704.12<br />CANTON: ISABELA","density: 6.905071e-07<br />TOTAL_VENTAS: 303756.96<br />CANTON: ISABELA","density: 7.101996e-07<br />TOTAL_VENTAS: 301809.80<br />CANTON: ISABELA","density: 7.302970e-07<br />TOTAL_VENTAS: 299862.64<br />CANTON: ISABELA","density: 7.508515e-07<br />TOTAL_VENTAS: 297915.48<br />CANTON: ISABELA","density: 7.717714e-07<br />TOTAL_VENTAS: 295968.32<br />CANTON: ISABELA","density: 7.929647e-07<br />TOTAL_VENTAS: 294021.16<br />CANTON: ISABELA","density: 8.143908e-07<br />TOTAL_VENTAS: 292074.00<br />CANTON: ISABELA","density: 8.360066e-07<br />TOTAL_VENTAS: 290126.84<br />CANTON: ISABELA","density: 8.577778e-07<br />TOTAL_VENTAS: 288179.68<br />CANTON: ISABELA","density: 8.795775e-07<br />TOTAL_VENTAS: 286232.52<br />CANTON: ISABELA","density: 9.013488e-07<br />TOTAL_VENTAS: 284285.36<br />CANTON: ISABELA","density: 9.230343e-07<br />TOTAL_VENTAS: 282338.20<br />CANTON: ISABELA","density: 9.445400e-07<br />TOTAL_VENTAS: 280391.04<br />CANTON: ISABELA","density: 9.657252e-07<br />TOTAL_VENTAS: 278443.88<br />CANTON: ISABELA","density: 9.865653e-07<br />TOTAL_VENTAS: 276496.72<br />CANTON: ISABELA","density: 1.006997e-06<br />TOTAL_VENTAS: 274549.56<br />CANTON: ISABELA","density: 1.026958e-06<br />TOTAL_VENTAS: 272602.40<br />CANTON: ISABELA","density: 1.046201e-06<br />TOTAL_VENTAS: 270655.24<br />CANTON: ISABELA","density: 1.064717e-06<br />TOTAL_VENTAS: 268708.08<br />CANTON: ISABELA","density: 1.082507e-06<br />TOTAL_VENTAS: 266760.92<br />CANTON: ISABELA","density: 1.099513e-06<br />TOTAL_VENTAS: 264813.76<br />CANTON: ISABELA","density: 1.115650e-06<br />TOTAL_VENTAS: 262866.60<br />CANTON: ISABELA","density: 1.130551e-06<br />TOTAL_VENTAS: 260919.44<br />CANTON: ISABELA","density: 1.144468e-06<br />TOTAL_VENTAS: 258972.28<br />CANTON: ISABELA","density: 1.157361e-06<br />TOTAL_VENTAS: 257025.12<br />CANTON: ISABELA","density: 1.169198e-06<br />TOTAL_VENTAS: 255077.96<br />CANTON: ISABELA","density: 1.179749e-06<br />TOTAL_VENTAS: 253130.80<br />CANTON: ISABELA","density: 1.188944e-06<br />TOTAL_VENTAS: 251183.64<br />CANTON: ISABELA","density: 1.196997e-06<br />TOTAL_VENTAS: 249236.48<br />CANTON: ISABELA","density: 1.203903e-06<br />TOTAL_VENTAS: 247289.32<br />CANTON: ISABELA","density: 1.209661e-06<br />TOTAL_VENTAS: 245342.16<br />CANTON: ISABELA","density: 1.213921e-06<br />TOTAL_VENTAS: 243395.00<br />CANTON: ISABELA","density: 1.217003e-06<br />TOTAL_VENTAS: 241447.84<br />CANTON: ISABELA","density: 1.219006e-06<br />TOTAL_VENTAS: 239500.68<br />CANTON: ISABELA","density: 1.219962e-06<br />TOTAL_VENTAS: 237553.52<br />CANTON: ISABELA","density: 1.219834e-06<br />TOTAL_VENTAS: 235606.36<br />CANTON: ISABELA","density: 1.218491e-06<br />TOTAL_VENTAS: 233659.20<br />CANTON: ISABELA","density: 1.216298e-06<br />TOTAL_VENTAS: 231712.04<br />CANTON: ISABELA","density: 1.213316e-06<br />TOTAL_VENTAS: 229764.88<br />CANTON: ISABELA","density: 1.209610e-06<br />TOTAL_VENTAS: 227817.72<br />CANTON: ISABELA","density: 1.205136e-06<br />TOTAL_VENTAS: 225870.56<br />CANTON: ISABELA","density: 1.200071e-06<br />TOTAL_VENTAS: 223923.40<br />CANTON: ISABELA","density: 1.194599e-06<br />TOTAL_VENTAS: 221976.24<br />CANTON: ISABELA","density: 1.188804e-06<br />TOTAL_VENTAS: 220029.08<br />CANTON: ISABELA","density: 1.182768e-06<br />TOTAL_VENTAS: 218081.92<br />CANTON: ISABELA","density: 1.176592e-06<br />TOTAL_VENTAS: 216134.76<br />CANTON: ISABELA","density: 1.170453e-06<br />TOTAL_VENTAS: 214187.60<br />CANTON: ISABELA","density: 1.164441e-06<br />TOTAL_VENTAS: 212240.44<br />CANTON: ISABELA","density: 1.158640e-06<br />TOTAL_VENTAS: 210293.28<br />CANTON: ISABELA","density: 1.153187e-06<br />TOTAL_VENTAS: 208346.12<br />CANTON: ISABELA","density: 1.148293e-06<br />TOTAL_VENTAS: 206398.96<br />CANTON: ISABELA","density: 1.143948e-06<br />TOTAL_VENTAS: 204451.80<br />CANTON: ISABELA","density: 1.140224e-06<br />TOTAL_VENTAS: 202504.64<br />CANTON: ISABELA","density: 1.137189e-06<br />TOTAL_VENTAS: 200557.48<br />CANTON: ISABELA","density: 1.135132e-06<br />TOTAL_VENTAS: 198610.32<br />CANTON: ISABELA","density: 1.134045e-06<br />TOTAL_VENTAS: 196663.16<br />CANTON: ISABELA","density: 1.133877e-06<br />TOTAL_VENTAS: 194716.00<br />CANTON: ISABELA","density: 1.134668e-06<br />TOTAL_VENTAS: 192768.84<br />CANTON: ISABELA","density: 1.136473e-06<br />TOTAL_VENTAS: 190821.68<br />CANTON: ISABELA","density: 1.139689e-06<br />TOTAL_VENTAS: 188874.52<br />CANTON: ISABELA","density: 1.143968e-06<br />TOTAL_VENTAS: 186927.36<br />CANTON: ISABELA","density: 1.149314e-06<br />TOTAL_VENTAS: 184980.20<br />CANTON: ISABELA","density: 1.155728e-06<br />TOTAL_VENTAS: 183033.04<br />CANTON: ISABELA","density: 1.163375e-06<br />TOTAL_VENTAS: 181085.88<br />CANTON: ISABELA","density: 1.172293e-06<br />TOTAL_VENTAS: 179138.72<br />CANTON: ISABELA","density: 1.182219e-06<br />TOTAL_VENTAS: 177191.56<br />CANTON: ISABELA","density: 1.193126e-06<br />TOTAL_VENTAS: 175244.40<br />CANTON: ISABELA","density: 1.204981e-06<br />TOTAL_VENTAS: 173297.24<br />CANTON: ISABELA","density: 1.217992e-06<br />TOTAL_VENTAS: 171350.08<br />CANTON: ISABELA","density: 1.231887e-06<br />TOTAL_VENTAS: 169402.92<br />CANTON: ISABELA","density: 1.246544e-06<br />TOTAL_VENTAS: 167455.76<br />CANTON: ISABELA","density: 1.261911e-06<br />TOTAL_VENTAS: 165508.60<br />CANTON: ISABELA","density: 1.277966e-06<br />TOTAL_VENTAS: 163561.44<br />CANTON: ISABELA","density: 1.294760e-06<br />TOTAL_VENTAS: 161614.28<br />CANTON: ISABELA","density: 1.312023e-06<br />TOTAL_VENTAS: 159667.12<br />CANTON: ISABELA","density: 1.329700e-06<br />TOTAL_VENTAS: 157719.96<br />CANTON: ISABELA","density: 1.347730e-06<br />TOTAL_VENTAS: 155772.80<br />CANTON: ISABELA","density: 1.366093e-06<br />TOTAL_VENTAS: 153825.64<br />CANTON: ISABELA","density: 1.384680e-06<br />TOTAL_VENTAS: 151878.48<br />CANTON: ISABELA","density: 1.403388e-06<br />TOTAL_VENTAS: 149931.32<br />CANTON: ISABELA","density: 1.422169e-06<br />TOTAL_VENTAS: 147984.16<br />CANTON: ISABELA","density: 1.440976e-06<br />TOTAL_VENTAS: 146037.00<br />CANTON: ISABELA","density: 1.459729e-06<br />TOTAL_VENTAS: 144089.84<br />CANTON: ISABELA","density: 1.478380e-06<br />TOTAL_VENTAS: 142142.68<br />CANTON: ISABELA","density: 1.496902e-06<br />TOTAL_VENTAS: 140195.52<br />CANTON: ISABELA","density: 1.515269e-06<br />TOTAL_VENTAS: 138248.36<br />CANTON: ISABELA","density: 1.533439e-06<br />TOTAL_VENTAS: 136301.20<br />CANTON: ISABELA","density: 1.551355e-06<br />TOTAL_VENTAS: 134354.04<br />CANTON: ISABELA","density: 1.569066e-06<br />TOTAL_VENTAS: 132406.88<br />CANTON: ISABELA","density: 1.586578e-06<br />TOTAL_VENTAS: 130459.72<br />CANTON: ISABELA","density: 1.603901e-06<br />TOTAL_VENTAS: 128512.56<br />CANTON: ISABELA","density: 1.621019e-06<br />TOTAL_VENTAS: 126565.40<br />CANTON: ISABELA","density: 1.638002e-06<br />TOTAL_VENTAS: 124618.24<br />CANTON: ISABELA","density: 1.654917e-06<br />TOTAL_VENTAS: 122671.08<br />CANTON: ISABELA","density: 1.671812e-06<br />TOTAL_VENTAS: 120723.92<br />CANTON: ISABELA","density: 1.688743e-06<br />TOTAL_VENTAS: 118776.76<br />CANTON: ISABELA","density: 1.705873e-06<br />TOTAL_VENTAS: 116829.60<br />CANTON: ISABELA","density: 1.723280e-06<br />TOTAL_VENTAS: 114882.44<br />CANTON: ISABELA","density: 1.741062e-06<br />TOTAL_VENTAS: 112935.28<br />CANTON: ISABELA","density: 1.759323e-06<br />TOTAL_VENTAS: 110988.12<br />CANTON: ISABELA","density: 1.778290e-06<br />TOTAL_VENTAS: 109040.96<br />CANTON: ISABELA","density: 1.798284e-06<br />TOTAL_VENTAS: 107093.80<br />CANTON: ISABELA","density: 1.819311e-06<br />TOTAL_VENTAS: 105146.64<br />CANTON: ISABELA","density: 1.841533e-06<br />TOTAL_VENTAS: 103199.48<br />CANTON: ISABELA","density: 1.865117e-06<br />TOTAL_VENTAS: 101252.32<br />CANTON: ISABELA","density: 1.890786e-06<br />TOTAL_VENTAS: 99305.16<br />CANTON: ISABELA","density: 1.918597e-06<br />TOTAL_VENTAS: 97358.00<br />CANTON: ISABELA","density: 1.948606e-06<br />TOTAL_VENTAS: 95410.84<br />CANTON: ISABELA","density: 1.981037e-06<br />TOTAL_VENTAS: 93463.68<br />CANTON: ISABELA","density: 2.016242e-06<br />TOTAL_VENTAS: 91516.52<br />CANTON: ISABELA","density: 2.055539e-06<br />TOTAL_VENTAS: 89569.36<br />CANTON: ISABELA","density: 2.098278e-06<br />TOTAL_VENTAS: 87622.20<br />CANTON: ISABELA","density: 2.144714e-06<br />TOTAL_VENTAS: 85675.04<br />CANTON: ISABELA","density: 2.195105e-06<br />TOTAL_VENTAS: 83727.88<br />CANTON: ISABELA","density: 2.250557e-06<br />TOTAL_VENTAS: 81780.72<br />CANTON: ISABELA","density: 2.311632e-06<br />TOTAL_VENTAS: 79833.56<br />CANTON: ISABELA","density: 2.377714e-06<br />TOTAL_VENTAS: 77886.40<br />CANTON: ISABELA","density: 2.449029e-06<br />TOTAL_VENTAS: 75939.24<br />CANTON: ISABELA","density: 2.525797e-06<br />TOTAL_VENTAS: 73992.08<br />CANTON: ISABELA","density: 2.610162e-06<br />TOTAL_VENTAS: 72044.92<br />CANTON: ISABELA","density: 2.700884e-06<br />TOTAL_VENTAS: 70097.76<br />CANTON: ISABELA","density: 2.797740e-06<br />TOTAL_VENTAS: 68150.60<br />CANTON: ISABELA","density: 2.900821e-06<br />TOTAL_VENTAS: 66203.44<br />CANTON: ISABELA","density: 3.010715e-06<br />TOTAL_VENTAS: 64256.28<br />CANTON: ISABELA","density: 3.128791e-06<br />TOTAL_VENTAS: 62309.12<br />CANTON: ISABELA","density: 3.253070e-06<br />TOTAL_VENTAS: 60361.96<br />CANTON: ISABELA","density: 3.383420e-06<br />TOTAL_VENTAS: 58414.80<br />CANTON: ISABELA","density: 3.519675e-06<br />TOTAL_VENTAS: 56467.64<br />CANTON: ISABELA","density: 3.662772e-06<br />TOTAL_VENTAS: 54520.48<br />CANTON: ISABELA","density: 3.811764e-06<br />TOTAL_VENTAS: 52573.32<br />CANTON: ISABELA","density: 3.965337e-06<br />TOTAL_VENTAS: 50626.16<br />CANTON: ISABELA","density: 4.123028e-06<br />TOTAL_VENTAS: 48679.00<br />CANTON: ISABELA","density: 4.284335e-06<br />TOTAL_VENTAS: 46731.84<br />CANTON: ISABELA","density: 4.449301e-06<br />TOTAL_VENTAS: 44784.68<br />CANTON: ISABELA","density: 4.615892e-06<br />TOTAL_VENTAS: 42837.52<br />CANTON: ISABELA","density: 4.783303e-06<br />TOTAL_VENTAS: 40890.36<br />CANTON: ISABELA","density: 4.950752e-06<br />TOTAL_VENTAS: 38943.20<br />CANTON: ISABELA","density: 5.117132e-06<br />TOTAL_VENTAS: 36996.04<br />CANTON: ISABELA","density: 5.280524e-06<br />TOTAL_VENTAS: 35048.88<br />CANTON: ISABELA","density: 5.440225e-06<br />TOTAL_VENTAS: 33101.72<br />CANTON: ISABELA","density: 5.595288e-06<br />TOTAL_VENTAS: 31154.56<br />CANTON: ISABELA","density: 5.744754e-06<br />TOTAL_VENTAS: 29207.40<br />CANTON: ISABELA","density: 5.885420e-06<br />TOTAL_VENTAS: 27260.24<br />CANTON: ISABELA","density: 6.016581e-06<br />TOTAL_VENTAS: 25313.08<br />CANTON: ISABELA","density: 6.138141e-06<br />TOTAL_VENTAS: 23365.92<br />CANTON: ISABELA","density: 6.249206e-06<br />TOTAL_VENTAS: 21418.76<br />CANTON: ISABELA","density: 6.348616e-06<br />TOTAL_VENTAS: 19471.60<br />CANTON: ISABELA","density: 6.430819e-06<br />TOTAL_VENTAS: 17524.44<br />CANTON: ISABELA","density: 6.499234e-06<br />TOTAL_VENTAS: 15577.28<br />CANTON: ISABELA","density: 6.553264e-06<br />TOTAL_VENTAS: 13630.12<br />CANTON: ISABELA","density: 6.592360e-06<br />TOTAL_VENTAS: 11682.96<br />CANTON: ISABELA","density: 6.613395e-06<br />TOTAL_VENTAS: 9735.80<br />CANTON: ISABELA","density: 6.614892e-06<br />TOTAL_VENTAS: 7788.64<br />CANTON: ISABELA","density: 6.600085e-06<br />TOTAL_VENTAS: 5841.48<br />CANTON: ISABELA","density: 6.568905e-06<br />TOTAL_VENTAS: 3894.32<br />CANTON: ISABELA","density: 6.521343e-06<br />TOTAL_VENTAS: 1947.16<br />CANTON: ISABELA","density: 6.452670e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: ISABELA","density: 6.452670e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: ISABELA"],"type":"scatter","mode":"lines","line":{"width":null,"color":"rgba(0,0,0,0.4)","dash":"solid"},"fill":"toself","fillcolor":"rgba(248,118,109,0.4)","hoveron":"points","name":"ISABELA","legendgroup":"ISABELA","showlegend":true,"xaxis":"x","yaxis":"y","hoverinfo":"text","frame":null},{"x":[0,1947.16,3894.32,5841.48,7788.64,9735.8,11682.96,13630.12,15577.28,17524.44,19471.6,21418.76,23365.92,25313.08,27260.24,29207.4,31154.56,33101.72,35048.88,36996.04,38943.2,40890.36,42837.52,44784.68,46731.84,48679,50626.16,52573.32,54520.48,56467.64,58414.8,60361.96,62309.12,64256.28,66203.44,68150.6,70097.76,72044.92,73992.08,75939.24,77886.4,79833.56,81780.72,83727.88,85675.04,87622.2,89569.36,91516.52,93463.68,95410.84,97358,99305.16,101252.32,103199.48,105146.64,107093.8,109040.96,110988.12,112935.28,114882.44,116829.6,118776.76,120723.92,122671.08,124618.24,126565.4,128512.56,130459.72,132406.88,134354.04,136301.2,138248.36,140195.52,142142.68,144089.84,146037,147984.16,149931.32,151878.48,153825.64,155772.8,157719.96,159667.12,161614.28,163561.44,165508.6,167455.76,169402.92,171350.08,173297.24,175244.4,177191.56,179138.72,181085.88,183033.04,184980.2,186927.36,188874.52,190821.68,192768.84,194716,196663.16,198610.32,200557.48,202504.64,204451.8,206398.96,208346.12,210293.28,212240.44,214187.6,216134.76,218081.92,220029.08,221976.24,223923.4,225870.56,227817.72,229764.88,231712.04,233659.2,235606.36,237553.52,239500.68,241447.84,243395,245342.16,247289.32,249236.48,251183.64,253130.8,255077.96,257025.12,258972.28,260919.44,262866.6,264813.76,266760.92,268708.08,270655.24,272602.4,274549.56,276496.72,278443.88,280391.04,282338.2,284285.36,286232.52,288179.68,290126.84,292074,294021.16,295968.32,297915.48,299862.64,301809.8,303756.96,305704.12,307651.28,309598.44,311545.6,313492.76,315439.92,317387.08,319334.24,321281.4,323228.56,325175.72,327122.88,329070.04,331017.2,332964.36,334911.52,336858.68,338805.84,340753,342700.16,344647.32,346594.48,348541.64,350488.8,352435.96,354383.12,356330.28,358277.44,360224.6,362171.76,364118.92,366066.08,368013.24,369960.4,371907.56,373854.72,375801.88,377749.04,379696.2,381643.36,383590.52,385537.68,387484.84,389432,391379.16,393326.32,395273.48,397220.64,399167.8,401114.96,403062.12,405009.28,406956.44,408903.6,410850.76,412797.92,414745.08,416692.24,418639.4,420586.56,422533.72,424480.88,426428.04,428375.2,430322.36,432269.52,434216.68,436163.84,438111,440058.16,442005.32,443952.48,445899.64,447846.8,449793.96,451741.12,453688.28,455635.44,457582.6,459529.76,461476.92,463424.08,465371.24,467318.4,469265.56,471212.72,473159.88,475107.04,477054.2,479001.36,480948.52,482895.68,484842.84,486790,488737.16,490684.32,492631.48,494578.64,496525.8,498472.96,500420.12,502367.28,504314.44,506261.6,508208.76,510155.92,512103.08,514050.24,515997.4,517944.56,519891.72,521838.88,523786.04,525733.2,527680.36,529627.52,531574.68,533521.84,535469,537416.16,539363.32,541310.48,543257.64,545204.8,547151.96,549099.12,551046.28,552993.44,554940.6,556887.76,558834.92,560782.08,562729.24,564676.4,566623.56,568570.72,570517.88,572465.04,574412.2,576359.36,578306.52,580253.68,582200.84,584148,586095.16,588042.32,589989.48,591936.64,593883.8,595830.96,597778.12,599725.28,601672.44,603619.6,605566.76,607513.92,609461.08,611408.24,613355.4,615302.56,617249.72,619196.88,621144.04,623091.2,625038.36,626985.52,628932.68,630879.84,632827,634774.16,636721.32,638668.48,640615.64,642562.8,644509.96,646457.12,648404.28,650351.44,652298.6,654245.76,656192.92,658140.08,660087.24,662034.4,663981.56,665928.72,667875.88,669823.04,671770.2,673717.36,675664.52,677611.68,679558.84,681506,683453.16,685400.32,687347.48,689294.64,691241.8,693188.96,695136.12,697083.28,699030.44,700977.6,702924.76,704871.92,706819.08,708766.24,710713.4,712660.56,714607.72,716554.88,718502.04,720449.2,722396.36,724343.52,726290.68,728237.84,730185,732132.16,734079.32,736026.48,737973.64,739920.8,741867.96,743815.12,745762.28,747709.44,749656.6,751603.76,753550.92,755498.08,757445.24,759392.4,761339.56,763286.72,765233.88,767181.04,769128.2,771075.36,773022.52,774969.68,776916.84,778864,780811.16,782758.32,784705.48,786652.64,788599.8,790546.96,792494.12,794441.28,796388.44,798335.6,800282.76,802229.92,804177.08,806124.24,808071.4,810018.56,811965.72,813912.88,815860.04,817807.2,819754.36,821701.52,823648.68,825595.84,827543,829490.16,831437.32,833384.48,835331.64,837278.8,839225.96,841173.12,843120.28,845067.44,847014.6,848961.76,850908.92,852856.08,854803.24,856750.4,858697.56,860644.72,862591.88,864539.04,866486.2,868433.36,870380.52,872327.68,874274.84,876222,878169.16,880116.32,882063.48,884010.64,885957.8,887904.96,889852.12,891799.28,893746.44,895693.6,897640.76,899587.92,901535.08,903482.24,905429.4,907376.56,909323.72,911270.88,913218.04,915165.2,917112.36,919059.52,921006.68,922953.84,924901,926848.16,928795.32,930742.48,932689.64,934636.8,936583.96,938531.12,940478.28,942425.44,944372.6,946319.76,948266.92,950214.08,952161.24,954108.4,956055.56,958002.72,959949.88,961897.04,963844.2,965791.36,967738.52,969685.68,971632.84,973580,975527.16,977474.32,979421.48,981368.64,983315.8,985262.96,987210.12,989157.28,991104.44,993051.6,994998.76,994998.76,993051.6,991104.44,989157.28,987210.12,985262.96,983315.8,981368.64,979421.48,977474.32,975527.16,973580,971632.84,969685.68,967738.52,965791.36,963844.2,961897.04,959949.88,958002.72,956055.56,954108.4,952161.24,950214.08,948266.92,946319.76,944372.6,942425.44,940478.28,938531.12,936583.96,934636.8,932689.64,930742.48,928795.32,926848.16,924901,922953.84,921006.68,919059.52,917112.36,915165.2,913218.04,911270.88,909323.72,907376.56,905429.4,903482.24,901535.08,899587.92,897640.76,895693.6,893746.44,891799.28,889852.12,887904.96,885957.8,884010.64,882063.48,880116.32,878169.16,876222,874274.84,872327.68,870380.52,868433.36,866486.2,864539.04,862591.88,860644.72,858697.56,856750.4,854803.24,852856.08,850908.92,848961.76,847014.6,845067.44,843120.28,841173.12,839225.96,837278.8,835331.64,833384.48,831437.32,829490.16,827543,825595.84,823648.68,821701.52,819754.36,817807.2,815860.04,813912.88,811965.72,810018.56,808071.4,806124.24,804177.08,802229.92,800282.76,798335.6,796388.44,794441.28,792494.12,790546.96,788599.8,786652.64,784705.48,782758.32,780811.16,778864,776916.84,774969.68,773022.52,771075.36,769128.2,767181.04,765233.88,763286.72,761339.56,759392.4,757445.24,755498.08,753550.92,751603.76,749656.6,747709.44,745762.28,743815.12,741867.96,739920.8,737973.64,736026.48,734079.32,732132.16,730185,728237.84,726290.68,724343.52,722396.36,720449.2,718502.04,716554.88,714607.72,712660.56,710713.4,708766.24,706819.08,704871.92,702924.76,700977.6,699030.44,697083.28,695136.12,693188.96,691241.8,689294.64,687347.48,685400.32,683453.16,681506,679558.84,677611.68,675664.52,673717.36,671770.2,669823.04,667875.88,665928.72,663981.56,662034.4,660087.24,658140.08,656192.92,654245.76,652298.6,650351.44,648404.28,646457.12,644509.96,642562.8,640615.64,638668.48,636721.32,634774.16,632827,630879.84,628932.68,626985.52,625038.36,623091.2,621144.04,619196.88,617249.72,615302.56,613355.4,611408.24,609461.08,607513.92,605566.76,603619.6,601672.44,599725.28,597778.12,595830.96,593883.8,591936.64,589989.48,588042.32,586095.16,584148,582200.84,580253.68,578306.52,576359.36,574412.2,572465.04,570517.88,568570.72,566623.56,564676.4,562729.24,560782.08,558834.92,556887.76,554940.6,552993.44,551046.28,549099.12,547151.96,545204.8,543257.64,541310.48,539363.32,537416.16,535469,533521.84,531574.68,529627.52,527680.36,525733.2,523786.04,521838.88,519891.72,517944.56,515997.4,514050.24,512103.08,510155.92,508208.76,506261.6,504314.44,502367.28,500420.12,498472.96,496525.8,494578.64,492631.48,490684.32,488737.16,486790,484842.84,482895.68,480948.52,479001.36,477054.2,475107.04,473159.88,471212.72,469265.56,467318.4,465371.24,463424.08,461476.92,459529.76,457582.6,455635.44,453688.28,451741.12,449793.96,447846.8,445899.64,443952.48,442005.32,440058.16,438111,436163.84,434216.68,432269.52,430322.36,428375.2,426428.04,424480.88,422533.72,420586.56,418639.4,416692.24,414745.08,412797.92,410850.76,408903.6,406956.44,405009.28,403062.12,401114.96,399167.8,397220.64,395273.48,393326.32,391379.16,389432,387484.84,385537.68,383590.52,381643.36,379696.2,377749.04,375801.88,373854.72,371907.56,369960.4,368013.24,366066.08,364118.92,362171.76,360224.6,358277.44,356330.28,354383.12,352435.96,350488.8,348541.64,346594.48,344647.32,342700.16,340753,338805.84,336858.68,334911.52,332964.36,331017.2,329070.04,327122.88,325175.72,323228.56,321281.4,319334.24,317387.08,315439.92,313492.76,311545.6,309598.44,307651.28,305704.12,303756.96,301809.8,299862.64,297915.48,295968.32,294021.16,292074,290126.84,288179.68,286232.52,284285.36,282338.2,280391.04,278443.88,276496.72,274549.56,272602.4,270655.24,268708.08,266760.92,264813.76,262866.6,260919.44,258972.28,257025.12,255077.96,253130.8,251183.64,249236.48,247289.32,245342.16,243395,241447.84,239500.68,237553.52,235606.36,233659.2,231712.04,229764.88,227817.72,225870.56,223923.4,221976.24,220029.08,218081.92,216134.76,214187.6,212240.44,210293.28,208346.12,206398.96,204451.8,202504.64,200557.48,198610.32,196663.16,194716,192768.84,190821.68,188874.52,186927.36,184980.2,183033.04,181085.88,179138.72,177191.56,175244.4,173297.24,171350.08,169402.92,167455.76,165508.6,163561.44,161614.28,159667.12,157719.96,155772.8,153825.64,151878.48,149931.32,147984.16,146037,144089.84,142142.68,140195.52,138248.36,136301.2,134354.04,132406.88,130459.72,128512.56,126565.4,124618.24,122671.08,120723.92,118776.76,116829.6,114882.44,112935.28,110988.12,109040.96,107093.8,105146.64,103199.48,101252.32,99305.16,97358,95410.84,93463.68,91516.52,89569.36,87622.2,85675.04,83727.88,81780.72,79833.56,77886.4,75939.24,73992.08,72044.92,70097.76,68150.6,66203.44,64256.28,62309.12,60361.96,58414.8,56467.64,54520.48,52573.32,50626.16,48679,46731.84,44784.68,42837.52,40890.36,38943.2,36996.04,35048.88,33101.72,31154.56,29207.4,27260.24,25313.08,23365.92,21418.76,19471.6,17524.44,15577.28,13630.12,11682.96,9735.8,7788.64,5841.48,3894.32,1947.16,0,0],"y":[0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,5.68606383384519e-10,6.31061089363951e-10,6.98118940885623e-10,7.74217169590097e-10,8.5691878468985e-10,9.4554163585822e-10,1.04509760369803e-09,1.15358293486429e-09,1.26960177060479e-09,1.3986798005534e-09,1.53965841880506e-09,1.69011704340101e-09,1.85597790085684e-09,2.03747867358395e-09,2.23077841964396e-09,2.44200925187275e-09,2.67351692292815e-09,2.91954899066683e-09,3.18617892180022e-09,3.47875151053069e-09,3.78900732668014e-09,4.12259976911236e-09,4.48895632731211e-09,4.87660518420831e-09,5.2903170723565e-09,5.74488452845318e-09,6.22480710665089e-09,6.73340485758694e-09,7.29231245813561e-09,7.88107881595543e-09,8.50090100901916e-09,9.18191139274742e-09,9.89769276967053e-09,1.06484474337664e-08,1.14689177586282e-08,1.23313231938088e-08,1.32339862690605e-08,1.42125781312039e-08,1.52424094924439e-08,1.63180541614322e-08,1.74753536492129e-08,1.86942761745831e-08,1.99647371523591e-08,2.13218793237641e-08,2.27520090820962e-08,2.42394480901428e-08,2.5817686673285e-08,2.74811012414827e-08,2.92074983094065e-08,3.10277124937407e-08,3.29458963285584e-08,3.49324798668065e-08,3.70146314564111e-08,3.92078725308144e-08,4.14745061110996e-08,4.38370644970239e-08,4.63238233511932e-08,4.88883714844167e-08,5.15477273913756e-08,5.43440033760759e-08,5.72217018541366e-08,6.01915932689458e-08,6.33103150231244e-08,6.65131731971638e-08,6.98041479819031e-08,7.32546157511472e-08,7.67908781498714e-08,8.04129778934028e-08,8.41972234109194e-08,8.8070916187649e-08,9.20308688101469e-08,9.61456900139252e-08,1.00356273848364e-07,1.04652291067713e-07,1.09093901369214e-07,1.13636046829118e-07,1.18261509604758e-07,1.23021542508067e-07,1.2788503688044e-07,1.32828438826256e-07,1.37893947838069e-07,1.43063734627043e-07,1.48308757098327e-07,1.5366233225789e-07,1.59118676606648e-07,1.6464438655064e-07,1.70264377056569e-07,1.75983143040796e-07,1.8176429770491e-07,1.87625124474842e-07,1.93578144279598e-07,1.99585581451661e-07,2.0565811936717e-07,2.11813630440093e-07,2.18014719646277e-07,2.24266727153487e-07,2.30589851977428e-07,2.36948981368177e-07,2.43345555269853e-07,2.497987996067e-07,2.56277875219854e-07,2.62782372072212e-07,2.69325660108511e-07,2.75884598593319e-07,2.82458294047651e-07,2.89050239167314e-07,2.95647441343669e-07,3.02248401064274e-07,3.0884832169727e-07,3.15441121693667e-07,3.22026462150519e-07,3.28592961578484e-07,3.35138053729114e-07,3.41664364123924e-07,3.48155713389992e-07,3.54609565493639e-07,3.61033319274429e-07,3.67407835542461e-07,3.73727101483897e-07,3.80005071238204e-07,3.86221504481809e-07,3.92363450802721e-07,3.98453141006781e-07,4.0447108140317e-07,4.10394040751437e-07,4.16254150248176e-07,4.22034465325145e-07,4.27698324824001e-07,4.33289245163301e-07,4.38794549881646e-07,4.44161274844903e-07,4.4944562238595e-07,4.54640777608311e-07,4.59674961639193e-07,4.64618131658067e-07,4.6946995925604e-07,4.7414018051727e-07,4.78710901863383e-07,4.83182652020503e-07,4.87468051090213e-07,4.91638911703361e-07,4.95704266106258e-07,4.99581499765169e-07,5.03329408029628e-07,5.06966479561531e-07,5.10416521529405e-07,5.13723067133558e-07,5.16914727711224e-07,5.19923118116066e-07,5.22774799451598e-07,5.25508866354321e-07,5.2806582365301e-07,5.30454116861724e-07,5.32723375677176e-07,5.348237559409e-07,5.36745012880174e-07,5.38547068335008e-07,5.40190169275814e-07,5.41645346703719e-07,5.4298230821149e-07,5.441715293157e-07,5.45165767812119e-07,5.46043792777856e-07,5.46786176851574e-07,5.47328263466444e-07,5.47756996286247e-07,5.48062689966789e-07,5.48164451408027e-07,5.48156407835268e-07,5.48038087689486e-07,5.47713769391613e-07,5.47283722995433e-07,5.46748121024576e-07,5.46021728074153e-07,5.45186156927116e-07,5.44249515032059e-07,5.43138392119483e-07,5.41915039330111e-07,5.40595386316872e-07,5.39117236013885e-07,5.3752482767782e-07,5.3584112739573e-07,5.34014487796787e-07,5.32072637415974e-07,5.30044746947975e-07,5.27889029115265e-07,5.25618340033827e-07,5.23267165992875e-07,5.20802868265588e-07,5.18225226950374e-07,5.15573067445048e-07,5.12822149242641e-07,5.09961184065602e-07,5.07032226176728e-07,5.04018609171261e-07,5.00900273295502e-07,4.9772120069181e-07,4.94471353001871e-07,4.91124577230314e-07,4.87725230913309e-07,4.8426878104099e-07,4.80726133795409e-07,4.77140161502573e-07,4.73510483465625e-07,4.69808770701951e-07,4.66074197365965e-07,4.62307209309397e-07,4.58489644606602e-07,4.54649297260945e-07,4.50788387002167e-07,4.4690029642279e-07,4.43002021630955e-07,4.39096372358576e-07,4.35187050813079e-07,4.3128367057191e-07,4.27387383406807e-07,4.23510613120168e-07,4.19659575786506e-07,4.15831231585774e-07,4.12044749656486e-07,4.08307445432577e-07,4.04609325112874e-07,4.00973976537204e-07,3.9741470222145e-07,3.93911654955984e-07,3.90490227624298e-07,3.87174802567326e-07,3.83932769012534e-07,3.80788523308505e-07,3.77782577660656e-07,3.74866795015337e-07,3.72061718259932e-07,3.69428695342177e-07,3.66901632147317e-07,3.64494466818578e-07,3.62293403187562e-07,3.60212493625305e-07,3.58256607344434e-07,3.56539775858525e-07,3.54955044786502e-07,3.53502824298817e-07,3.52306749956458e-07,3.51258439494617e-07,3.5035151965714e-07,3.4970228266104e-07,3.49218606984525e-07,3.48881706630247e-07,3.48797010907038e-07,3.48892175986244e-07,3.49135527893822e-07,3.49618810070243e-07,3.50291437512293e-07,3.51109344761966e-07,3.52148649887185e-07,3.53380737195671e-07,3.54750700395579e-07,3.5631811664767e-07,3.5807464917221e-07,3.59957173219977e-07,3.62008912560761e-07,3.64238215040471e-07,3.66577373871713e-07,3.69054556118025e-07,3.71689434904419e-07,3.74414233455213e-07,3.77244394614533e-07,3.80204077277418e-07,3.83230603826353e-07,3.86329907911957e-07,3.89522737799119e-07,3.92757050004683e-07,3.96033139673211e-07,3.99359932635685e-07,4.02701570622964e-07,4.06056993407725e-07,4.0941487190781e-07,4.1276084565462e-07,4.16093844677134e-07,4.19383432791717e-07,4.22632492694874e-07,4.25842917812605e-07,4.28970751698272e-07,4.32027723957996e-07,4.35022654814046e-07,4.37903789078973e-07,4.40683743983626e-07,4.4338157532093e-07,4.4594319524382e-07,4.48375218033862e-07,4.50709285622655e-07,4.52893824160962e-07,4.54924175125342e-07,4.56845716279042e-07,4.58613304050046e-07,4.60207785829868e-07,4.61688063577353e-07,4.63018174715793e-07,4.64163568288063e-07,4.65195034731381e-07,4.66087234981545e-07,4.66791718383458e-07,4.67388147297768e-07,4.67861899918852e-07,4.68154421752001e-07,4.6834999926518e-07,4.68443536027305e-07,4.68372175183919e-07,4.68219596427053e-07,4.67986487024373e-07,4.67617311805405e-07,4.67184986938609e-07,4.66691804412227e-07,4.66105077757467e-07,4.65473599382908e-07,4.64803590477602e-07,4.64082738953837e-07,4.63340801922182e-07,4.62584154849471e-07,4.61817297929399e-07,4.61057290002591e-07,4.60306671548952e-07,4.59582468083118e-07,4.58895964735902e-07,4.58242027328652e-07,4.57645583391837e-07,4.57118981914928e-07,4.56646074173601e-07,4.56255115732997e-07,4.55965633160713e-07,4.55747933392341e-07,4.55629431060008e-07,4.55641668318137e-07,4.55739935254308e-07,4.5594734321775e-07,4.56310585809533e-07,4.56769686294815e-07,4.57340924886855e-07,4.58087310337829e-07,4.58934641692849e-07,4.59890914758602e-07,4.61034551158024e-07,4.62279428861805e-07,4.63625496648525e-07,4.65161995862632e-07,4.66796027527764e-07,4.68526721689223e-07,4.7042835147873e-07,4.72426768442512e-07,4.74513262655354e-07,4.76746104111803e-07,4.79069974970484e-07,4.81469999263475e-07,4.83988737813558e-07,4.86587946427256e-07,4.89248952100669e-07,4.92000039837879e-07,4.9481687604619e-07,4.97679766524846e-07,5.00605029244421e-07,5.03578215691508e-07,5.06581461485787e-07,5.09621983955439e-07,5.12690948420539e-07,5.15774893627395e-07,5.18875011242598e-07,5.21984211408298e-07,5.25095380043074e-07,5.28206609529529e-07,5.31309726091373e-07,5.34404948646614e-07,5.37489704317934e-07,5.4055353777896e-07,5.43603740539328e-07,5.4663870451998e-07,5.49646639114542e-07,5.5264016887847e-07,5.55619211736195e-07,5.58574144143335e-07,5.61519536383806e-07,5.64455749240811e-07,5.6738278408126e-07,5.70310920014033e-07,5.73241250762833e-07,5.76186602826417e-07,5.79152236936226e-07,5.82137930504133e-07,5.8517083015885e-07,5.88253501165245e-07,5.91380740363064e-07,5.94593994403327e-07,5.97898356557838e-07,6.0127844233586e-07,6.0478839652496e-07,6.08444022361804e-07,6.12213040777419e-07,6.16159098857867e-07,6.20319807846315e-07,6.24637837198987e-07,6.29181581377817e-07,6.34024341187512e-07,6.39074241994049e-07,6.44398187132862e-07,6.50121616367275e-07,6.56107426416917e-07,6.62413419729868e-07,6.69235894987101e-07,6.76380823890484e-07,6.83888076042926e-07,6.92045414889974e-07,7.00589400400916e-07,7.09532105290259e-07,7.19274763713456e-07,7.29471519330309e-07,7.40125094298868e-07,7.51685683771248e-07,7.63799137711894e-07,7.76439149941733e-07,7.90065996435379e-07,8.04366000075126e-07,8.19263148555703e-07,8.35216280819304e-07,8.51973453923575e-07,8.6939766747316e-07,8.87933923580089e-07,9.07413507546921e-07,9.27627507460691e-07,9.4899418313976e-07,9.71448794723264e-07,9.94700533882548e-07,1.01912798959954e-06,1.0447892080878e-06,1.07130313440093e-06,1.09899633551617e-06,1.12806511690629e-06,1.15803227525047e-06,1.18916130381389e-06,1.22179729573332e-06,1.25536436812026e-06,1.29005402500079e-06,1.32636395408296e-06,1.36362144022903e-06,1.40194014984694e-06,1.44196556544339e-06,1.48293542122977e-06,1.52488375425175e-06,1.56858853339804e-06,1.61321170694933e-06,1.65875169473928e-06,1.70596908463853e-06,1.75409351111995e-06,1.80308104734807e-06,1.85355911932906e-06,1.90492884646088e-06,1.95707901422119e-06,2.0104960498596e-06,2.06474225551025e-06,2.11965522603666e-06,2.17557888711759e-06,2.23221360622942e-06,2.28936924192638e-06,2.34725295491514e-06,2.40566634352706e-06,2.46442256359513e-06,2.52360559507562e-06,2.58306751359449e-06,2.64266318073236e-06,2.70237503934115e-06,2.76204162727402e-06,2.82160458462142e-06,2.88097424955758e-06,2.93989998541715e-06,2.99846067471438e-06,3.05653095678787e-06,3.11368645090516e-06,3.17019727864369e-06,3.22594437134739e-06,3.28023983331499e-06,3.33360013088347e-06,3.385958116052e-06,3.43627208682607e-06,3.48535814969613e-06,3.53320483906283e-06,3.57846046297367e-06,3.62215977574448e-06,3.66433516965911e-06,3.70355067785722e-06,3.74079906473061e-06,3.77625742082944e-06,3.80846713225739e-06,3.83828724775106e-06,3.86608004466098e-06,3.89042535340492e-06,3.91196467781665e-06,3.93127816256199e-06,3.94704119793348e-06,3.95960755547045e-06,3.96979725255886e-06,3.97643104501561e-06,3.9795236426853e-06,3.98014384108176e-06,3.97729727479366e-06,3.97063138097081e-06,3.96145777720091e-06,3.94899379956576e-06,3.93251744483539e-06,3.9135614236865e-06,3.89156728913e-06,3.86546876786547e-06,3.83698223202721e-06,3.80577096578619e-06,3.77047642137085e-06,3.73294661073237e-06,0],"text":["density: 3.732947e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: SAN CRISTOBAL","density: 3.770476e-06<br />TOTAL_VENTAS: 1947.16<br />CANTON: SAN CRISTOBAL","density: 3.805771e-06<br />TOTAL_VENTAS: 3894.32<br />CANTON: SAN CRISTOBAL","density: 3.836982e-06<br />TOTAL_VENTAS: 5841.48<br />CANTON: SAN CRISTOBAL","density: 3.865469e-06<br />TOTAL_VENTAS: 7788.64<br />CANTON: SAN CRISTOBAL","density: 3.891567e-06<br />TOTAL_VENTAS: 9735.80<br />CANTON: SAN CRISTOBAL","density: 3.913561e-06<br />TOTAL_VENTAS: 11682.96<br />CANTON: SAN CRISTOBAL","density: 3.932517e-06<br />TOTAL_VENTAS: 13630.12<br />CANTON: SAN CRISTOBAL","density: 3.948994e-06<br />TOTAL_VENTAS: 15577.28<br />CANTON: SAN CRISTOBAL","density: 3.961458e-06<br />TOTAL_VENTAS: 17524.44<br />CANTON: SAN CRISTOBAL","density: 3.970631e-06<br />TOTAL_VENTAS: 19471.60<br />CANTON: SAN CRISTOBAL","density: 3.977297e-06<br />TOTAL_VENTAS: 21418.76<br />CANTON: SAN CRISTOBAL","density: 3.980144e-06<br />TOTAL_VENTAS: 23365.92<br />CANTON: SAN CRISTOBAL","density: 3.979524e-06<br />TOTAL_VENTAS: 25313.08<br />CANTON: SAN CRISTOBAL","density: 3.976431e-06<br />TOTAL_VENTAS: 27260.24<br />CANTON: SAN CRISTOBAL","density: 3.969797e-06<br />TOTAL_VENTAS: 29207.40<br />CANTON: SAN CRISTOBAL","density: 3.959608e-06<br />TOTAL_VENTAS: 31154.56<br />CANTON: SAN CRISTOBAL","density: 3.947041e-06<br />TOTAL_VENTAS: 33101.72<br />CANTON: SAN CRISTOBAL","density: 3.931278e-06<br />TOTAL_VENTAS: 35048.88<br />CANTON: SAN CRISTOBAL","density: 3.911965e-06<br />TOTAL_VENTAS: 36996.04<br />CANTON: SAN CRISTOBAL","density: 3.890425e-06<br />TOTAL_VENTAS: 38943.20<br />CANTON: SAN CRISTOBAL","density: 3.866080e-06<br />TOTAL_VENTAS: 40890.36<br />CANTON: SAN CRISTOBAL","density: 3.838287e-06<br />TOTAL_VENTAS: 42837.52<br />CANTON: SAN CRISTOBAL","density: 3.808467e-06<br />TOTAL_VENTAS: 44784.68<br />CANTON: SAN CRISTOBAL","density: 3.776257e-06<br />TOTAL_VENTAS: 46731.84<br />CANTON: SAN CRISTOBAL","density: 3.740799e-06<br />TOTAL_VENTAS: 48679.00<br />CANTON: SAN CRISTOBAL","density: 3.703551e-06<br />TOTAL_VENTAS: 50626.16<br />CANTON: SAN CRISTOBAL","density: 3.664335e-06<br />TOTAL_VENTAS: 52573.32<br />CANTON: SAN CRISTOBAL","density: 3.622160e-06<br />TOTAL_VENTAS: 54520.48<br />CANTON: SAN CRISTOBAL","density: 3.578460e-06<br />TOTAL_VENTAS: 56467.64<br />CANTON: SAN CRISTOBAL","density: 3.533205e-06<br />TOTAL_VENTAS: 58414.80<br />CANTON: SAN CRISTOBAL","density: 3.485358e-06<br />TOTAL_VENTAS: 60361.96<br />CANTON: SAN CRISTOBAL","density: 3.436272e-06<br />TOTAL_VENTAS: 62309.12<br />CANTON: SAN CRISTOBAL","density: 3.385958e-06<br />TOTAL_VENTAS: 64256.28<br />CANTON: SAN CRISTOBAL","density: 3.333600e-06<br />TOTAL_VENTAS: 66203.44<br />CANTON: SAN CRISTOBAL","density: 3.280240e-06<br />TOTAL_VENTAS: 68150.60<br />CANTON: SAN CRISTOBAL","density: 3.225944e-06<br />TOTAL_VENTAS: 70097.76<br />CANTON: SAN CRISTOBAL","density: 3.170197e-06<br />TOTAL_VENTAS: 72044.92<br />CANTON: SAN CRISTOBAL","density: 3.113686e-06<br />TOTAL_VENTAS: 73992.08<br />CANTON: SAN CRISTOBAL","density: 3.056531e-06<br />TOTAL_VENTAS: 75939.24<br />CANTON: SAN CRISTOBAL","density: 2.998461e-06<br />TOTAL_VENTAS: 77886.40<br />CANTON: SAN CRISTOBAL","density: 2.939900e-06<br />TOTAL_VENTAS: 79833.56<br />CANTON: SAN CRISTOBAL","density: 2.880974e-06<br />TOTAL_VENTAS: 81780.72<br />CANTON: SAN CRISTOBAL","density: 2.821605e-06<br />TOTAL_VENTAS: 83727.88<br />CANTON: SAN CRISTOBAL","density: 2.762042e-06<br />TOTAL_VENTAS: 85675.04<br />CANTON: SAN CRISTOBAL","density: 2.702375e-06<br />TOTAL_VENTAS: 87622.20<br />CANTON: SAN CRISTOBAL","density: 2.642663e-06<br />TOTAL_VENTAS: 89569.36<br />CANTON: SAN CRISTOBAL","density: 2.583068e-06<br />TOTAL_VENTAS: 91516.52<br />CANTON: SAN CRISTOBAL","density: 2.523606e-06<br />TOTAL_VENTAS: 93463.68<br />CANTON: SAN CRISTOBAL","density: 2.464423e-06<br />TOTAL_VENTAS: 95410.84<br />CANTON: SAN CRISTOBAL","density: 2.405666e-06<br />TOTAL_VENTAS: 97358.00<br />CANTON: SAN CRISTOBAL","density: 2.347253e-06<br />TOTAL_VENTAS: 99305.16<br />CANTON: SAN CRISTOBAL","density: 2.289369e-06<br />TOTAL_VENTAS: 101252.32<br />CANTON: SAN CRISTOBAL","density: 2.232214e-06<br />TOTAL_VENTAS: 103199.48<br />CANTON: SAN CRISTOBAL","density: 2.175579e-06<br />TOTAL_VENTAS: 105146.64<br />CANTON: SAN CRISTOBAL","density: 2.119655e-06<br />TOTAL_VENTAS: 107093.80<br />CANTON: SAN CRISTOBAL","density: 2.064742e-06<br />TOTAL_VENTAS: 109040.96<br />CANTON: SAN CRISTOBAL","density: 2.010496e-06<br />TOTAL_VENTAS: 110988.12<br />CANTON: SAN CRISTOBAL","density: 1.957079e-06<br />TOTAL_VENTAS: 112935.28<br />CANTON: SAN CRISTOBAL","density: 1.904929e-06<br />TOTAL_VENTAS: 114882.44<br />CANTON: SAN CRISTOBAL","density: 1.853559e-06<br />TOTAL_VENTAS: 116829.60<br />CANTON: SAN CRISTOBAL","density: 1.803081e-06<br />TOTAL_VENTAS: 118776.76<br />CANTON: SAN CRISTOBAL","density: 1.754094e-06<br />TOTAL_VENTAS: 120723.92<br />CANTON: SAN CRISTOBAL","density: 1.705969e-06<br />TOTAL_VENTAS: 122671.08<br />CANTON: SAN CRISTOBAL","density: 1.658752e-06<br />TOTAL_VENTAS: 124618.24<br />CANTON: SAN CRISTOBAL","density: 1.613212e-06<br />TOTAL_VENTAS: 126565.40<br />CANTON: SAN CRISTOBAL","density: 1.568589e-06<br />TOTAL_VENTAS: 128512.56<br />CANTON: SAN CRISTOBAL","density: 1.524884e-06<br />TOTAL_VENTAS: 130459.72<br />CANTON: SAN CRISTOBAL","density: 1.482935e-06<br />TOTAL_VENTAS: 132406.88<br />CANTON: SAN CRISTOBAL","density: 1.441966e-06<br />TOTAL_VENTAS: 134354.04<br />CANTON: SAN CRISTOBAL","density: 1.401940e-06<br />TOTAL_VENTAS: 136301.20<br />CANTON: SAN CRISTOBAL","density: 1.363621e-06<br />TOTAL_VENTAS: 138248.36<br />CANTON: SAN CRISTOBAL","density: 1.326364e-06<br />TOTAL_VENTAS: 140195.52<br />CANTON: SAN CRISTOBAL","density: 1.290054e-06<br />TOTAL_VENTAS: 142142.68<br />CANTON: SAN CRISTOBAL","density: 1.255364e-06<br />TOTAL_VENTAS: 144089.84<br />CANTON: SAN CRISTOBAL","density: 1.221797e-06<br />TOTAL_VENTAS: 146037.00<br />CANTON: SAN CRISTOBAL","density: 1.189161e-06<br />TOTAL_VENTAS: 147984.16<br />CANTON: SAN CRISTOBAL","density: 1.158032e-06<br />TOTAL_VENTAS: 149931.32<br />CANTON: SAN CRISTOBAL","density: 1.128065e-06<br />TOTAL_VENTAS: 151878.48<br />CANTON: SAN CRISTOBAL","density: 1.098996e-06<br />TOTAL_VENTAS: 153825.64<br />CANTON: SAN CRISTOBAL","density: 1.071303e-06<br />TOTAL_VENTAS: 155772.80<br />CANTON: SAN CRISTOBAL","density: 1.044789e-06<br />TOTAL_VENTAS: 157719.96<br />CANTON: SAN CRISTOBAL","density: 1.019128e-06<br />TOTAL_VENTAS: 159667.12<br />CANTON: SAN CRISTOBAL","density: 9.947005e-07<br />TOTAL_VENTAS: 161614.28<br />CANTON: SAN CRISTOBAL","density: 9.714488e-07<br />TOTAL_VENTAS: 163561.44<br />CANTON: SAN CRISTOBAL","density: 9.489942e-07<br />TOTAL_VENTAS: 165508.60<br />CANTON: SAN CRISTOBAL","density: 9.276275e-07<br />TOTAL_VENTAS: 167455.76<br />CANTON: SAN CRISTOBAL","density: 9.074135e-07<br />TOTAL_VENTAS: 169402.92<br />CANTON: SAN CRISTOBAL","density: 8.879339e-07<br />TOTAL_VENTAS: 171350.08<br />CANTON: SAN CRISTOBAL","density: 8.693977e-07<br />TOTAL_VENTAS: 173297.24<br />CANTON: SAN CRISTOBAL","density: 8.519735e-07<br />TOTAL_VENTAS: 175244.40<br />CANTON: SAN CRISTOBAL","density: 8.352163e-07<br />TOTAL_VENTAS: 177191.56<br />CANTON: SAN CRISTOBAL","density: 8.192631e-07<br />TOTAL_VENTAS: 179138.72<br />CANTON: SAN CRISTOBAL","density: 8.043660e-07<br />TOTAL_VENTAS: 181085.88<br />CANTON: SAN CRISTOBAL","density: 7.900660e-07<br />TOTAL_VENTAS: 183033.04<br />CANTON: SAN CRISTOBAL","density: 7.764391e-07<br />TOTAL_VENTAS: 184980.20<br />CANTON: SAN CRISTOBAL","density: 7.637991e-07<br />TOTAL_VENTAS: 186927.36<br />CANTON: SAN CRISTOBAL","density: 7.516857e-07<br />TOTAL_VENTAS: 188874.52<br />CANTON: SAN CRISTOBAL","density: 7.401251e-07<br />TOTAL_VENTAS: 190821.68<br />CANTON: SAN CRISTOBAL","density: 7.294715e-07<br />TOTAL_VENTAS: 192768.84<br />CANTON: SAN CRISTOBAL","density: 7.192748e-07<br />TOTAL_VENTAS: 194716.00<br />CANTON: SAN CRISTOBAL","density: 7.095321e-07<br />TOTAL_VENTAS: 196663.16<br />CANTON: SAN CRISTOBAL","density: 7.005894e-07<br />TOTAL_VENTAS: 198610.32<br />CANTON: SAN CRISTOBAL","density: 6.920454e-07<br />TOTAL_VENTAS: 200557.48<br />CANTON: SAN CRISTOBAL","density: 6.838881e-07<br />TOTAL_VENTAS: 202504.64<br />CANTON: SAN CRISTOBAL","density: 6.763808e-07<br />TOTAL_VENTAS: 204451.80<br />CANTON: SAN CRISTOBAL","density: 6.692359e-07<br />TOTAL_VENTAS: 206398.96<br />CANTON: SAN CRISTOBAL","density: 6.624134e-07<br />TOTAL_VENTAS: 208346.12<br />CANTON: SAN CRISTOBAL","density: 6.561074e-07<br />TOTAL_VENTAS: 210293.28<br />CANTON: SAN CRISTOBAL","density: 6.501216e-07<br />TOTAL_VENTAS: 212240.44<br />CANTON: SAN CRISTOBAL","density: 6.443982e-07<br />TOTAL_VENTAS: 214187.60<br />CANTON: SAN CRISTOBAL","density: 6.390742e-07<br />TOTAL_VENTAS: 216134.76<br />CANTON: SAN CRISTOBAL","density: 6.340243e-07<br />TOTAL_VENTAS: 218081.92<br />CANTON: SAN CRISTOBAL","density: 6.291816e-07<br />TOTAL_VENTAS: 220029.08<br />CANTON: SAN CRISTOBAL","density: 6.246378e-07<br />TOTAL_VENTAS: 221976.24<br />CANTON: SAN CRISTOBAL","density: 6.203198e-07<br />TOTAL_VENTAS: 223923.40<br />CANTON: SAN CRISTOBAL","density: 6.161591e-07<br />TOTAL_VENTAS: 225870.56<br />CANTON: SAN CRISTOBAL","density: 6.122130e-07<br />TOTAL_VENTAS: 227817.72<br />CANTON: SAN CRISTOBAL","density: 6.084440e-07<br />TOTAL_VENTAS: 229764.88<br />CANTON: SAN CRISTOBAL","density: 6.047884e-07<br />TOTAL_VENTAS: 231712.04<br />CANTON: SAN CRISTOBAL","density: 6.012784e-07<br />TOTAL_VENTAS: 233659.20<br />CANTON: SAN CRISTOBAL","density: 5.978984e-07<br />TOTAL_VENTAS: 235606.36<br />CANTON: SAN CRISTOBAL","density: 5.945940e-07<br />TOTAL_VENTAS: 237553.52<br />CANTON: SAN CRISTOBAL","density: 5.913807e-07<br />TOTAL_VENTAS: 239500.68<br />CANTON: SAN CRISTOBAL","density: 5.882535e-07<br />TOTAL_VENTAS: 241447.84<br />CANTON: SAN CRISTOBAL","density: 5.851708e-07<br />TOTAL_VENTAS: 243395.00<br />CANTON: SAN CRISTOBAL","density: 5.821379e-07<br />TOTAL_VENTAS: 245342.16<br />CANTON: SAN CRISTOBAL","density: 5.791522e-07<br />TOTAL_VENTAS: 247289.32<br />CANTON: SAN CRISTOBAL","density: 5.761866e-07<br />TOTAL_VENTAS: 249236.48<br />CANTON: SAN CRISTOBAL","density: 5.732413e-07<br />TOTAL_VENTAS: 251183.64<br />CANTON: SAN CRISTOBAL","density: 5.703109e-07<br />TOTAL_VENTAS: 253130.80<br />CANTON: SAN CRISTOBAL","density: 5.673828e-07<br />TOTAL_VENTAS: 255077.96<br />CANTON: SAN CRISTOBAL","density: 5.644557e-07<br />TOTAL_VENTAS: 257025.12<br />CANTON: SAN CRISTOBAL","density: 5.615195e-07<br />TOTAL_VENTAS: 258972.28<br />CANTON: SAN CRISTOBAL","density: 5.585741e-07<br />TOTAL_VENTAS: 260919.44<br />CANTON: SAN CRISTOBAL","density: 5.556192e-07<br />TOTAL_VENTAS: 262866.60<br />CANTON: SAN CRISTOBAL","density: 5.526402e-07<br />TOTAL_VENTAS: 264813.76<br />CANTON: SAN CRISTOBAL","density: 5.496466e-07<br />TOTAL_VENTAS: 266760.92<br />CANTON: SAN CRISTOBAL","density: 5.466387e-07<br />TOTAL_VENTAS: 268708.08<br />CANTON: SAN CRISTOBAL","density: 5.436037e-07<br />TOTAL_VENTAS: 270655.24<br />CANTON: SAN CRISTOBAL","density: 5.405535e-07<br />TOTAL_VENTAS: 272602.40<br />CANTON: SAN CRISTOBAL","density: 5.374897e-07<br />TOTAL_VENTAS: 274549.56<br />CANTON: SAN CRISTOBAL","density: 5.344049e-07<br />TOTAL_VENTAS: 276496.72<br />CANTON: SAN CRISTOBAL","density: 5.313097e-07<br />TOTAL_VENTAS: 278443.88<br />CANTON: SAN CRISTOBAL","density: 5.282066e-07<br />TOTAL_VENTAS: 280391.04<br />CANTON: SAN CRISTOBAL","density: 5.250954e-07<br />TOTAL_VENTAS: 282338.20<br />CANTON: SAN CRISTOBAL","density: 5.219842e-07<br />TOTAL_VENTAS: 284285.36<br />CANTON: SAN CRISTOBAL","density: 5.188750e-07<br />TOTAL_VENTAS: 286232.52<br />CANTON: SAN CRISTOBAL","density: 5.157749e-07<br />TOTAL_VENTAS: 288179.68<br />CANTON: SAN CRISTOBAL","density: 5.126909e-07<br />TOTAL_VENTAS: 290126.84<br />CANTON: SAN CRISTOBAL","density: 5.096220e-07<br />TOTAL_VENTAS: 292074.00<br />CANTON: SAN CRISTOBAL","density: 5.065815e-07<br />TOTAL_VENTAS: 294021.16<br />CANTON: SAN CRISTOBAL","density: 5.035782e-07<br />TOTAL_VENTAS: 295968.32<br />CANTON: SAN CRISTOBAL","density: 5.006050e-07<br />TOTAL_VENTAS: 297915.48<br />CANTON: SAN CRISTOBAL","density: 4.976798e-07<br />TOTAL_VENTAS: 299862.64<br />CANTON: SAN CRISTOBAL","density: 4.948169e-07<br />TOTAL_VENTAS: 301809.80<br />CANTON: SAN CRISTOBAL","density: 4.920000e-07<br />TOTAL_VENTAS: 303756.96<br />CANTON: SAN CRISTOBAL","density: 4.892490e-07<br />TOTAL_VENTAS: 305704.12<br />CANTON: SAN CRISTOBAL","density: 4.865879e-07<br />TOTAL_VENTAS: 307651.28<br />CANTON: SAN CRISTOBAL","density: 4.839887e-07<br />TOTAL_VENTAS: 309598.44<br />CANTON: SAN CRISTOBAL","density: 4.814700e-07<br />TOTAL_VENTAS: 311545.60<br />CANTON: SAN CRISTOBAL","density: 4.790700e-07<br />TOTAL_VENTAS: 313492.76<br />CANTON: SAN CRISTOBAL","density: 4.767461e-07<br />TOTAL_VENTAS: 315439.92<br />CANTON: SAN CRISTOBAL","density: 4.745133e-07<br />TOTAL_VENTAS: 317387.08<br />CANTON: SAN CRISTOBAL","density: 4.724268e-07<br />TOTAL_VENTAS: 319334.24<br />CANTON: SAN CRISTOBAL","density: 4.704284e-07<br />TOTAL_VENTAS: 321281.40<br />CANTON: SAN CRISTOBAL","density: 4.685267e-07<br />TOTAL_VENTAS: 323228.56<br />CANTON: SAN CRISTOBAL","density: 4.667960e-07<br />TOTAL_VENTAS: 325175.72<br />CANTON: SAN CRISTOBAL","density: 4.651620e-07<br />TOTAL_VENTAS: 327122.88<br />CANTON: SAN CRISTOBAL","density: 4.636255e-07<br />TOTAL_VENTAS: 329070.04<br />CANTON: SAN CRISTOBAL","density: 4.622794e-07<br />TOTAL_VENTAS: 331017.20<br />CANTON: SAN CRISTOBAL","density: 4.610346e-07<br />TOTAL_VENTAS: 332964.36<br />CANTON: SAN CRISTOBAL","density: 4.598909e-07<br />TOTAL_VENTAS: 334911.52<br />CANTON: SAN CRISTOBAL","density: 4.589346e-07<br />TOTAL_VENTAS: 336858.68<br />CANTON: SAN CRISTOBAL","density: 4.580873e-07<br />TOTAL_VENTAS: 338805.84<br />CANTON: SAN CRISTOBAL","density: 4.573409e-07<br />TOTAL_VENTAS: 340753.00<br />CANTON: SAN CRISTOBAL","density: 4.567697e-07<br />TOTAL_VENTAS: 342700.16<br />CANTON: SAN CRISTOBAL","density: 4.563106e-07<br />TOTAL_VENTAS: 344647.32<br />CANTON: SAN CRISTOBAL","density: 4.559473e-07<br />TOTAL_VENTAS: 346594.48<br />CANTON: SAN CRISTOBAL","density: 4.557399e-07<br />TOTAL_VENTAS: 348541.64<br />CANTON: SAN CRISTOBAL","density: 4.556417e-07<br />TOTAL_VENTAS: 350488.80<br />CANTON: SAN CRISTOBAL","density: 4.556294e-07<br />TOTAL_VENTAS: 352435.96<br />CANTON: SAN CRISTOBAL","density: 4.557479e-07<br />TOTAL_VENTAS: 354383.12<br />CANTON: SAN CRISTOBAL","density: 4.559656e-07<br />TOTAL_VENTAS: 356330.28<br />CANTON: SAN CRISTOBAL","density: 4.562551e-07<br />TOTAL_VENTAS: 358277.44<br />CANTON: SAN CRISTOBAL","density: 4.566461e-07<br />TOTAL_VENTAS: 360224.60<br />CANTON: SAN CRISTOBAL","density: 4.571190e-07<br />TOTAL_VENTAS: 362171.76<br />CANTON: SAN CRISTOBAL","density: 4.576456e-07<br />TOTAL_VENTAS: 364118.92<br />CANTON: SAN CRISTOBAL","density: 4.582420e-07<br />TOTAL_VENTAS: 366066.08<br />CANTON: SAN CRISTOBAL","density: 4.588960e-07<br />TOTAL_VENTAS: 368013.24<br />CANTON: SAN CRISTOBAL","density: 4.595825e-07<br />TOTAL_VENTAS: 369960.40<br />CANTON: SAN CRISTOBAL","density: 4.603067e-07<br />TOTAL_VENTAS: 371907.56<br />CANTON: SAN CRISTOBAL","density: 4.610573e-07<br />TOTAL_VENTAS: 373854.72<br />CANTON: SAN CRISTOBAL","density: 4.618173e-07<br />TOTAL_VENTAS: 375801.88<br />CANTON: SAN CRISTOBAL","density: 4.625842e-07<br />TOTAL_VENTAS: 377749.04<br />CANTON: SAN CRISTOBAL","density: 4.633408e-07<br />TOTAL_VENTAS: 379696.20<br />CANTON: SAN CRISTOBAL","density: 4.640827e-07<br />TOTAL_VENTAS: 381643.36<br />CANTON: SAN CRISTOBAL","density: 4.648036e-07<br />TOTAL_VENTAS: 383590.52<br />CANTON: SAN CRISTOBAL","density: 4.654736e-07<br />TOTAL_VENTAS: 385537.68<br />CANTON: SAN CRISTOBAL","density: 4.661051e-07<br />TOTAL_VENTAS: 387484.84<br />CANTON: SAN CRISTOBAL","density: 4.666918e-07<br />TOTAL_VENTAS: 389432.00<br />CANTON: SAN CRISTOBAL","density: 4.671850e-07<br />TOTAL_VENTAS: 391379.16<br />CANTON: SAN CRISTOBAL","density: 4.676173e-07<br />TOTAL_VENTAS: 393326.32<br />CANTON: SAN CRISTOBAL","density: 4.679865e-07<br />TOTAL_VENTAS: 395273.48<br />CANTON: SAN CRISTOBAL","density: 4.682196e-07<br />TOTAL_VENTAS: 397220.64<br />CANTON: SAN CRISTOBAL","density: 4.683722e-07<br />TOTAL_VENTAS: 399167.80<br />CANTON: SAN CRISTOBAL","density: 4.684435e-07<br />TOTAL_VENTAS: 401114.96<br />CANTON: SAN CRISTOBAL","density: 4.683500e-07<br />TOTAL_VENTAS: 403062.12<br />CANTON: SAN CRISTOBAL","density: 4.681544e-07<br />TOTAL_VENTAS: 405009.28<br />CANTON: SAN CRISTOBAL","density: 4.678619e-07<br />TOTAL_VENTAS: 406956.44<br />CANTON: SAN CRISTOBAL","density: 4.673881e-07<br />TOTAL_VENTAS: 408903.60<br />CANTON: SAN CRISTOBAL","density: 4.667917e-07<br />TOTAL_VENTAS: 410850.76<br />CANTON: SAN CRISTOBAL","density: 4.660872e-07<br />TOTAL_VENTAS: 412797.92<br />CANTON: SAN CRISTOBAL","density: 4.651950e-07<br />TOTAL_VENTAS: 414745.08<br />CANTON: SAN CRISTOBAL","density: 4.641636e-07<br />TOTAL_VENTAS: 416692.24<br />CANTON: SAN CRISTOBAL","density: 4.630182e-07<br />TOTAL_VENTAS: 418639.40<br />CANTON: SAN CRISTOBAL","density: 4.616881e-07<br />TOTAL_VENTAS: 420586.56<br />CANTON: SAN CRISTOBAL","density: 4.602078e-07<br />TOTAL_VENTAS: 422533.72<br />CANTON: SAN CRISTOBAL","density: 4.586133e-07<br />TOTAL_VENTAS: 424480.88<br />CANTON: SAN CRISTOBAL","density: 4.568457e-07<br />TOTAL_VENTAS: 426428.04<br />CANTON: SAN CRISTOBAL","density: 4.549242e-07<br />TOTAL_VENTAS: 428375.20<br />CANTON: SAN CRISTOBAL","density: 4.528938e-07<br />TOTAL_VENTAS: 430322.36<br />CANTON: SAN CRISTOBAL","density: 4.507093e-07<br />TOTAL_VENTAS: 432269.52<br />CANTON: SAN CRISTOBAL","density: 4.483752e-07<br />TOTAL_VENTAS: 434216.68<br />CANTON: SAN CRISTOBAL","density: 4.459432e-07<br />TOTAL_VENTAS: 436163.84<br />CANTON: SAN CRISTOBAL","density: 4.433816e-07<br />TOTAL_VENTAS: 438111.00<br />CANTON: SAN CRISTOBAL","density: 4.406837e-07<br />TOTAL_VENTAS: 440058.16<br />CANTON: SAN CRISTOBAL","density: 4.379038e-07<br />TOTAL_VENTAS: 442005.32<br />CANTON: SAN CRISTOBAL","density: 4.350227e-07<br />TOTAL_VENTAS: 443952.48<br />CANTON: SAN CRISTOBAL","density: 4.320277e-07<br />TOTAL_VENTAS: 445899.64<br />CANTON: SAN CRISTOBAL","density: 4.289708e-07<br />TOTAL_VENTAS: 447846.80<br />CANTON: SAN CRISTOBAL","density: 4.258429e-07<br />TOTAL_VENTAS: 449793.96<br />CANTON: SAN CRISTOBAL","density: 4.226325e-07<br />TOTAL_VENTAS: 451741.12<br />CANTON: SAN CRISTOBAL","density: 4.193834e-07<br />TOTAL_VENTAS: 453688.28<br />CANTON: SAN CRISTOBAL","density: 4.160938e-07<br />TOTAL_VENTAS: 455635.44<br />CANTON: SAN CRISTOBAL","density: 4.127608e-07<br />TOTAL_VENTAS: 457582.60<br />CANTON: SAN CRISTOBAL","density: 4.094149e-07<br />TOTAL_VENTAS: 459529.76<br />CANTON: SAN CRISTOBAL","density: 4.060570e-07<br />TOTAL_VENTAS: 461476.92<br />CANTON: SAN CRISTOBAL","density: 4.027016e-07<br />TOTAL_VENTAS: 463424.08<br />CANTON: SAN CRISTOBAL","density: 3.993599e-07<br />TOTAL_VENTAS: 465371.24<br />CANTON: SAN CRISTOBAL","density: 3.960331e-07<br />TOTAL_VENTAS: 467318.40<br />CANTON: SAN CRISTOBAL","density: 3.927571e-07<br />TOTAL_VENTAS: 469265.56<br />CANTON: SAN CRISTOBAL","density: 3.895227e-07<br />TOTAL_VENTAS: 471212.72<br />CANTON: SAN CRISTOBAL","density: 3.863299e-07<br />TOTAL_VENTAS: 473159.88<br />CANTON: SAN CRISTOBAL","density: 3.832306e-07<br />TOTAL_VENTAS: 475107.04<br />CANTON: SAN CRISTOBAL","density: 3.802041e-07<br />TOTAL_VENTAS: 477054.20<br />CANTON: SAN CRISTOBAL","density: 3.772444e-07<br />TOTAL_VENTAS: 479001.36<br />CANTON: SAN CRISTOBAL","density: 3.744142e-07<br />TOTAL_VENTAS: 480948.52<br />CANTON: SAN CRISTOBAL","density: 3.716894e-07<br />TOTAL_VENTAS: 482895.68<br />CANTON: SAN CRISTOBAL","density: 3.690546e-07<br />TOTAL_VENTAS: 484842.84<br />CANTON: SAN CRISTOBAL","density: 3.665774e-07<br />TOTAL_VENTAS: 486790.00<br />CANTON: SAN CRISTOBAL","density: 3.642382e-07<br />TOTAL_VENTAS: 488737.16<br />CANTON: SAN CRISTOBAL","density: 3.620089e-07<br />TOTAL_VENTAS: 490684.32<br />CANTON: SAN CRISTOBAL","density: 3.599572e-07<br />TOTAL_VENTAS: 492631.48<br />CANTON: SAN CRISTOBAL","density: 3.580746e-07<br />TOTAL_VENTAS: 494578.64<br />CANTON: SAN CRISTOBAL","density: 3.563181e-07<br />TOTAL_VENTAS: 496525.80<br />CANTON: SAN CRISTOBAL","density: 3.547507e-07<br />TOTAL_VENTAS: 498472.96<br />CANTON: SAN CRISTOBAL","density: 3.533807e-07<br />TOTAL_VENTAS: 500420.12<br />CANTON: SAN CRISTOBAL","density: 3.521486e-07<br />TOTAL_VENTAS: 502367.28<br />CANTON: SAN CRISTOBAL","density: 3.511093e-07<br />TOTAL_VENTAS: 504314.44<br />CANTON: SAN CRISTOBAL","density: 3.502914e-07<br />TOTAL_VENTAS: 506261.60<br />CANTON: SAN CRISTOBAL","density: 3.496188e-07<br />TOTAL_VENTAS: 508208.76<br />CANTON: SAN CRISTOBAL","density: 3.491355e-07<br />TOTAL_VENTAS: 510155.92<br />CANTON: SAN CRISTOBAL","density: 3.488922e-07<br />TOTAL_VENTAS: 512103.08<br />CANTON: SAN CRISTOBAL","density: 3.487970e-07<br />TOTAL_VENTAS: 514050.24<br />CANTON: SAN CRISTOBAL","density: 3.488817e-07<br />TOTAL_VENTAS: 515997.40<br />CANTON: SAN CRISTOBAL","density: 3.492186e-07<br />TOTAL_VENTAS: 517944.56<br />CANTON: SAN CRISTOBAL","density: 3.497023e-07<br />TOTAL_VENTAS: 519891.72<br />CANTON: SAN CRISTOBAL","density: 3.503515e-07<br />TOTAL_VENTAS: 521838.88<br />CANTON: SAN CRISTOBAL","density: 3.512584e-07<br />TOTAL_VENTAS: 523786.04<br />CANTON: SAN CRISTOBAL","density: 3.523067e-07<br />TOTAL_VENTAS: 525733.20<br />CANTON: SAN CRISTOBAL","density: 3.535028e-07<br />TOTAL_VENTAS: 527680.36<br />CANTON: SAN CRISTOBAL","density: 3.549550e-07<br />TOTAL_VENTAS: 529627.52<br />CANTON: SAN CRISTOBAL","density: 3.565398e-07<br />TOTAL_VENTAS: 531574.68<br />CANTON: SAN CRISTOBAL","density: 3.582566e-07<br />TOTAL_VENTAS: 533521.84<br />CANTON: SAN CRISTOBAL","density: 3.602125e-07<br />TOTAL_VENTAS: 535469.00<br />CANTON: SAN CRISTOBAL","density: 3.622934e-07<br />TOTAL_VENTAS: 537416.16<br />CANTON: SAN CRISTOBAL","density: 3.644945e-07<br />TOTAL_VENTAS: 539363.32<br />CANTON: SAN CRISTOBAL","density: 3.669016e-07<br />TOTAL_VENTAS: 541310.48<br />CANTON: SAN CRISTOBAL","density: 3.694287e-07<br />TOTAL_VENTAS: 543257.64<br />CANTON: SAN CRISTOBAL","density: 3.720617e-07<br />TOTAL_VENTAS: 545204.80<br />CANTON: SAN CRISTOBAL","density: 3.748668e-07<br />TOTAL_VENTAS: 547151.96<br />CANTON: SAN CRISTOBAL","density: 3.777826e-07<br />TOTAL_VENTAS: 549099.12<br />CANTON: SAN CRISTOBAL","density: 3.807885e-07<br />TOTAL_VENTAS: 551046.28<br />CANTON: SAN CRISTOBAL","density: 3.839328e-07<br />TOTAL_VENTAS: 552993.44<br />CANTON: SAN CRISTOBAL","density: 3.871748e-07<br />TOTAL_VENTAS: 554940.60<br />CANTON: SAN CRISTOBAL","density: 3.904902e-07<br />TOTAL_VENTAS: 556887.76<br />CANTON: SAN CRISTOBAL","density: 3.939117e-07<br />TOTAL_VENTAS: 558834.92<br />CANTON: SAN CRISTOBAL","density: 3.974147e-07<br />TOTAL_VENTAS: 560782.08<br />CANTON: SAN CRISTOBAL","density: 4.009740e-07<br />TOTAL_VENTAS: 562729.24<br />CANTON: SAN CRISTOBAL","density: 4.046093e-07<br />TOTAL_VENTAS: 564676.40<br />CANTON: SAN CRISTOBAL","density: 4.083074e-07<br />TOTAL_VENTAS: 566623.56<br />CANTON: SAN CRISTOBAL","density: 4.120447e-07<br />TOTAL_VENTAS: 568570.72<br />CANTON: SAN CRISTOBAL","density: 4.158312e-07<br />TOTAL_VENTAS: 570517.88<br />CANTON: SAN CRISTOBAL","density: 4.196596e-07<br />TOTAL_VENTAS: 572465.04<br />CANTON: SAN CRISTOBAL","density: 4.235106e-07<br />TOTAL_VENTAS: 574412.20<br />CANTON: SAN CRISTOBAL","density: 4.273874e-07<br />TOTAL_VENTAS: 576359.36<br />CANTON: SAN CRISTOBAL","density: 4.312837e-07<br />TOTAL_VENTAS: 578306.52<br />CANTON: SAN CRISTOBAL","density: 4.351871e-07<br />TOTAL_VENTAS: 580253.68<br />CANTON: SAN CRISTOBAL","density: 4.390964e-07<br />TOTAL_VENTAS: 582200.84<br />CANTON: SAN CRISTOBAL","density: 4.430020e-07<br />TOTAL_VENTAS: 584148.00<br />CANTON: SAN CRISTOBAL","density: 4.469003e-07<br />TOTAL_VENTAS: 586095.16<br />CANTON: SAN CRISTOBAL","density: 4.507884e-07<br />TOTAL_VENTAS: 588042.32<br />CANTON: SAN CRISTOBAL","density: 4.546493e-07<br />TOTAL_VENTAS: 589989.48<br />CANTON: SAN CRISTOBAL","density: 4.584896e-07<br />TOTAL_VENTAS: 591936.64<br />CANTON: SAN CRISTOBAL","density: 4.623072e-07<br />TOTAL_VENTAS: 593883.80<br />CANTON: SAN CRISTOBAL","density: 4.660742e-07<br />TOTAL_VENTAS: 595830.96<br />CANTON: SAN CRISTOBAL","density: 4.698088e-07<br />TOTAL_VENTAS: 597778.12<br />CANTON: SAN CRISTOBAL","density: 4.735105e-07<br />TOTAL_VENTAS: 599725.28<br />CANTON: SAN CRISTOBAL","density: 4.771402e-07<br />TOTAL_VENTAS: 601672.44<br />CANTON: SAN CRISTOBAL","density: 4.807261e-07<br />TOTAL_VENTAS: 603619.60<br />CANTON: SAN CRISTOBAL","density: 4.842688e-07<br />TOTAL_VENTAS: 605566.76<br />CANTON: SAN CRISTOBAL","density: 4.877252e-07<br />TOTAL_VENTAS: 607513.92<br />CANTON: SAN CRISTOBAL","density: 4.911246e-07<br />TOTAL_VENTAS: 609461.08<br />CANTON: SAN CRISTOBAL","density: 4.944714e-07<br />TOTAL_VENTAS: 611408.24<br />CANTON: SAN CRISTOBAL","density: 4.977212e-07<br />TOTAL_VENTAS: 613355.40<br />CANTON: SAN CRISTOBAL","density: 5.009003e-07<br />TOTAL_VENTAS: 615302.56<br />CANTON: SAN CRISTOBAL","density: 5.040186e-07<br />TOTAL_VENTAS: 617249.72<br />CANTON: SAN CRISTOBAL","density: 5.070322e-07<br />TOTAL_VENTAS: 619196.88<br />CANTON: SAN CRISTOBAL","density: 5.099612e-07<br />TOTAL_VENTAS: 621144.04<br />CANTON: SAN CRISTOBAL","density: 5.128221e-07<br />TOTAL_VENTAS: 623091.20<br />CANTON: SAN CRISTOBAL","density: 5.155731e-07<br />TOTAL_VENTAS: 625038.36<br />CANTON: SAN CRISTOBAL","density: 5.182252e-07<br />TOTAL_VENTAS: 626985.52<br />CANTON: SAN CRISTOBAL","density: 5.208029e-07<br />TOTAL_VENTAS: 628932.68<br />CANTON: SAN CRISTOBAL","density: 5.232672e-07<br />TOTAL_VENTAS: 630879.84<br />CANTON: SAN CRISTOBAL","density: 5.256183e-07<br />TOTAL_VENTAS: 632827.00<br />CANTON: SAN CRISTOBAL","density: 5.278890e-07<br />TOTAL_VENTAS: 634774.16<br />CANTON: SAN CRISTOBAL","density: 5.300447e-07<br />TOTAL_VENTAS: 636721.32<br />CANTON: SAN CRISTOBAL","density: 5.320726e-07<br />TOTAL_VENTAS: 638668.48<br />CANTON: SAN CRISTOBAL","density: 5.340145e-07<br />TOTAL_VENTAS: 640615.64<br />CANTON: SAN CRISTOBAL","density: 5.358411e-07<br />TOTAL_VENTAS: 642562.80<br />CANTON: SAN CRISTOBAL","density: 5.375248e-07<br />TOTAL_VENTAS: 644509.96<br />CANTON: SAN CRISTOBAL","density: 5.391172e-07<br />TOTAL_VENTAS: 646457.12<br />CANTON: SAN CRISTOBAL","density: 5.405954e-07<br />TOTAL_VENTAS: 648404.28<br />CANTON: SAN CRISTOBAL","density: 5.419150e-07<br />TOTAL_VENTAS: 650351.44<br />CANTON: SAN CRISTOBAL","density: 5.431384e-07<br />TOTAL_VENTAS: 652298.60<br />CANTON: SAN CRISTOBAL","density: 5.442495e-07<br />TOTAL_VENTAS: 654245.76<br />CANTON: SAN CRISTOBAL","density: 5.451862e-07<br />TOTAL_VENTAS: 656192.92<br />CANTON: SAN CRISTOBAL","density: 5.460217e-07<br />TOTAL_VENTAS: 658140.08<br />CANTON: SAN CRISTOBAL","density: 5.467481e-07<br />TOTAL_VENTAS: 660087.24<br />CANTON: SAN CRISTOBAL","density: 5.472837e-07<br />TOTAL_VENTAS: 662034.40<br />CANTON: SAN CRISTOBAL","density: 5.477138e-07<br />TOTAL_VENTAS: 663981.56<br />CANTON: SAN CRISTOBAL","density: 5.480381e-07<br />TOTAL_VENTAS: 665928.72<br />CANTON: SAN CRISTOBAL","density: 5.481564e-07<br />TOTAL_VENTAS: 667875.88<br />CANTON: SAN CRISTOBAL","density: 5.481645e-07<br />TOTAL_VENTAS: 669823.04<br />CANTON: SAN CRISTOBAL","density: 5.480627e-07<br />TOTAL_VENTAS: 671770.20<br />CANTON: SAN CRISTOBAL","density: 5.477570e-07<br />TOTAL_VENTAS: 673717.36<br />CANTON: SAN CRISTOBAL","density: 5.473283e-07<br />TOTAL_VENTAS: 675664.52<br />CANTON: SAN CRISTOBAL","density: 5.467862e-07<br />TOTAL_VENTAS: 677611.68<br />CANTON: SAN CRISTOBAL","density: 5.460438e-07<br />TOTAL_VENTAS: 679558.84<br />CANTON: SAN CRISTOBAL","density: 5.451658e-07<br />TOTAL_VENTAS: 681506.00<br />CANTON: SAN CRISTOBAL","density: 5.441715e-07<br />TOTAL_VENTAS: 683453.16<br />CANTON: SAN CRISTOBAL","density: 5.429823e-07<br />TOTAL_VENTAS: 685400.32<br />CANTON: SAN CRISTOBAL","density: 5.416453e-07<br />TOTAL_VENTAS: 687347.48<br />CANTON: SAN CRISTOBAL","density: 5.401902e-07<br />TOTAL_VENTAS: 689294.64<br />CANTON: SAN CRISTOBAL","density: 5.385471e-07<br />TOTAL_VENTAS: 691241.80<br />CANTON: SAN CRISTOBAL","density: 5.367450e-07<br />TOTAL_VENTAS: 693188.96<br />CANTON: SAN CRISTOBAL","density: 5.348238e-07<br />TOTAL_VENTAS: 695136.12<br />CANTON: SAN CRISTOBAL","density: 5.327234e-07<br />TOTAL_VENTAS: 697083.28<br />CANTON: SAN CRISTOBAL","density: 5.304541e-07<br />TOTAL_VENTAS: 699030.44<br />CANTON: SAN CRISTOBAL","density: 5.280658e-07<br />TOTAL_VENTAS: 700977.60<br />CANTON: SAN CRISTOBAL","density: 5.255089e-07<br />TOTAL_VENTAS: 702924.76<br />CANTON: SAN CRISTOBAL","density: 5.227748e-07<br />TOTAL_VENTAS: 704871.92<br />CANTON: SAN CRISTOBAL","density: 5.199231e-07<br />TOTAL_VENTAS: 706819.08<br />CANTON: SAN CRISTOBAL","density: 5.169147e-07<br />TOTAL_VENTAS: 708766.24<br />CANTON: SAN CRISTOBAL","density: 5.137231e-07<br />TOTAL_VENTAS: 710713.40<br />CANTON: SAN CRISTOBAL","density: 5.104165e-07<br />TOTAL_VENTAS: 712660.56<br />CANTON: SAN CRISTOBAL","density: 5.069665e-07<br />TOTAL_VENTAS: 714607.72<br />CANTON: SAN CRISTOBAL","density: 5.033294e-07<br />TOTAL_VENTAS: 716554.88<br />CANTON: SAN CRISTOBAL","density: 4.995815e-07<br />TOTAL_VENTAS: 718502.04<br />CANTON: SAN CRISTOBAL","density: 4.957043e-07<br />TOTAL_VENTAS: 720449.20<br />CANTON: SAN CRISTOBAL","density: 4.916389e-07<br />TOTAL_VENTAS: 722396.36<br />CANTON: SAN CRISTOBAL","density: 4.874681e-07<br />TOTAL_VENTAS: 724343.52<br />CANTON: SAN CRISTOBAL","density: 4.831827e-07<br />TOTAL_VENTAS: 726290.68<br />CANTON: SAN CRISTOBAL","density: 4.787109e-07<br />TOTAL_VENTAS: 728237.84<br />CANTON: SAN CRISTOBAL","density: 4.741402e-07<br />TOTAL_VENTAS: 730185.00<br />CANTON: SAN CRISTOBAL","density: 4.694700e-07<br />TOTAL_VENTAS: 732132.16<br />CANTON: SAN CRISTOBAL","density: 4.646181e-07<br />TOTAL_VENTAS: 734079.32<br />CANTON: SAN CRISTOBAL","density: 4.596750e-07<br />TOTAL_VENTAS: 736026.48<br />CANTON: SAN CRISTOBAL","density: 4.546408e-07<br />TOTAL_VENTAS: 737973.64<br />CANTON: SAN CRISTOBAL","density: 4.494456e-07<br />TOTAL_VENTAS: 739920.80<br />CANTON: SAN CRISTOBAL","density: 4.441613e-07<br />TOTAL_VENTAS: 741867.96<br />CANTON: SAN CRISTOBAL","density: 4.387945e-07<br />TOTAL_VENTAS: 743815.12<br />CANTON: SAN CRISTOBAL","density: 4.332892e-07<br />TOTAL_VENTAS: 745762.28<br />CANTON: SAN CRISTOBAL","density: 4.276983e-07<br />TOTAL_VENTAS: 747709.44<br />CANTON: SAN CRISTOBAL","density: 4.220345e-07<br />TOTAL_VENTAS: 749656.60<br />CANTON: SAN CRISTOBAL","density: 4.162542e-07<br />TOTAL_VENTAS: 751603.76<br />CANTON: SAN CRISTOBAL","density: 4.103940e-07<br />TOTAL_VENTAS: 753550.92<br />CANTON: SAN CRISTOBAL","density: 4.044711e-07<br />TOTAL_VENTAS: 755498.08<br />CANTON: SAN CRISTOBAL","density: 3.984531e-07<br />TOTAL_VENTAS: 757445.24<br />CANTON: SAN CRISTOBAL","density: 3.923635e-07<br />TOTAL_VENTAS: 759392.40<br />CANTON: SAN CRISTOBAL","density: 3.862215e-07<br />TOTAL_VENTAS: 761339.56<br />CANTON: SAN CRISTOBAL","density: 3.800051e-07<br />TOTAL_VENTAS: 763286.72<br />CANTON: SAN CRISTOBAL","density: 3.737271e-07<br />TOTAL_VENTAS: 765233.88<br />CANTON: SAN CRISTOBAL","density: 3.674078e-07<br />TOTAL_VENTAS: 767181.04<br />CANTON: SAN CRISTOBAL","density: 3.610333e-07<br />TOTAL_VENTAS: 769128.20<br />CANTON: SAN CRISTOBAL","density: 3.546096e-07<br />TOTAL_VENTAS: 771075.36<br />CANTON: SAN CRISTOBAL","density: 3.481557e-07<br />TOTAL_VENTAS: 773022.52<br />CANTON: SAN CRISTOBAL","density: 3.416644e-07<br />TOTAL_VENTAS: 774969.68<br />CANTON: SAN CRISTOBAL","density: 3.351381e-07<br />TOTAL_VENTAS: 776916.84<br />CANTON: SAN CRISTOBAL","density: 3.285930e-07<br />TOTAL_VENTAS: 778864.00<br />CANTON: SAN CRISTOBAL","density: 3.220265e-07<br />TOTAL_VENTAS: 780811.16<br />CANTON: SAN CRISTOBAL","density: 3.154411e-07<br />TOTAL_VENTAS: 782758.32<br />CANTON: SAN CRISTOBAL","density: 3.088483e-07<br />TOTAL_VENTAS: 784705.48<br />CANTON: SAN CRISTOBAL","density: 3.022484e-07<br />TOTAL_VENTAS: 786652.64<br />CANTON: SAN CRISTOBAL","density: 2.956474e-07<br />TOTAL_VENTAS: 788599.80<br />CANTON: SAN CRISTOBAL","density: 2.890502e-07<br />TOTAL_VENTAS: 790546.96<br />CANTON: SAN CRISTOBAL","density: 2.824583e-07<br />TOTAL_VENTAS: 792494.12<br />CANTON: SAN CRISTOBAL","density: 2.758846e-07<br />TOTAL_VENTAS: 794441.28<br />CANTON: SAN CRISTOBAL","density: 2.693257e-07<br />TOTAL_VENTAS: 796388.44<br />CANTON: SAN CRISTOBAL","density: 2.627824e-07<br />TOTAL_VENTAS: 798335.60<br />CANTON: SAN CRISTOBAL","density: 2.562779e-07<br />TOTAL_VENTAS: 800282.76<br />CANTON: SAN CRISTOBAL","density: 2.497988e-07<br />TOTAL_VENTAS: 802229.92<br />CANTON: SAN CRISTOBAL","density: 2.433456e-07<br />TOTAL_VENTAS: 804177.08<br />CANTON: SAN CRISTOBAL","density: 2.369490e-07<br />TOTAL_VENTAS: 806124.24<br />CANTON: SAN CRISTOBAL","density: 2.305899e-07<br />TOTAL_VENTAS: 808071.40<br />CANTON: SAN CRISTOBAL","density: 2.242667e-07<br />TOTAL_VENTAS: 810018.56<br />CANTON: SAN CRISTOBAL","density: 2.180147e-07<br />TOTAL_VENTAS: 811965.72<br />CANTON: SAN CRISTOBAL","density: 2.118136e-07<br />TOTAL_VENTAS: 813912.88<br />CANTON: SAN CRISTOBAL","density: 2.056581e-07<br />TOTAL_VENTAS: 815860.04<br />CANTON: SAN CRISTOBAL","density: 1.995856e-07<br />TOTAL_VENTAS: 817807.20<br />CANTON: SAN CRISTOBAL","density: 1.935781e-07<br />TOTAL_VENTAS: 819754.36<br />CANTON: SAN CRISTOBAL","density: 1.876251e-07<br />TOTAL_VENTAS: 821701.52<br />CANTON: SAN CRISTOBAL","density: 1.817643e-07<br />TOTAL_VENTAS: 823648.68<br />CANTON: SAN CRISTOBAL","density: 1.759831e-07<br />TOTAL_VENTAS: 825595.84<br />CANTON: SAN CRISTOBAL","density: 1.702644e-07<br />TOTAL_VENTAS: 827543.00<br />CANTON: SAN CRISTOBAL","density: 1.646444e-07<br />TOTAL_VENTAS: 829490.16<br />CANTON: SAN CRISTOBAL","density: 1.591187e-07<br />TOTAL_VENTAS: 831437.32<br />CANTON: SAN CRISTOBAL","density: 1.536623e-07<br />TOTAL_VENTAS: 833384.48<br />CANTON: SAN CRISTOBAL","density: 1.483088e-07<br />TOTAL_VENTAS: 835331.64<br />CANTON: SAN CRISTOBAL","density: 1.430637e-07<br />TOTAL_VENTAS: 837278.80<br />CANTON: SAN CRISTOBAL","density: 1.378939e-07<br />TOTAL_VENTAS: 839225.96<br />CANTON: SAN CRISTOBAL","density: 1.328284e-07<br />TOTAL_VENTAS: 841173.12<br />CANTON: SAN CRISTOBAL","density: 1.278850e-07<br />TOTAL_VENTAS: 843120.28<br />CANTON: SAN CRISTOBAL","density: 1.230215e-07<br />TOTAL_VENTAS: 845067.44<br />CANTON: SAN CRISTOBAL","density: 1.182615e-07<br />TOTAL_VENTAS: 847014.60<br />CANTON: SAN CRISTOBAL","density: 1.136360e-07<br />TOTAL_VENTAS: 848961.76<br />CANTON: SAN CRISTOBAL","density: 1.090939e-07<br />TOTAL_VENTAS: 850908.92<br />CANTON: SAN CRISTOBAL","density: 1.046523e-07<br />TOTAL_VENTAS: 852856.08<br />CANTON: SAN CRISTOBAL","density: 1.003563e-07<br />TOTAL_VENTAS: 854803.24<br />CANTON: SAN CRISTOBAL","density: 9.614569e-08<br />TOTAL_VENTAS: 856750.40<br />CANTON: SAN CRISTOBAL","density: 9.203087e-08<br />TOTAL_VENTAS: 858697.56<br />CANTON: SAN CRISTOBAL","density: 8.807092e-08<br />TOTAL_VENTAS: 860644.72<br />CANTON: SAN CRISTOBAL","density: 8.419722e-08<br />TOTAL_VENTAS: 862591.88<br />CANTON: SAN CRISTOBAL","density: 8.041298e-08<br />TOTAL_VENTAS: 864539.04<br />CANTON: SAN CRISTOBAL","density: 7.679088e-08<br />TOTAL_VENTAS: 866486.20<br />CANTON: SAN CRISTOBAL","density: 7.325462e-08<br />TOTAL_VENTAS: 868433.36<br />CANTON: SAN CRISTOBAL","density: 6.980415e-08<br />TOTAL_VENTAS: 870380.52<br />CANTON: SAN CRISTOBAL","density: 6.651317e-08<br />TOTAL_VENTAS: 872327.68<br />CANTON: SAN CRISTOBAL","density: 6.331032e-08<br />TOTAL_VENTAS: 874274.84<br />CANTON: SAN CRISTOBAL","density: 6.019159e-08<br />TOTAL_VENTAS: 876222.00<br />CANTON: SAN CRISTOBAL","density: 5.722170e-08<br />TOTAL_VENTAS: 878169.16<br />CANTON: SAN CRISTOBAL","density: 5.434400e-08<br />TOTAL_VENTAS: 880116.32<br />CANTON: SAN CRISTOBAL","density: 5.154773e-08<br />TOTAL_VENTAS: 882063.48<br />CANTON: SAN CRISTOBAL","density: 4.888837e-08<br />TOTAL_VENTAS: 884010.64<br />CANTON: SAN CRISTOBAL","density: 4.632382e-08<br />TOTAL_VENTAS: 885957.80<br />CANTON: SAN CRISTOBAL","density: 4.383706e-08<br />TOTAL_VENTAS: 887904.96<br />CANTON: SAN CRISTOBAL","density: 4.147451e-08<br />TOTAL_VENTAS: 889852.12<br />CANTON: SAN CRISTOBAL","density: 3.920787e-08<br />TOTAL_VENTAS: 891799.28<br />CANTON: SAN CRISTOBAL","density: 3.701463e-08<br />TOTAL_VENTAS: 893746.44<br />CANTON: SAN CRISTOBAL","density: 3.493248e-08<br />TOTAL_VENTAS: 895693.60<br />CANTON: SAN CRISTOBAL","density: 3.294590e-08<br />TOTAL_VENTAS: 897640.76<br />CANTON: SAN CRISTOBAL","density: 3.102771e-08<br />TOTAL_VENTAS: 899587.92<br />CANTON: SAN CRISTOBAL","density: 2.920750e-08<br />TOTAL_VENTAS: 901535.08<br />CANTON: SAN CRISTOBAL","density: 2.748110e-08<br />TOTAL_VENTAS: 903482.24<br />CANTON: SAN CRISTOBAL","density: 2.581769e-08<br />TOTAL_VENTAS: 905429.40<br />CANTON: SAN CRISTOBAL","density: 2.423945e-08<br />TOTAL_VENTAS: 907376.56<br />CANTON: SAN CRISTOBAL","density: 2.275201e-08<br />TOTAL_VENTAS: 909323.72<br />CANTON: SAN CRISTOBAL","density: 2.132188e-08<br />TOTAL_VENTAS: 911270.88<br />CANTON: SAN CRISTOBAL","density: 1.996474e-08<br />TOTAL_VENTAS: 913218.04<br />CANTON: SAN CRISTOBAL","density: 1.869428e-08<br />TOTAL_VENTAS: 915165.20<br />CANTON: SAN CRISTOBAL","density: 1.747535e-08<br />TOTAL_VENTAS: 917112.36<br />CANTON: SAN CRISTOBAL","density: 1.631805e-08<br />TOTAL_VENTAS: 919059.52<br />CANTON: SAN CRISTOBAL","density: 1.524241e-08<br />TOTAL_VENTAS: 921006.68<br />CANTON: SAN CRISTOBAL","density: 1.421258e-08<br />TOTAL_VENTAS: 922953.84<br />CANTON: SAN CRISTOBAL","density: 1.323399e-08<br />TOTAL_VENTAS: 924901.00<br />CANTON: SAN CRISTOBAL","density: 1.233132e-08<br />TOTAL_VENTAS: 926848.16<br />CANTON: SAN CRISTOBAL","density: 1.146892e-08<br />TOTAL_VENTAS: 928795.32<br />CANTON: SAN CRISTOBAL","density: 1.064845e-08<br />TOTAL_VENTAS: 930742.48<br />CANTON: SAN CRISTOBAL","density: 9.897693e-09<br />TOTAL_VENTAS: 932689.64<br />CANTON: SAN CRISTOBAL","density: 9.181911e-09<br />TOTAL_VENTAS: 934636.80<br />CANTON: SAN CRISTOBAL","density: 8.500901e-09<br />TOTAL_VENTAS: 936583.96<br />CANTON: SAN CRISTOBAL","density: 7.881079e-09<br />TOTAL_VENTAS: 938531.12<br />CANTON: SAN CRISTOBAL","density: 7.292312e-09<br />TOTAL_VENTAS: 940478.28<br />CANTON: SAN CRISTOBAL","density: 6.733405e-09<br />TOTAL_VENTAS: 942425.44<br />CANTON: SAN CRISTOBAL","density: 6.224807e-09<br />TOTAL_VENTAS: 944372.60<br />CANTON: SAN CRISTOBAL","density: 5.744885e-09<br />TOTAL_VENTAS: 946319.76<br />CANTON: SAN CRISTOBAL","density: 5.290317e-09<br />TOTAL_VENTAS: 948266.92<br />CANTON: SAN CRISTOBAL","density: 4.876605e-09<br />TOTAL_VENTAS: 950214.08<br />CANTON: SAN CRISTOBAL","density: 4.488956e-09<br />TOTAL_VENTAS: 952161.24<br />CANTON: SAN CRISTOBAL","density: 4.122600e-09<br />TOTAL_VENTAS: 954108.40<br />CANTON: SAN CRISTOBAL","density: 3.789007e-09<br />TOTAL_VENTAS: 956055.56<br />CANTON: SAN CRISTOBAL","density: 3.478752e-09<br />TOTAL_VENTAS: 958002.72<br />CANTON: SAN CRISTOBAL","density: 3.186179e-09<br />TOTAL_VENTAS: 959949.88<br />CANTON: SAN CRISTOBAL","density: 2.919549e-09<br />TOTAL_VENTAS: 961897.04<br />CANTON: SAN CRISTOBAL","density: 2.673517e-09<br />TOTAL_VENTAS: 963844.20<br />CANTON: SAN CRISTOBAL","density: 2.442009e-09<br />TOTAL_VENTAS: 965791.36<br />CANTON: SAN CRISTOBAL","density: 2.230778e-09<br />TOTAL_VENTAS: 967738.52<br />CANTON: SAN CRISTOBAL","density: 2.037479e-09<br />TOTAL_VENTAS: 969685.68<br />CANTON: SAN CRISTOBAL","density: 1.855978e-09<br />TOTAL_VENTAS: 971632.84<br />CANTON: SAN CRISTOBAL","density: 1.690117e-09<br />TOTAL_VENTAS: 973580.00<br />CANTON: SAN CRISTOBAL","density: 1.539658e-09<br />TOTAL_VENTAS: 975527.16<br />CANTON: SAN CRISTOBAL","density: 1.398680e-09<br />TOTAL_VENTAS: 977474.32<br />CANTON: SAN CRISTOBAL","density: 1.269602e-09<br />TOTAL_VENTAS: 979421.48<br />CANTON: SAN CRISTOBAL","density: 1.153583e-09<br />TOTAL_VENTAS: 981368.64<br />CANTON: SAN CRISTOBAL","density: 1.045098e-09<br />TOTAL_VENTAS: 983315.80<br />CANTON: SAN CRISTOBAL","density: 9.455416e-10<br />TOTAL_VENTAS: 985262.96<br />CANTON: SAN CRISTOBAL","density: 8.569188e-10<br />TOTAL_VENTAS: 987210.12<br />CANTON: SAN CRISTOBAL","density: 7.742172e-10<br />TOTAL_VENTAS: 989157.28<br />CANTON: SAN CRISTOBAL","density: 6.981189e-10<br />TOTAL_VENTAS: 991104.44<br />CANTON: SAN CRISTOBAL","density: 6.310611e-10<br />TOTAL_VENTAS: 993051.60<br />CANTON: SAN CRISTOBAL","density: 5.686064e-10<br />TOTAL_VENTAS: 994998.76<br />CANTON: SAN CRISTOBAL","density: 5.686064e-10<br />TOTAL_VENTAS: 994998.76<br />CANTON: SAN CRISTOBAL","density: 6.310611e-10<br />TOTAL_VENTAS: 993051.60<br />CANTON: SAN CRISTOBAL","density: 6.981189e-10<br />TOTAL_VENTAS: 991104.44<br />CANTON: SAN CRISTOBAL","density: 7.742172e-10<br />TOTAL_VENTAS: 989157.28<br />CANTON: SAN CRISTOBAL","density: 8.569188e-10<br />TOTAL_VENTAS: 987210.12<br />CANTON: SAN CRISTOBAL","density: 9.455416e-10<br />TOTAL_VENTAS: 985262.96<br />CANTON: SAN CRISTOBAL","density: 1.045098e-09<br />TOTAL_VENTAS: 983315.80<br />CANTON: SAN CRISTOBAL","density: 1.153583e-09<br />TOTAL_VENTAS: 981368.64<br />CANTON: SAN CRISTOBAL","density: 1.269602e-09<br />TOTAL_VENTAS: 979421.48<br />CANTON: SAN CRISTOBAL","density: 1.398680e-09<br />TOTAL_VENTAS: 977474.32<br />CANTON: SAN CRISTOBAL","density: 1.539658e-09<br />TOTAL_VENTAS: 975527.16<br />CANTON: SAN CRISTOBAL","density: 1.690117e-09<br />TOTAL_VENTAS: 973580.00<br />CANTON: SAN CRISTOBAL","density: 1.855978e-09<br />TOTAL_VENTAS: 971632.84<br />CANTON: SAN CRISTOBAL","density: 2.037479e-09<br />TOTAL_VENTAS: 969685.68<br />CANTON: SAN CRISTOBAL","density: 2.230778e-09<br />TOTAL_VENTAS: 967738.52<br />CANTON: SAN CRISTOBAL","density: 2.442009e-09<br />TOTAL_VENTAS: 965791.36<br />CANTON: SAN CRISTOBAL","density: 2.673517e-09<br />TOTAL_VENTAS: 963844.20<br />CANTON: SAN CRISTOBAL","density: 2.919549e-09<br />TOTAL_VENTAS: 961897.04<br />CANTON: SAN CRISTOBAL","density: 3.186179e-09<br />TOTAL_VENTAS: 959949.88<br />CANTON: SAN CRISTOBAL","density: 3.478752e-09<br />TOTAL_VENTAS: 958002.72<br />CANTON: SAN CRISTOBAL","density: 3.789007e-09<br />TOTAL_VENTAS: 956055.56<br />CANTON: SAN CRISTOBAL","density: 4.122600e-09<br />TOTAL_VENTAS: 954108.40<br />CANTON: SAN CRISTOBAL","density: 4.488956e-09<br />TOTAL_VENTAS: 952161.24<br />CANTON: SAN CRISTOBAL","density: 4.876605e-09<br />TOTAL_VENTAS: 950214.08<br />CANTON: SAN CRISTOBAL","density: 5.290317e-09<br />TOTAL_VENTAS: 948266.92<br />CANTON: SAN CRISTOBAL","density: 5.744885e-09<br />TOTAL_VENTAS: 946319.76<br />CANTON: SAN CRISTOBAL","density: 6.224807e-09<br />TOTAL_VENTAS: 944372.60<br />CANTON: SAN CRISTOBAL","density: 6.733405e-09<br />TOTAL_VENTAS: 942425.44<br />CANTON: SAN CRISTOBAL","density: 7.292312e-09<br />TOTAL_VENTAS: 940478.28<br />CANTON: SAN CRISTOBAL","density: 7.881079e-09<br />TOTAL_VENTAS: 938531.12<br />CANTON: SAN CRISTOBAL","density: 8.500901e-09<br />TOTAL_VENTAS: 936583.96<br />CANTON: SAN CRISTOBAL","density: 9.181911e-09<br />TOTAL_VENTAS: 934636.80<br />CANTON: SAN CRISTOBAL","density: 9.897693e-09<br />TOTAL_VENTAS: 932689.64<br />CANTON: SAN CRISTOBAL","density: 1.064845e-08<br />TOTAL_VENTAS: 930742.48<br />CANTON: SAN CRISTOBAL","density: 1.146892e-08<br />TOTAL_VENTAS: 928795.32<br />CANTON: SAN CRISTOBAL","density: 1.233132e-08<br />TOTAL_VENTAS: 926848.16<br />CANTON: SAN CRISTOBAL","density: 1.323399e-08<br />TOTAL_VENTAS: 924901.00<br />CANTON: SAN CRISTOBAL","density: 1.421258e-08<br />TOTAL_VENTAS: 922953.84<br />CANTON: SAN CRISTOBAL","density: 1.524241e-08<br />TOTAL_VENTAS: 921006.68<br />CANTON: SAN CRISTOBAL","density: 1.631805e-08<br />TOTAL_VENTAS: 919059.52<br />CANTON: SAN CRISTOBAL","density: 1.747535e-08<br />TOTAL_VENTAS: 917112.36<br />CANTON: SAN CRISTOBAL","density: 1.869428e-08<br />TOTAL_VENTAS: 915165.20<br />CANTON: SAN CRISTOBAL","density: 1.996474e-08<br />TOTAL_VENTAS: 913218.04<br />CANTON: SAN CRISTOBAL","density: 2.132188e-08<br />TOTAL_VENTAS: 911270.88<br />CANTON: SAN CRISTOBAL","density: 2.275201e-08<br />TOTAL_VENTAS: 909323.72<br />CANTON: SAN CRISTOBAL","density: 2.423945e-08<br />TOTAL_VENTAS: 907376.56<br />CANTON: SAN CRISTOBAL","density: 2.581769e-08<br />TOTAL_VENTAS: 905429.40<br />CANTON: SAN CRISTOBAL","density: 2.748110e-08<br />TOTAL_VENTAS: 903482.24<br />CANTON: SAN CRISTOBAL","density: 2.920750e-08<br />TOTAL_VENTAS: 901535.08<br />CANTON: SAN CRISTOBAL","density: 3.102771e-08<br />TOTAL_VENTAS: 899587.92<br />CANTON: SAN CRISTOBAL","density: 3.294590e-08<br />TOTAL_VENTAS: 897640.76<br />CANTON: SAN CRISTOBAL","density: 3.493248e-08<br />TOTAL_VENTAS: 895693.60<br />CANTON: SAN CRISTOBAL","density: 3.701463e-08<br />TOTAL_VENTAS: 893746.44<br />CANTON: SAN CRISTOBAL","density: 3.920787e-08<br />TOTAL_VENTAS: 891799.28<br />CANTON: SAN CRISTOBAL","density: 4.147451e-08<br />TOTAL_VENTAS: 889852.12<br />CANTON: SAN CRISTOBAL","density: 4.383706e-08<br />TOTAL_VENTAS: 887904.96<br />CANTON: SAN CRISTOBAL","density: 4.632382e-08<br />TOTAL_VENTAS: 885957.80<br />CANTON: SAN CRISTOBAL","density: 4.888837e-08<br />TOTAL_VENTAS: 884010.64<br />CANTON: SAN CRISTOBAL","density: 5.154773e-08<br />TOTAL_VENTAS: 882063.48<br />CANTON: SAN CRISTOBAL","density: 5.434400e-08<br />TOTAL_VENTAS: 880116.32<br />CANTON: SAN CRISTOBAL","density: 5.722170e-08<br />TOTAL_VENTAS: 878169.16<br />CANTON: SAN CRISTOBAL","density: 6.019159e-08<br />TOTAL_VENTAS: 876222.00<br />CANTON: SAN CRISTOBAL","density: 6.331032e-08<br />TOTAL_VENTAS: 874274.84<br />CANTON: SAN CRISTOBAL","density: 6.651317e-08<br />TOTAL_VENTAS: 872327.68<br />CANTON: SAN CRISTOBAL","density: 6.980415e-08<br />TOTAL_VENTAS: 870380.52<br />CANTON: SAN CRISTOBAL","density: 7.325462e-08<br />TOTAL_VENTAS: 868433.36<br />CANTON: SAN CRISTOBAL","density: 7.679088e-08<br />TOTAL_VENTAS: 866486.20<br />CANTON: SAN CRISTOBAL","density: 8.041298e-08<br />TOTAL_VENTAS: 864539.04<br />CANTON: SAN CRISTOBAL","density: 8.419722e-08<br />TOTAL_VENTAS: 862591.88<br />CANTON: SAN CRISTOBAL","density: 8.807092e-08<br />TOTAL_VENTAS: 860644.72<br />CANTON: SAN CRISTOBAL","density: 9.203087e-08<br />TOTAL_VENTAS: 858697.56<br />CANTON: SAN CRISTOBAL","density: 9.614569e-08<br />TOTAL_VENTAS: 856750.40<br />CANTON: SAN CRISTOBAL","density: 1.003563e-07<br />TOTAL_VENTAS: 854803.24<br />CANTON: SAN CRISTOBAL","density: 1.046523e-07<br />TOTAL_VENTAS: 852856.08<br />CANTON: SAN CRISTOBAL","density: 1.090939e-07<br />TOTAL_VENTAS: 850908.92<br />CANTON: SAN CRISTOBAL","density: 1.136360e-07<br />TOTAL_VENTAS: 848961.76<br />CANTON: SAN CRISTOBAL","density: 1.182615e-07<br />TOTAL_VENTAS: 847014.60<br />CANTON: SAN CRISTOBAL","density: 1.230215e-07<br />TOTAL_VENTAS: 845067.44<br />CANTON: SAN CRISTOBAL","density: 1.278850e-07<br />TOTAL_VENTAS: 843120.28<br />CANTON: SAN CRISTOBAL","density: 1.328284e-07<br />TOTAL_VENTAS: 841173.12<br />CANTON: SAN CRISTOBAL","density: 1.378939e-07<br />TOTAL_VENTAS: 839225.96<br />CANTON: SAN CRISTOBAL","density: 1.430637e-07<br />TOTAL_VENTAS: 837278.80<br />CANTON: SAN CRISTOBAL","density: 1.483088e-07<br />TOTAL_VENTAS: 835331.64<br />CANTON: SAN CRISTOBAL","density: 1.536623e-07<br />TOTAL_VENTAS: 833384.48<br />CANTON: SAN CRISTOBAL","density: 1.591187e-07<br />TOTAL_VENTAS: 831437.32<br />CANTON: SAN CRISTOBAL","density: 1.646444e-07<br />TOTAL_VENTAS: 829490.16<br />CANTON: SAN CRISTOBAL","density: 1.702644e-07<br />TOTAL_VENTAS: 827543.00<br />CANTON: SAN CRISTOBAL","density: 1.759831e-07<br />TOTAL_VENTAS: 825595.84<br />CANTON: SAN CRISTOBAL","density: 1.817643e-07<br />TOTAL_VENTAS: 823648.68<br />CANTON: SAN CRISTOBAL","density: 1.876251e-07<br />TOTAL_VENTAS: 821701.52<br />CANTON: SAN CRISTOBAL","density: 1.935781e-07<br />TOTAL_VENTAS: 819754.36<br />CANTON: SAN CRISTOBAL","density: 1.995856e-07<br />TOTAL_VENTAS: 817807.20<br />CANTON: SAN CRISTOBAL","density: 2.056581e-07<br />TOTAL_VENTAS: 815860.04<br />CANTON: SAN CRISTOBAL","density: 2.118136e-07<br />TOTAL_VENTAS: 813912.88<br />CANTON: SAN CRISTOBAL","density: 2.180147e-07<br />TOTAL_VENTAS: 811965.72<br />CANTON: SAN CRISTOBAL","density: 2.242667e-07<br />TOTAL_VENTAS: 810018.56<br />CANTON: SAN CRISTOBAL","density: 2.305899e-07<br />TOTAL_VENTAS: 808071.40<br />CANTON: SAN CRISTOBAL","density: 2.369490e-07<br />TOTAL_VENTAS: 806124.24<br />CANTON: SAN CRISTOBAL","density: 2.433456e-07<br />TOTAL_VENTAS: 804177.08<br />CANTON: SAN CRISTOBAL","density: 2.497988e-07<br />TOTAL_VENTAS: 802229.92<br />CANTON: SAN CRISTOBAL","density: 2.562779e-07<br />TOTAL_VENTAS: 800282.76<br />CANTON: SAN CRISTOBAL","density: 2.627824e-07<br />TOTAL_VENTAS: 798335.60<br />CANTON: SAN CRISTOBAL","density: 2.693257e-07<br />TOTAL_VENTAS: 796388.44<br />CANTON: SAN CRISTOBAL","density: 2.758846e-07<br />TOTAL_VENTAS: 794441.28<br />CANTON: SAN CRISTOBAL","density: 2.824583e-07<br />TOTAL_VENTAS: 792494.12<br />CANTON: SAN CRISTOBAL","density: 2.890502e-07<br />TOTAL_VENTAS: 790546.96<br />CANTON: SAN CRISTOBAL","density: 2.956474e-07<br />TOTAL_VENTAS: 788599.80<br />CANTON: SAN CRISTOBAL","density: 3.022484e-07<br />TOTAL_VENTAS: 786652.64<br />CANTON: SAN CRISTOBAL","density: 3.088483e-07<br />TOTAL_VENTAS: 784705.48<br />CANTON: SAN CRISTOBAL","density: 3.154411e-07<br />TOTAL_VENTAS: 782758.32<br />CANTON: SAN CRISTOBAL","density: 3.220265e-07<br />TOTAL_VENTAS: 780811.16<br />CANTON: SAN CRISTOBAL","density: 3.285930e-07<br />TOTAL_VENTAS: 778864.00<br />CANTON: SAN CRISTOBAL","density: 3.351381e-07<br />TOTAL_VENTAS: 776916.84<br />CANTON: SAN CRISTOBAL","density: 3.416644e-07<br />TOTAL_VENTAS: 774969.68<br />CANTON: SAN CRISTOBAL","density: 3.481557e-07<br />TOTAL_VENTAS: 773022.52<br />CANTON: SAN CRISTOBAL","density: 3.546096e-07<br />TOTAL_VENTAS: 771075.36<br />CANTON: SAN CRISTOBAL","density: 3.610333e-07<br />TOTAL_VENTAS: 769128.20<br />CANTON: SAN CRISTOBAL","density: 3.674078e-07<br />TOTAL_VENTAS: 767181.04<br />CANTON: SAN CRISTOBAL","density: 3.737271e-07<br />TOTAL_VENTAS: 765233.88<br />CANTON: SAN CRISTOBAL","density: 3.800051e-07<br />TOTAL_VENTAS: 763286.72<br />CANTON: SAN CRISTOBAL","density: 3.862215e-07<br />TOTAL_VENTAS: 761339.56<br />CANTON: SAN CRISTOBAL","density: 3.923635e-07<br />TOTAL_VENTAS: 759392.40<br />CANTON: SAN CRISTOBAL","density: 3.984531e-07<br />TOTAL_VENTAS: 757445.24<br />CANTON: SAN CRISTOBAL","density: 4.044711e-07<br />TOTAL_VENTAS: 755498.08<br />CANTON: SAN CRISTOBAL","density: 4.103940e-07<br />TOTAL_VENTAS: 753550.92<br />CANTON: SAN CRISTOBAL","density: 4.162542e-07<br />TOTAL_VENTAS: 751603.76<br />CANTON: SAN CRISTOBAL","density: 4.220345e-07<br />TOTAL_VENTAS: 749656.60<br />CANTON: SAN CRISTOBAL","density: 4.276983e-07<br />TOTAL_VENTAS: 747709.44<br />CANTON: SAN CRISTOBAL","density: 4.332892e-07<br />TOTAL_VENTAS: 745762.28<br />CANTON: SAN CRISTOBAL","density: 4.387945e-07<br />TOTAL_VENTAS: 743815.12<br />CANTON: SAN CRISTOBAL","density: 4.441613e-07<br />TOTAL_VENTAS: 741867.96<br />CANTON: SAN CRISTOBAL","density: 4.494456e-07<br />TOTAL_VENTAS: 739920.80<br />CANTON: SAN CRISTOBAL","density: 4.546408e-07<br />TOTAL_VENTAS: 737973.64<br />CANTON: SAN CRISTOBAL","density: 4.596750e-07<br />TOTAL_VENTAS: 736026.48<br />CANTON: SAN CRISTOBAL","density: 4.646181e-07<br />TOTAL_VENTAS: 734079.32<br />CANTON: SAN CRISTOBAL","density: 4.694700e-07<br />TOTAL_VENTAS: 732132.16<br />CANTON: SAN CRISTOBAL","density: 4.741402e-07<br />TOTAL_VENTAS: 730185.00<br />CANTON: SAN CRISTOBAL","density: 4.787109e-07<br />TOTAL_VENTAS: 728237.84<br />CANTON: SAN CRISTOBAL","density: 4.831827e-07<br />TOTAL_VENTAS: 726290.68<br />CANTON: SAN CRISTOBAL","density: 4.874681e-07<br />TOTAL_VENTAS: 724343.52<br />CANTON: SAN CRISTOBAL","density: 4.916389e-07<br />TOTAL_VENTAS: 722396.36<br />CANTON: SAN CRISTOBAL","density: 4.957043e-07<br />TOTAL_VENTAS: 720449.20<br />CANTON: SAN CRISTOBAL","density: 4.995815e-07<br />TOTAL_VENTAS: 718502.04<br />CANTON: SAN CRISTOBAL","density: 5.033294e-07<br />TOTAL_VENTAS: 716554.88<br />CANTON: SAN CRISTOBAL","density: 5.069665e-07<br />TOTAL_VENTAS: 714607.72<br />CANTON: SAN CRISTOBAL","density: 5.104165e-07<br />TOTAL_VENTAS: 712660.56<br />CANTON: SAN CRISTOBAL","density: 5.137231e-07<br />TOTAL_VENTAS: 710713.40<br />CANTON: SAN CRISTOBAL","density: 5.169147e-07<br />TOTAL_VENTAS: 708766.24<br />CANTON: SAN CRISTOBAL","density: 5.199231e-07<br />TOTAL_VENTAS: 706819.08<br />CANTON: SAN CRISTOBAL","density: 5.227748e-07<br />TOTAL_VENTAS: 704871.92<br />CANTON: SAN CRISTOBAL","density: 5.255089e-07<br />TOTAL_VENTAS: 702924.76<br />CANTON: SAN CRISTOBAL","density: 5.280658e-07<br />TOTAL_VENTAS: 700977.60<br />CANTON: SAN CRISTOBAL","density: 5.304541e-07<br />TOTAL_VENTAS: 699030.44<br />CANTON: SAN CRISTOBAL","density: 5.327234e-07<br />TOTAL_VENTAS: 697083.28<br />CANTON: SAN CRISTOBAL","density: 5.348238e-07<br />TOTAL_VENTAS: 695136.12<br />CANTON: SAN CRISTOBAL","density: 5.367450e-07<br />TOTAL_VENTAS: 693188.96<br />CANTON: SAN CRISTOBAL","density: 5.385471e-07<br />TOTAL_VENTAS: 691241.80<br />CANTON: SAN CRISTOBAL","density: 5.401902e-07<br />TOTAL_VENTAS: 689294.64<br />CANTON: SAN CRISTOBAL","density: 5.416453e-07<br />TOTAL_VENTAS: 687347.48<br />CANTON: SAN CRISTOBAL","density: 5.429823e-07<br />TOTAL_VENTAS: 685400.32<br />CANTON: SAN CRISTOBAL","density: 5.441715e-07<br />TOTAL_VENTAS: 683453.16<br />CANTON: SAN CRISTOBAL","density: 5.451658e-07<br />TOTAL_VENTAS: 681506.00<br />CANTON: SAN CRISTOBAL","density: 5.460438e-07<br />TOTAL_VENTAS: 679558.84<br />CANTON: SAN CRISTOBAL","density: 5.467862e-07<br />TOTAL_VENTAS: 677611.68<br />CANTON: SAN CRISTOBAL","density: 5.473283e-07<br />TOTAL_VENTAS: 675664.52<br />CANTON: SAN CRISTOBAL","density: 5.477570e-07<br />TOTAL_VENTAS: 673717.36<br />CANTON: SAN CRISTOBAL","density: 5.480627e-07<br />TOTAL_VENTAS: 671770.20<br />CANTON: SAN CRISTOBAL","density: 5.481645e-07<br />TOTAL_VENTAS: 669823.04<br />CANTON: SAN CRISTOBAL","density: 5.481564e-07<br />TOTAL_VENTAS: 667875.88<br />CANTON: SAN CRISTOBAL","density: 5.480381e-07<br />TOTAL_VENTAS: 665928.72<br />CANTON: SAN CRISTOBAL","density: 5.477138e-07<br />TOTAL_VENTAS: 663981.56<br />CANTON: SAN CRISTOBAL","density: 5.472837e-07<br />TOTAL_VENTAS: 662034.40<br />CANTON: SAN CRISTOBAL","density: 5.467481e-07<br />TOTAL_VENTAS: 660087.24<br />CANTON: SAN CRISTOBAL","density: 5.460217e-07<br />TOTAL_VENTAS: 658140.08<br />CANTON: SAN CRISTOBAL","density: 5.451862e-07<br />TOTAL_VENTAS: 656192.92<br />CANTON: SAN CRISTOBAL","density: 5.442495e-07<br />TOTAL_VENTAS: 654245.76<br />CANTON: SAN CRISTOBAL","density: 5.431384e-07<br />TOTAL_VENTAS: 652298.60<br />CANTON: SAN CRISTOBAL","density: 5.419150e-07<br />TOTAL_VENTAS: 650351.44<br />CANTON: SAN CRISTOBAL","density: 5.405954e-07<br />TOTAL_VENTAS: 648404.28<br />CANTON: SAN CRISTOBAL","density: 5.391172e-07<br />TOTAL_VENTAS: 646457.12<br />CANTON: SAN CRISTOBAL","density: 5.375248e-07<br />TOTAL_VENTAS: 644509.96<br />CANTON: SAN CRISTOBAL","density: 5.358411e-07<br />TOTAL_VENTAS: 642562.80<br />CANTON: SAN CRISTOBAL","density: 5.340145e-07<br />TOTAL_VENTAS: 640615.64<br />CANTON: SAN CRISTOBAL","density: 5.320726e-07<br />TOTAL_VENTAS: 638668.48<br />CANTON: SAN CRISTOBAL","density: 5.300447e-07<br />TOTAL_VENTAS: 636721.32<br />CANTON: SAN CRISTOBAL","density: 5.278890e-07<br />TOTAL_VENTAS: 634774.16<br />CANTON: SAN CRISTOBAL","density: 5.256183e-07<br />TOTAL_VENTAS: 632827.00<br />CANTON: SAN CRISTOBAL","density: 5.232672e-07<br />TOTAL_VENTAS: 630879.84<br />CANTON: SAN CRISTOBAL","density: 5.208029e-07<br />TOTAL_VENTAS: 628932.68<br />CANTON: SAN CRISTOBAL","density: 5.182252e-07<br />TOTAL_VENTAS: 626985.52<br />CANTON: SAN CRISTOBAL","density: 5.155731e-07<br />TOTAL_VENTAS: 625038.36<br />CANTON: SAN CRISTOBAL","density: 5.128221e-07<br />TOTAL_VENTAS: 623091.20<br />CANTON: SAN CRISTOBAL","density: 5.099612e-07<br />TOTAL_VENTAS: 621144.04<br />CANTON: SAN CRISTOBAL","density: 5.070322e-07<br />TOTAL_VENTAS: 619196.88<br />CANTON: SAN CRISTOBAL","density: 5.040186e-07<br />TOTAL_VENTAS: 617249.72<br />CANTON: SAN CRISTOBAL","density: 5.009003e-07<br />TOTAL_VENTAS: 615302.56<br />CANTON: SAN CRISTOBAL","density: 4.977212e-07<br />TOTAL_VENTAS: 613355.40<br />CANTON: SAN CRISTOBAL","density: 4.944714e-07<br />TOTAL_VENTAS: 611408.24<br />CANTON: SAN CRISTOBAL","density: 4.911246e-07<br />TOTAL_VENTAS: 609461.08<br />CANTON: SAN CRISTOBAL","density: 4.877252e-07<br />TOTAL_VENTAS: 607513.92<br />CANTON: SAN CRISTOBAL","density: 4.842688e-07<br />TOTAL_VENTAS: 605566.76<br />CANTON: SAN CRISTOBAL","density: 4.807261e-07<br />TOTAL_VENTAS: 603619.60<br />CANTON: SAN CRISTOBAL","density: 4.771402e-07<br />TOTAL_VENTAS: 601672.44<br />CANTON: SAN CRISTOBAL","density: 4.735105e-07<br />TOTAL_VENTAS: 599725.28<br />CANTON: SAN CRISTOBAL","density: 4.698088e-07<br />TOTAL_VENTAS: 597778.12<br />CANTON: SAN CRISTOBAL","density: 4.660742e-07<br />TOTAL_VENTAS: 595830.96<br />CANTON: SAN CRISTOBAL","density: 4.623072e-07<br />TOTAL_VENTAS: 593883.80<br />CANTON: SAN CRISTOBAL","density: 4.584896e-07<br />TOTAL_VENTAS: 591936.64<br />CANTON: SAN CRISTOBAL","density: 4.546493e-07<br />TOTAL_VENTAS: 589989.48<br />CANTON: SAN CRISTOBAL","density: 4.507884e-07<br />TOTAL_VENTAS: 588042.32<br />CANTON: SAN CRISTOBAL","density: 4.469003e-07<br />TOTAL_VENTAS: 586095.16<br />CANTON: SAN CRISTOBAL","density: 4.430020e-07<br />TOTAL_VENTAS: 584148.00<br />CANTON: SAN CRISTOBAL","density: 4.390964e-07<br />TOTAL_VENTAS: 582200.84<br />CANTON: SAN CRISTOBAL","density: 4.351871e-07<br />TOTAL_VENTAS: 580253.68<br />CANTON: SAN CRISTOBAL","density: 4.312837e-07<br />TOTAL_VENTAS: 578306.52<br />CANTON: SAN CRISTOBAL","density: 4.273874e-07<br />TOTAL_VENTAS: 576359.36<br />CANTON: SAN CRISTOBAL","density: 4.235106e-07<br />TOTAL_VENTAS: 574412.20<br />CANTON: SAN CRISTOBAL","density: 4.196596e-07<br />TOTAL_VENTAS: 572465.04<br />CANTON: SAN CRISTOBAL","density: 4.158312e-07<br />TOTAL_VENTAS: 570517.88<br />CANTON: SAN CRISTOBAL","density: 4.120447e-07<br />TOTAL_VENTAS: 568570.72<br />CANTON: SAN CRISTOBAL","density: 4.083074e-07<br />TOTAL_VENTAS: 566623.56<br />CANTON: SAN CRISTOBAL","density: 4.046093e-07<br />TOTAL_VENTAS: 564676.40<br />CANTON: SAN CRISTOBAL","density: 4.009740e-07<br />TOTAL_VENTAS: 562729.24<br />CANTON: SAN CRISTOBAL","density: 3.974147e-07<br />TOTAL_VENTAS: 560782.08<br />CANTON: SAN CRISTOBAL","density: 3.939117e-07<br />TOTAL_VENTAS: 558834.92<br />CANTON: SAN CRISTOBAL","density: 3.904902e-07<br />TOTAL_VENTAS: 556887.76<br />CANTON: SAN CRISTOBAL","density: 3.871748e-07<br />TOTAL_VENTAS: 554940.60<br />CANTON: SAN CRISTOBAL","density: 3.839328e-07<br />TOTAL_VENTAS: 552993.44<br />CANTON: SAN CRISTOBAL","density: 3.807885e-07<br />TOTAL_VENTAS: 551046.28<br />CANTON: SAN CRISTOBAL","density: 3.777826e-07<br />TOTAL_VENTAS: 549099.12<br />CANTON: SAN CRISTOBAL","density: 3.748668e-07<br />TOTAL_VENTAS: 547151.96<br />CANTON: SAN CRISTOBAL","density: 3.720617e-07<br />TOTAL_VENTAS: 545204.80<br />CANTON: SAN CRISTOBAL","density: 3.694287e-07<br />TOTAL_VENTAS: 543257.64<br />CANTON: SAN CRISTOBAL","density: 3.669016e-07<br />TOTAL_VENTAS: 541310.48<br />CANTON: SAN CRISTOBAL","density: 3.644945e-07<br />TOTAL_VENTAS: 539363.32<br />CANTON: SAN CRISTOBAL","density: 3.622934e-07<br />TOTAL_VENTAS: 537416.16<br />CANTON: SAN CRISTOBAL","density: 3.602125e-07<br />TOTAL_VENTAS: 535469.00<br />CANTON: SAN CRISTOBAL","density: 3.582566e-07<br />TOTAL_VENTAS: 533521.84<br />CANTON: SAN CRISTOBAL","density: 3.565398e-07<br />TOTAL_VENTAS: 531574.68<br />CANTON: SAN CRISTOBAL","density: 3.549550e-07<br />TOTAL_VENTAS: 529627.52<br />CANTON: SAN CRISTOBAL","density: 3.535028e-07<br />TOTAL_VENTAS: 527680.36<br />CANTON: SAN CRISTOBAL","density: 3.523067e-07<br />TOTAL_VENTAS: 525733.20<br />CANTON: SAN CRISTOBAL","density: 3.512584e-07<br />TOTAL_VENTAS: 523786.04<br />CANTON: SAN CRISTOBAL","density: 3.503515e-07<br />TOTAL_VENTAS: 521838.88<br />CANTON: SAN CRISTOBAL","density: 3.497023e-07<br />TOTAL_VENTAS: 519891.72<br />CANTON: SAN CRISTOBAL","density: 3.492186e-07<br />TOTAL_VENTAS: 517944.56<br />CANTON: SAN CRISTOBAL","density: 3.488817e-07<br />TOTAL_VENTAS: 515997.40<br />CANTON: SAN CRISTOBAL","density: 3.487970e-07<br />TOTAL_VENTAS: 514050.24<br />CANTON: SAN CRISTOBAL","density: 3.488922e-07<br />TOTAL_VENTAS: 512103.08<br />CANTON: SAN CRISTOBAL","density: 3.491355e-07<br />TOTAL_VENTAS: 510155.92<br />CANTON: SAN CRISTOBAL","density: 3.496188e-07<br />TOTAL_VENTAS: 508208.76<br />CANTON: SAN CRISTOBAL","density: 3.502914e-07<br />TOTAL_VENTAS: 506261.60<br />CANTON: SAN CRISTOBAL","density: 3.511093e-07<br />TOTAL_VENTAS: 504314.44<br />CANTON: SAN CRISTOBAL","density: 3.521486e-07<br />TOTAL_VENTAS: 502367.28<br />CANTON: SAN CRISTOBAL","density: 3.533807e-07<br />TOTAL_VENTAS: 500420.12<br />CANTON: SAN CRISTOBAL","density: 3.547507e-07<br />TOTAL_VENTAS: 498472.96<br />CANTON: SAN CRISTOBAL","density: 3.563181e-07<br />TOTAL_VENTAS: 496525.80<br />CANTON: SAN CRISTOBAL","density: 3.580746e-07<br />TOTAL_VENTAS: 494578.64<br />CANTON: SAN CRISTOBAL","density: 3.599572e-07<br />TOTAL_VENTAS: 492631.48<br />CANTON: SAN CRISTOBAL","density: 3.620089e-07<br />TOTAL_VENTAS: 490684.32<br />CANTON: SAN CRISTOBAL","density: 3.642382e-07<br />TOTAL_VENTAS: 488737.16<br />CANTON: SAN CRISTOBAL","density: 3.665774e-07<br />TOTAL_VENTAS: 486790.00<br />CANTON: SAN CRISTOBAL","density: 3.690546e-07<br />TOTAL_VENTAS: 484842.84<br />CANTON: SAN CRISTOBAL","density: 3.716894e-07<br />TOTAL_VENTAS: 482895.68<br />CANTON: SAN CRISTOBAL","density: 3.744142e-07<br />TOTAL_VENTAS: 480948.52<br />CANTON: SAN CRISTOBAL","density: 3.772444e-07<br />TOTAL_VENTAS: 479001.36<br />CANTON: SAN CRISTOBAL","density: 3.802041e-07<br />TOTAL_VENTAS: 477054.20<br />CANTON: SAN CRISTOBAL","density: 3.832306e-07<br />TOTAL_VENTAS: 475107.04<br />CANTON: SAN CRISTOBAL","density: 3.863299e-07<br />TOTAL_VENTAS: 473159.88<br />CANTON: SAN CRISTOBAL","density: 3.895227e-07<br />TOTAL_VENTAS: 471212.72<br />CANTON: SAN CRISTOBAL","density: 3.927571e-07<br />TOTAL_VENTAS: 469265.56<br />CANTON: SAN CRISTOBAL","density: 3.960331e-07<br />TOTAL_VENTAS: 467318.40<br />CANTON: SAN CRISTOBAL","density: 3.993599e-07<br />TOTAL_VENTAS: 465371.24<br />CANTON: SAN CRISTOBAL","density: 4.027016e-07<br />TOTAL_VENTAS: 463424.08<br />CANTON: SAN CRISTOBAL","density: 4.060570e-07<br />TOTAL_VENTAS: 461476.92<br />CANTON: SAN CRISTOBAL","density: 4.094149e-07<br />TOTAL_VENTAS: 459529.76<br />CANTON: SAN CRISTOBAL","density: 4.127608e-07<br />TOTAL_VENTAS: 457582.60<br />CANTON: SAN CRISTOBAL","density: 4.160938e-07<br />TOTAL_VENTAS: 455635.44<br />CANTON: SAN CRISTOBAL","density: 4.193834e-07<br />TOTAL_VENTAS: 453688.28<br />CANTON: SAN CRISTOBAL","density: 4.226325e-07<br />TOTAL_VENTAS: 451741.12<br />CANTON: SAN CRISTOBAL","density: 4.258429e-07<br />TOTAL_VENTAS: 449793.96<br />CANTON: SAN CRISTOBAL","density: 4.289708e-07<br />TOTAL_VENTAS: 447846.80<br />CANTON: SAN CRISTOBAL","density: 4.320277e-07<br />TOTAL_VENTAS: 445899.64<br />CANTON: SAN CRISTOBAL","density: 4.350227e-07<br />TOTAL_VENTAS: 443952.48<br />CANTON: SAN CRISTOBAL","density: 4.379038e-07<br />TOTAL_VENTAS: 442005.32<br />CANTON: SAN CRISTOBAL","density: 4.406837e-07<br />TOTAL_VENTAS: 440058.16<br />CANTON: SAN CRISTOBAL","density: 4.433816e-07<br />TOTAL_VENTAS: 438111.00<br />CANTON: SAN CRISTOBAL","density: 4.459432e-07<br />TOTAL_VENTAS: 436163.84<br />CANTON: SAN CRISTOBAL","density: 4.483752e-07<br />TOTAL_VENTAS: 434216.68<br />CANTON: SAN CRISTOBAL","density: 4.507093e-07<br />TOTAL_VENTAS: 432269.52<br />CANTON: SAN CRISTOBAL","density: 4.528938e-07<br />TOTAL_VENTAS: 430322.36<br />CANTON: SAN CRISTOBAL","density: 4.549242e-07<br />TOTAL_VENTAS: 428375.20<br />CANTON: SAN CRISTOBAL","density: 4.568457e-07<br />TOTAL_VENTAS: 426428.04<br />CANTON: SAN CRISTOBAL","density: 4.586133e-07<br />TOTAL_VENTAS: 424480.88<br />CANTON: SAN CRISTOBAL","density: 4.602078e-07<br />TOTAL_VENTAS: 422533.72<br />CANTON: SAN CRISTOBAL","density: 4.616881e-07<br />TOTAL_VENTAS: 420586.56<br />CANTON: SAN CRISTOBAL","density: 4.630182e-07<br />TOTAL_VENTAS: 418639.40<br />CANTON: SAN CRISTOBAL","density: 4.641636e-07<br />TOTAL_VENTAS: 416692.24<br />CANTON: SAN CRISTOBAL","density: 4.651950e-07<br />TOTAL_VENTAS: 414745.08<br />CANTON: SAN CRISTOBAL","density: 4.660872e-07<br />TOTAL_VENTAS: 412797.92<br />CANTON: SAN CRISTOBAL","density: 4.667917e-07<br />TOTAL_VENTAS: 410850.76<br />CANTON: SAN CRISTOBAL","density: 4.673881e-07<br />TOTAL_VENTAS: 408903.60<br />CANTON: SAN CRISTOBAL","density: 4.678619e-07<br />TOTAL_VENTAS: 406956.44<br />CANTON: SAN CRISTOBAL","density: 4.681544e-07<br />TOTAL_VENTAS: 405009.28<br />CANTON: SAN CRISTOBAL","density: 4.683500e-07<br />TOTAL_VENTAS: 403062.12<br />CANTON: SAN CRISTOBAL","density: 4.684435e-07<br />TOTAL_VENTAS: 401114.96<br />CANTON: SAN CRISTOBAL","density: 4.683722e-07<br />TOTAL_VENTAS: 399167.80<br />CANTON: SAN CRISTOBAL","density: 4.682196e-07<br />TOTAL_VENTAS: 397220.64<br />CANTON: SAN CRISTOBAL","density: 4.679865e-07<br />TOTAL_VENTAS: 395273.48<br />CANTON: SAN CRISTOBAL","density: 4.676173e-07<br />TOTAL_VENTAS: 393326.32<br />CANTON: SAN CRISTOBAL","density: 4.671850e-07<br />TOTAL_VENTAS: 391379.16<br />CANTON: SAN CRISTOBAL","density: 4.666918e-07<br />TOTAL_VENTAS: 389432.00<br />CANTON: SAN CRISTOBAL","density: 4.661051e-07<br />TOTAL_VENTAS: 387484.84<br />CANTON: SAN CRISTOBAL","density: 4.654736e-07<br />TOTAL_VENTAS: 385537.68<br />CANTON: SAN CRISTOBAL","density: 4.648036e-07<br />TOTAL_VENTAS: 383590.52<br />CANTON: SAN CRISTOBAL","density: 4.640827e-07<br />TOTAL_VENTAS: 381643.36<br />CANTON: SAN CRISTOBAL","density: 4.633408e-07<br />TOTAL_VENTAS: 379696.20<br />CANTON: SAN CRISTOBAL","density: 4.625842e-07<br />TOTAL_VENTAS: 377749.04<br />CANTON: SAN CRISTOBAL","density: 4.618173e-07<br />TOTAL_VENTAS: 375801.88<br />CANTON: SAN CRISTOBAL","density: 4.610573e-07<br />TOTAL_VENTAS: 373854.72<br />CANTON: SAN CRISTOBAL","density: 4.603067e-07<br />TOTAL_VENTAS: 371907.56<br />CANTON: SAN CRISTOBAL","density: 4.595825e-07<br />TOTAL_VENTAS: 369960.40<br />CANTON: SAN CRISTOBAL","density: 4.588960e-07<br />TOTAL_VENTAS: 368013.24<br />CANTON: SAN CRISTOBAL","density: 4.582420e-07<br />TOTAL_VENTAS: 366066.08<br />CANTON: SAN CRISTOBAL","density: 4.576456e-07<br />TOTAL_VENTAS: 364118.92<br />CANTON: SAN CRISTOBAL","density: 4.571190e-07<br />TOTAL_VENTAS: 362171.76<br />CANTON: SAN CRISTOBAL","density: 4.566461e-07<br />TOTAL_VENTAS: 360224.60<br />CANTON: SAN CRISTOBAL","density: 4.562551e-07<br />TOTAL_VENTAS: 358277.44<br />CANTON: SAN CRISTOBAL","density: 4.559656e-07<br />TOTAL_VENTAS: 356330.28<br />CANTON: SAN CRISTOBAL","density: 4.557479e-07<br />TOTAL_VENTAS: 354383.12<br />CANTON: SAN CRISTOBAL","density: 4.556294e-07<br />TOTAL_VENTAS: 352435.96<br />CANTON: SAN CRISTOBAL","density: 4.556417e-07<br />TOTAL_VENTAS: 350488.80<br />CANTON: SAN CRISTOBAL","density: 4.557399e-07<br />TOTAL_VENTAS: 348541.64<br />CANTON: SAN CRISTOBAL","density: 4.559473e-07<br />TOTAL_VENTAS: 346594.48<br />CANTON: SAN CRISTOBAL","density: 4.563106e-07<br />TOTAL_VENTAS: 344647.32<br />CANTON: SAN CRISTOBAL","density: 4.567697e-07<br />TOTAL_VENTAS: 342700.16<br />CANTON: SAN CRISTOBAL","density: 4.573409e-07<br />TOTAL_VENTAS: 340753.00<br />CANTON: SAN CRISTOBAL","density: 4.580873e-07<br />TOTAL_VENTAS: 338805.84<br />CANTON: SAN CRISTOBAL","density: 4.589346e-07<br />TOTAL_VENTAS: 336858.68<br />CANTON: SAN CRISTOBAL","density: 4.598909e-07<br />TOTAL_VENTAS: 334911.52<br />CANTON: SAN CRISTOBAL","density: 4.610346e-07<br />TOTAL_VENTAS: 332964.36<br />CANTON: SAN CRISTOBAL","density: 4.622794e-07<br />TOTAL_VENTAS: 331017.20<br />CANTON: SAN CRISTOBAL","density: 4.636255e-07<br />TOTAL_VENTAS: 329070.04<br />CANTON: SAN CRISTOBAL","density: 4.651620e-07<br />TOTAL_VENTAS: 327122.88<br />CANTON: SAN CRISTOBAL","density: 4.667960e-07<br />TOTAL_VENTAS: 325175.72<br />CANTON: SAN CRISTOBAL","density: 4.685267e-07<br />TOTAL_VENTAS: 323228.56<br />CANTON: SAN CRISTOBAL","density: 4.704284e-07<br />TOTAL_VENTAS: 321281.40<br />CANTON: SAN CRISTOBAL","density: 4.724268e-07<br />TOTAL_VENTAS: 319334.24<br />CANTON: SAN CRISTOBAL","density: 4.745133e-07<br />TOTAL_VENTAS: 317387.08<br />CANTON: SAN CRISTOBAL","density: 4.767461e-07<br />TOTAL_VENTAS: 315439.92<br />CANTON: SAN CRISTOBAL","density: 4.790700e-07<br />TOTAL_VENTAS: 313492.76<br />CANTON: SAN CRISTOBAL","density: 4.814700e-07<br />TOTAL_VENTAS: 311545.60<br />CANTON: SAN CRISTOBAL","density: 4.839887e-07<br />TOTAL_VENTAS: 309598.44<br />CANTON: SAN CRISTOBAL","density: 4.865879e-07<br />TOTAL_VENTAS: 307651.28<br />CANTON: SAN CRISTOBAL","density: 4.892490e-07<br />TOTAL_VENTAS: 305704.12<br />CANTON: SAN CRISTOBAL","density: 4.920000e-07<br />TOTAL_VENTAS: 303756.96<br />CANTON: SAN CRISTOBAL","density: 4.948169e-07<br />TOTAL_VENTAS: 301809.80<br />CANTON: SAN CRISTOBAL","density: 4.976798e-07<br />TOTAL_VENTAS: 299862.64<br />CANTON: SAN CRISTOBAL","density: 5.006050e-07<br />TOTAL_VENTAS: 297915.48<br />CANTON: SAN CRISTOBAL","density: 5.035782e-07<br />TOTAL_VENTAS: 295968.32<br />CANTON: SAN CRISTOBAL","density: 5.065815e-07<br />TOTAL_VENTAS: 294021.16<br />CANTON: SAN CRISTOBAL","density: 5.096220e-07<br />TOTAL_VENTAS: 292074.00<br />CANTON: SAN CRISTOBAL","density: 5.126909e-07<br />TOTAL_VENTAS: 290126.84<br />CANTON: SAN CRISTOBAL","density: 5.157749e-07<br />TOTAL_VENTAS: 288179.68<br />CANTON: SAN CRISTOBAL","density: 5.188750e-07<br />TOTAL_VENTAS: 286232.52<br />CANTON: SAN CRISTOBAL","density: 5.219842e-07<br />TOTAL_VENTAS: 284285.36<br />CANTON: SAN CRISTOBAL","density: 5.250954e-07<br />TOTAL_VENTAS: 282338.20<br />CANTON: SAN CRISTOBAL","density: 5.282066e-07<br />TOTAL_VENTAS: 280391.04<br />CANTON: SAN CRISTOBAL","density: 5.313097e-07<br />TOTAL_VENTAS: 278443.88<br />CANTON: SAN CRISTOBAL","density: 5.344049e-07<br />TOTAL_VENTAS: 276496.72<br />CANTON: SAN CRISTOBAL","density: 5.374897e-07<br />TOTAL_VENTAS: 274549.56<br />CANTON: SAN CRISTOBAL","density: 5.405535e-07<br />TOTAL_VENTAS: 272602.40<br />CANTON: SAN CRISTOBAL","density: 5.436037e-07<br />TOTAL_VENTAS: 270655.24<br />CANTON: SAN CRISTOBAL","density: 5.466387e-07<br />TOTAL_VENTAS: 268708.08<br />CANTON: SAN CRISTOBAL","density: 5.496466e-07<br />TOTAL_VENTAS: 266760.92<br />CANTON: SAN CRISTOBAL","density: 5.526402e-07<br />TOTAL_VENTAS: 264813.76<br />CANTON: SAN CRISTOBAL","density: 5.556192e-07<br />TOTAL_VENTAS: 262866.60<br />CANTON: SAN CRISTOBAL","density: 5.585741e-07<br />TOTAL_VENTAS: 260919.44<br />CANTON: SAN CRISTOBAL","density: 5.615195e-07<br />TOTAL_VENTAS: 258972.28<br />CANTON: SAN CRISTOBAL","density: 5.644557e-07<br />TOTAL_VENTAS: 257025.12<br />CANTON: SAN CRISTOBAL","density: 5.673828e-07<br />TOTAL_VENTAS: 255077.96<br />CANTON: SAN CRISTOBAL","density: 5.703109e-07<br />TOTAL_VENTAS: 253130.80<br />CANTON: SAN CRISTOBAL","density: 5.732413e-07<br />TOTAL_VENTAS: 251183.64<br />CANTON: SAN CRISTOBAL","density: 5.761866e-07<br />TOTAL_VENTAS: 249236.48<br />CANTON: SAN CRISTOBAL","density: 5.791522e-07<br />TOTAL_VENTAS: 247289.32<br />CANTON: SAN CRISTOBAL","density: 5.821379e-07<br />TOTAL_VENTAS: 245342.16<br />CANTON: SAN CRISTOBAL","density: 5.851708e-07<br />TOTAL_VENTAS: 243395.00<br />CANTON: SAN CRISTOBAL","density: 5.882535e-07<br />TOTAL_VENTAS: 241447.84<br />CANTON: SAN CRISTOBAL","density: 5.913807e-07<br />TOTAL_VENTAS: 239500.68<br />CANTON: SAN CRISTOBAL","density: 5.945940e-07<br />TOTAL_VENTAS: 237553.52<br />CANTON: SAN CRISTOBAL","density: 5.978984e-07<br />TOTAL_VENTAS: 235606.36<br />CANTON: SAN CRISTOBAL","density: 6.012784e-07<br />TOTAL_VENTAS: 233659.20<br />CANTON: SAN CRISTOBAL","density: 6.047884e-07<br />TOTAL_VENTAS: 231712.04<br />CANTON: SAN CRISTOBAL","density: 6.084440e-07<br />TOTAL_VENTAS: 229764.88<br />CANTON: SAN CRISTOBAL","density: 6.122130e-07<br />TOTAL_VENTAS: 227817.72<br />CANTON: SAN CRISTOBAL","density: 6.161591e-07<br />TOTAL_VENTAS: 225870.56<br />CANTON: SAN CRISTOBAL","density: 6.203198e-07<br />TOTAL_VENTAS: 223923.40<br />CANTON: SAN CRISTOBAL","density: 6.246378e-07<br />TOTAL_VENTAS: 221976.24<br />CANTON: SAN CRISTOBAL","density: 6.291816e-07<br />TOTAL_VENTAS: 220029.08<br />CANTON: SAN CRISTOBAL","density: 6.340243e-07<br />TOTAL_VENTAS: 218081.92<br />CANTON: SAN CRISTOBAL","density: 6.390742e-07<br />TOTAL_VENTAS: 216134.76<br />CANTON: SAN CRISTOBAL","density: 6.443982e-07<br />TOTAL_VENTAS: 214187.60<br />CANTON: SAN CRISTOBAL","density: 6.501216e-07<br />TOTAL_VENTAS: 212240.44<br />CANTON: SAN CRISTOBAL","density: 6.561074e-07<br />TOTAL_VENTAS: 210293.28<br />CANTON: SAN CRISTOBAL","density: 6.624134e-07<br />TOTAL_VENTAS: 208346.12<br />CANTON: SAN CRISTOBAL","density: 6.692359e-07<br />TOTAL_VENTAS: 206398.96<br />CANTON: SAN CRISTOBAL","density: 6.763808e-07<br />TOTAL_VENTAS: 204451.80<br />CANTON: SAN CRISTOBAL","density: 6.838881e-07<br />TOTAL_VENTAS: 202504.64<br />CANTON: SAN CRISTOBAL","density: 6.920454e-07<br />TOTAL_VENTAS: 200557.48<br />CANTON: SAN CRISTOBAL","density: 7.005894e-07<br />TOTAL_VENTAS: 198610.32<br />CANTON: SAN CRISTOBAL","density: 7.095321e-07<br />TOTAL_VENTAS: 196663.16<br />CANTON: SAN CRISTOBAL","density: 7.192748e-07<br />TOTAL_VENTAS: 194716.00<br />CANTON: SAN CRISTOBAL","density: 7.294715e-07<br />TOTAL_VENTAS: 192768.84<br />CANTON: SAN CRISTOBAL","density: 7.401251e-07<br />TOTAL_VENTAS: 190821.68<br />CANTON: SAN CRISTOBAL","density: 7.516857e-07<br />TOTAL_VENTAS: 188874.52<br />CANTON: SAN CRISTOBAL","density: 7.637991e-07<br />TOTAL_VENTAS: 186927.36<br />CANTON: SAN CRISTOBAL","density: 7.764391e-07<br />TOTAL_VENTAS: 184980.20<br />CANTON: SAN CRISTOBAL","density: 7.900660e-07<br />TOTAL_VENTAS: 183033.04<br />CANTON: SAN CRISTOBAL","density: 8.043660e-07<br />TOTAL_VENTAS: 181085.88<br />CANTON: SAN CRISTOBAL","density: 8.192631e-07<br />TOTAL_VENTAS: 179138.72<br />CANTON: SAN CRISTOBAL","density: 8.352163e-07<br />TOTAL_VENTAS: 177191.56<br />CANTON: SAN CRISTOBAL","density: 8.519735e-07<br />TOTAL_VENTAS: 175244.40<br />CANTON: SAN CRISTOBAL","density: 8.693977e-07<br />TOTAL_VENTAS: 173297.24<br />CANTON: SAN CRISTOBAL","density: 8.879339e-07<br />TOTAL_VENTAS: 171350.08<br />CANTON: SAN CRISTOBAL","density: 9.074135e-07<br />TOTAL_VENTAS: 169402.92<br />CANTON: SAN CRISTOBAL","density: 9.276275e-07<br />TOTAL_VENTAS: 167455.76<br />CANTON: SAN CRISTOBAL","density: 9.489942e-07<br />TOTAL_VENTAS: 165508.60<br />CANTON: SAN CRISTOBAL","density: 9.714488e-07<br />TOTAL_VENTAS: 163561.44<br />CANTON: SAN CRISTOBAL","density: 9.947005e-07<br />TOTAL_VENTAS: 161614.28<br />CANTON: SAN CRISTOBAL","density: 1.019128e-06<br />TOTAL_VENTAS: 159667.12<br />CANTON: SAN CRISTOBAL","density: 1.044789e-06<br />TOTAL_VENTAS: 157719.96<br />CANTON: SAN CRISTOBAL","density: 1.071303e-06<br />TOTAL_VENTAS: 155772.80<br />CANTON: SAN CRISTOBAL","density: 1.098996e-06<br />TOTAL_VENTAS: 153825.64<br />CANTON: SAN CRISTOBAL","density: 1.128065e-06<br />TOTAL_VENTAS: 151878.48<br />CANTON: SAN CRISTOBAL","density: 1.158032e-06<br />TOTAL_VENTAS: 149931.32<br />CANTON: SAN CRISTOBAL","density: 1.189161e-06<br />TOTAL_VENTAS: 147984.16<br />CANTON: SAN CRISTOBAL","density: 1.221797e-06<br />TOTAL_VENTAS: 146037.00<br />CANTON: SAN CRISTOBAL","density: 1.255364e-06<br />TOTAL_VENTAS: 144089.84<br />CANTON: SAN CRISTOBAL","density: 1.290054e-06<br />TOTAL_VENTAS: 142142.68<br />CANTON: SAN CRISTOBAL","density: 1.326364e-06<br />TOTAL_VENTAS: 140195.52<br />CANTON: SAN CRISTOBAL","density: 1.363621e-06<br />TOTAL_VENTAS: 138248.36<br />CANTON: SAN CRISTOBAL","density: 1.401940e-06<br />TOTAL_VENTAS: 136301.20<br />CANTON: SAN CRISTOBAL","density: 1.441966e-06<br />TOTAL_VENTAS: 134354.04<br />CANTON: SAN CRISTOBAL","density: 1.482935e-06<br />TOTAL_VENTAS: 132406.88<br />CANTON: SAN CRISTOBAL","density: 1.524884e-06<br />TOTAL_VENTAS: 130459.72<br />CANTON: SAN CRISTOBAL","density: 1.568589e-06<br />TOTAL_VENTAS: 128512.56<br />CANTON: SAN CRISTOBAL","density: 1.613212e-06<br />TOTAL_VENTAS: 126565.40<br />CANTON: SAN CRISTOBAL","density: 1.658752e-06<br />TOTAL_VENTAS: 124618.24<br />CANTON: SAN CRISTOBAL","density: 1.705969e-06<br />TOTAL_VENTAS: 122671.08<br />CANTON: SAN CRISTOBAL","density: 1.754094e-06<br />TOTAL_VENTAS: 120723.92<br />CANTON: SAN CRISTOBAL","density: 1.803081e-06<br />TOTAL_VENTAS: 118776.76<br />CANTON: SAN CRISTOBAL","density: 1.853559e-06<br />TOTAL_VENTAS: 116829.60<br />CANTON: SAN CRISTOBAL","density: 1.904929e-06<br />TOTAL_VENTAS: 114882.44<br />CANTON: SAN CRISTOBAL","density: 1.957079e-06<br />TOTAL_VENTAS: 112935.28<br />CANTON: SAN CRISTOBAL","density: 2.010496e-06<br />TOTAL_VENTAS: 110988.12<br />CANTON: SAN CRISTOBAL","density: 2.064742e-06<br />TOTAL_VENTAS: 109040.96<br />CANTON: SAN CRISTOBAL","density: 2.119655e-06<br />TOTAL_VENTAS: 107093.80<br />CANTON: SAN CRISTOBAL","density: 2.175579e-06<br />TOTAL_VENTAS: 105146.64<br />CANTON: SAN CRISTOBAL","density: 2.232214e-06<br />TOTAL_VENTAS: 103199.48<br />CANTON: SAN CRISTOBAL","density: 2.289369e-06<br />TOTAL_VENTAS: 101252.32<br />CANTON: SAN CRISTOBAL","density: 2.347253e-06<br />TOTAL_VENTAS: 99305.16<br />CANTON: SAN CRISTOBAL","density: 2.405666e-06<br />TOTAL_VENTAS: 97358.00<br />CANTON: SAN CRISTOBAL","density: 2.464423e-06<br />TOTAL_VENTAS: 95410.84<br />CANTON: SAN CRISTOBAL","density: 2.523606e-06<br />TOTAL_VENTAS: 93463.68<br />CANTON: SAN CRISTOBAL","density: 2.583068e-06<br />TOTAL_VENTAS: 91516.52<br />CANTON: SAN CRISTOBAL","density: 2.642663e-06<br />TOTAL_VENTAS: 89569.36<br />CANTON: SAN CRISTOBAL","density: 2.702375e-06<br />TOTAL_VENTAS: 87622.20<br />CANTON: SAN CRISTOBAL","density: 2.762042e-06<br />TOTAL_VENTAS: 85675.04<br />CANTON: SAN CRISTOBAL","density: 2.821605e-06<br />TOTAL_VENTAS: 83727.88<br />CANTON: SAN CRISTOBAL","density: 2.880974e-06<br />TOTAL_VENTAS: 81780.72<br />CANTON: SAN CRISTOBAL","density: 2.939900e-06<br />TOTAL_VENTAS: 79833.56<br />CANTON: SAN CRISTOBAL","density: 2.998461e-06<br />TOTAL_VENTAS: 77886.40<br />CANTON: SAN CRISTOBAL","density: 3.056531e-06<br />TOTAL_VENTAS: 75939.24<br />CANTON: SAN CRISTOBAL","density: 3.113686e-06<br />TOTAL_VENTAS: 73992.08<br />CANTON: SAN CRISTOBAL","density: 3.170197e-06<br />TOTAL_VENTAS: 72044.92<br />CANTON: SAN CRISTOBAL","density: 3.225944e-06<br />TOTAL_VENTAS: 70097.76<br />CANTON: SAN CRISTOBAL","density: 3.280240e-06<br />TOTAL_VENTAS: 68150.60<br />CANTON: SAN CRISTOBAL","density: 3.333600e-06<br />TOTAL_VENTAS: 66203.44<br />CANTON: SAN CRISTOBAL","density: 3.385958e-06<br />TOTAL_VENTAS: 64256.28<br />CANTON: SAN CRISTOBAL","density: 3.436272e-06<br />TOTAL_VENTAS: 62309.12<br />CANTON: SAN CRISTOBAL","density: 3.485358e-06<br />TOTAL_VENTAS: 60361.96<br />CANTON: SAN CRISTOBAL","density: 3.533205e-06<br />TOTAL_VENTAS: 58414.80<br />CANTON: SAN CRISTOBAL","density: 3.578460e-06<br />TOTAL_VENTAS: 56467.64<br />CANTON: SAN CRISTOBAL","density: 3.622160e-06<br />TOTAL_VENTAS: 54520.48<br />CANTON: SAN CRISTOBAL","density: 3.664335e-06<br />TOTAL_VENTAS: 52573.32<br />CANTON: SAN CRISTOBAL","density: 3.703551e-06<br />TOTAL_VENTAS: 50626.16<br />CANTON: SAN CRISTOBAL","density: 3.740799e-06<br />TOTAL_VENTAS: 48679.00<br />CANTON: SAN CRISTOBAL","density: 3.776257e-06<br />TOTAL_VENTAS: 46731.84<br />CANTON: SAN CRISTOBAL","density: 3.808467e-06<br />TOTAL_VENTAS: 44784.68<br />CANTON: SAN CRISTOBAL","density: 3.838287e-06<br />TOTAL_VENTAS: 42837.52<br />CANTON: SAN CRISTOBAL","density: 3.866080e-06<br />TOTAL_VENTAS: 40890.36<br />CANTON: SAN CRISTOBAL","density: 3.890425e-06<br />TOTAL_VENTAS: 38943.20<br />CANTON: SAN CRISTOBAL","density: 3.911965e-06<br />TOTAL_VENTAS: 36996.04<br />CANTON: SAN CRISTOBAL","density: 3.931278e-06<br />TOTAL_VENTAS: 35048.88<br />CANTON: SAN CRISTOBAL","density: 3.947041e-06<br />TOTAL_VENTAS: 33101.72<br />CANTON: SAN CRISTOBAL","density: 3.959608e-06<br />TOTAL_VENTAS: 31154.56<br />CANTON: SAN CRISTOBAL","density: 3.969797e-06<br />TOTAL_VENTAS: 29207.40<br />CANTON: SAN CRISTOBAL","density: 3.976431e-06<br />TOTAL_VENTAS: 27260.24<br />CANTON: SAN CRISTOBAL","density: 3.979524e-06<br />TOTAL_VENTAS: 25313.08<br />CANTON: SAN CRISTOBAL","density: 3.980144e-06<br />TOTAL_VENTAS: 23365.92<br />CANTON: SAN CRISTOBAL","density: 3.977297e-06<br />TOTAL_VENTAS: 21418.76<br />CANTON: SAN CRISTOBAL","density: 3.970631e-06<br />TOTAL_VENTAS: 19471.60<br />CANTON: SAN CRISTOBAL","density: 3.961458e-06<br />TOTAL_VENTAS: 17524.44<br />CANTON: SAN CRISTOBAL","density: 3.948994e-06<br />TOTAL_VENTAS: 15577.28<br />CANTON: SAN CRISTOBAL","density: 3.932517e-06<br />TOTAL_VENTAS: 13630.12<br />CANTON: SAN CRISTOBAL","density: 3.913561e-06<br />TOTAL_VENTAS: 11682.96<br />CANTON: SAN CRISTOBAL","density: 3.891567e-06<br />TOTAL_VENTAS: 9735.80<br />CANTON: SAN CRISTOBAL","density: 3.865469e-06<br />TOTAL_VENTAS: 7788.64<br />CANTON: SAN CRISTOBAL","density: 3.836982e-06<br />TOTAL_VENTAS: 5841.48<br />CANTON: SAN CRISTOBAL","density: 3.805771e-06<br />TOTAL_VENTAS: 3894.32<br />CANTON: SAN CRISTOBAL","density: 3.770476e-06<br />TOTAL_VENTAS: 1947.16<br />CANTON: SAN CRISTOBAL","density: 3.732947e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: SAN CRISTOBAL","density: 3.732947e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: SAN CRISTOBAL"],"type":"scatter","mode":"lines","line":{"width":null,"color":"rgba(0,0,0,0.4)","dash":"solid"},"fill":"toself","fillcolor":"rgba(0,186,56,0.4)","hoveron":"points","name":"SAN CRISTOBAL","legendgroup":"SAN CRISTOBAL","showlegend":true,"xaxis":"x","yaxis":"y","hoverinfo":"text","frame":null},{"x":[0,1947.16,3894.32,5841.48,7788.64,9735.8,11682.96,13630.12,15577.28,17524.44,19471.6,21418.76,23365.92,25313.08,27260.24,29207.4,31154.56,33101.72,35048.88,36996.04,38943.2,40890.36,42837.52,44784.68,46731.84,48679,50626.16,52573.32,54520.48,56467.64,58414.8,60361.96,62309.12,64256.28,66203.44,68150.6,70097.76,72044.92,73992.08,75939.24,77886.4,79833.56,81780.72,83727.88,85675.04,87622.2,89569.36,91516.52,93463.68,95410.84,97358,99305.16,101252.32,103199.48,105146.64,107093.8,109040.96,110988.12,112935.28,114882.44,116829.6,118776.76,120723.92,122671.08,124618.24,126565.4,128512.56,130459.72,132406.88,134354.04,136301.2,138248.36,140195.52,142142.68,144089.84,146037,147984.16,149931.32,151878.48,153825.64,155772.8,157719.96,159667.12,161614.28,163561.44,165508.6,167455.76,169402.92,171350.08,173297.24,175244.4,177191.56,179138.72,181085.88,183033.04,184980.2,186927.36,188874.52,190821.68,192768.84,194716,196663.16,198610.32,200557.48,202504.64,204451.8,206398.96,208346.12,210293.28,212240.44,214187.6,216134.76,218081.92,220029.08,221976.24,223923.4,225870.56,227817.72,229764.88,231712.04,233659.2,235606.36,237553.52,239500.68,241447.84,243395,245342.16,247289.32,249236.48,251183.64,253130.8,255077.96,257025.12,258972.28,260919.44,262866.6,264813.76,266760.92,268708.08,270655.24,272602.4,274549.56,276496.72,278443.88,280391.04,282338.2,284285.36,286232.52,288179.68,290126.84,292074,294021.16,295968.32,297915.48,299862.64,301809.8,303756.96,305704.12,307651.28,309598.44,311545.6,313492.76,315439.92,317387.08,319334.24,321281.4,323228.56,325175.72,327122.88,329070.04,331017.2,332964.36,334911.52,336858.68,338805.84,340753,342700.16,344647.32,346594.48,348541.64,350488.8,352435.96,354383.12,356330.28,358277.44,360224.6,362171.76,364118.92,366066.08,368013.24,369960.4,371907.56,373854.72,375801.88,377749.04,379696.2,381643.36,383590.52,385537.68,387484.84,389432,391379.16,393326.32,395273.48,397220.64,399167.8,401114.96,403062.12,405009.28,406956.44,408903.6,410850.76,412797.92,414745.08,416692.24,418639.4,420586.56,422533.72,424480.88,426428.04,428375.2,430322.36,432269.52,434216.68,436163.84,438111,440058.16,442005.32,443952.48,445899.64,447846.8,449793.96,451741.12,453688.28,455635.44,457582.6,459529.76,461476.92,463424.08,465371.24,467318.4,469265.56,471212.72,473159.88,475107.04,477054.2,479001.36,480948.52,482895.68,484842.84,486790,488737.16,490684.32,492631.48,494578.64,496525.8,498472.96,500420.12,502367.28,504314.44,506261.6,508208.76,510155.92,512103.08,514050.24,515997.4,517944.56,519891.72,521838.88,523786.04,525733.2,527680.36,529627.52,531574.68,533521.84,535469,537416.16,539363.32,541310.48,543257.64,545204.8,547151.96,549099.12,551046.28,552993.44,554940.6,556887.76,558834.92,560782.08,562729.24,564676.4,566623.56,568570.72,570517.88,572465.04,574412.2,576359.36,578306.52,580253.68,582200.84,584148,586095.16,588042.32,589989.48,591936.64,593883.8,595830.96,597778.12,599725.28,601672.44,603619.6,605566.76,607513.92,609461.08,611408.24,613355.4,615302.56,617249.72,619196.88,621144.04,623091.2,625038.36,626985.52,628932.68,630879.84,632827,634774.16,636721.32,638668.48,640615.64,642562.8,644509.96,646457.12,648404.28,650351.44,652298.6,654245.76,656192.92,658140.08,660087.24,662034.4,663981.56,665928.72,667875.88,669823.04,671770.2,673717.36,675664.52,677611.68,679558.84,681506,683453.16,685400.32,687347.48,689294.64,691241.8,693188.96,695136.12,697083.28,699030.44,700977.6,702924.76,704871.92,706819.08,708766.24,710713.4,712660.56,714607.72,716554.88,718502.04,720449.2,722396.36,724343.52,726290.68,728237.84,730185,732132.16,734079.32,736026.48,737973.64,739920.8,741867.96,743815.12,745762.28,747709.44,749656.6,751603.76,753550.92,755498.08,757445.24,759392.4,761339.56,763286.72,765233.88,767181.04,769128.2,771075.36,773022.52,774969.68,776916.84,778864,780811.16,782758.32,784705.48,786652.64,788599.8,790546.96,792494.12,794441.28,796388.44,798335.6,800282.76,802229.92,804177.08,806124.24,808071.4,810018.56,811965.72,813912.88,815860.04,817807.2,819754.36,821701.52,823648.68,825595.84,827543,829490.16,831437.32,833384.48,835331.64,837278.8,839225.96,841173.12,843120.28,845067.44,847014.6,848961.76,850908.92,852856.08,854803.24,856750.4,858697.56,860644.72,862591.88,864539.04,866486.2,868433.36,870380.52,872327.68,874274.84,876222,878169.16,880116.32,882063.48,884010.64,885957.8,887904.96,889852.12,891799.28,893746.44,895693.6,897640.76,899587.92,901535.08,903482.24,905429.4,907376.56,909323.72,911270.88,913218.04,915165.2,917112.36,919059.52,921006.68,922953.84,924901,926848.16,928795.32,930742.48,932689.64,934636.8,936583.96,938531.12,940478.28,942425.44,944372.6,946319.76,948266.92,950214.08,952161.24,954108.4,956055.56,958002.72,959949.88,961897.04,963844.2,965791.36,967738.52,969685.68,971632.84,973580,975527.16,977474.32,979421.48,981368.64,983315.8,985262.96,987210.12,989157.28,991104.44,993051.6,994998.76,994998.76,994998.76,993051.6,991104.44,989157.28,987210.12,985262.96,983315.8,981368.64,979421.48,977474.32,975527.16,973580,971632.84,969685.68,967738.52,965791.36,963844.2,961897.04,959949.88,958002.72,956055.56,954108.4,952161.24,950214.08,948266.92,946319.76,944372.6,942425.44,940478.28,938531.12,936583.96,934636.8,932689.64,930742.48,928795.32,926848.16,924901,922953.84,921006.68,919059.52,917112.36,915165.2,913218.04,911270.88,909323.72,907376.56,905429.4,903482.24,901535.08,899587.92,897640.76,895693.6,893746.44,891799.28,889852.12,887904.96,885957.8,884010.64,882063.48,880116.32,878169.16,876222,874274.84,872327.68,870380.52,868433.36,866486.2,864539.04,862591.88,860644.72,858697.56,856750.4,854803.24,852856.08,850908.92,848961.76,847014.6,845067.44,843120.28,841173.12,839225.96,837278.8,835331.64,833384.48,831437.32,829490.16,827543,825595.84,823648.68,821701.52,819754.36,817807.2,815860.04,813912.88,811965.72,810018.56,808071.4,806124.24,804177.08,802229.92,800282.76,798335.6,796388.44,794441.28,792494.12,790546.96,788599.8,786652.64,784705.48,782758.32,780811.16,778864,776916.84,774969.68,773022.52,771075.36,769128.2,767181.04,765233.88,763286.72,761339.56,759392.4,757445.24,755498.08,753550.92,751603.76,749656.6,747709.44,745762.28,743815.12,741867.96,739920.8,737973.64,736026.48,734079.32,732132.16,730185,728237.84,726290.68,724343.52,722396.36,720449.2,718502.04,716554.88,714607.72,712660.56,710713.4,708766.24,706819.08,704871.92,702924.76,700977.6,699030.44,697083.28,695136.12,693188.96,691241.8,689294.64,687347.48,685400.32,683453.16,681506,679558.84,677611.68,675664.52,673717.36,671770.2,669823.04,667875.88,665928.72,663981.56,662034.4,660087.24,658140.08,656192.92,654245.76,652298.6,650351.44,648404.28,646457.12,644509.96,642562.8,640615.64,638668.48,636721.32,634774.16,632827,630879.84,628932.68,626985.52,625038.36,623091.2,621144.04,619196.88,617249.72,615302.56,613355.4,611408.24,609461.08,607513.92,605566.76,603619.6,601672.44,599725.28,597778.12,595830.96,593883.8,591936.64,589989.48,588042.32,586095.16,584148,582200.84,580253.68,578306.52,576359.36,574412.2,572465.04,570517.88,568570.72,566623.56,564676.4,562729.24,560782.08,558834.92,556887.76,554940.6,552993.44,551046.28,549099.12,547151.96,545204.8,543257.64,541310.48,539363.32,537416.16,535469,533521.84,531574.68,529627.52,527680.36,525733.2,523786.04,521838.88,519891.72,517944.56,515997.4,514050.24,512103.08,510155.92,508208.76,506261.6,504314.44,502367.28,500420.12,498472.96,496525.8,494578.64,492631.48,490684.32,488737.16,486790,484842.84,482895.68,480948.52,479001.36,477054.2,475107.04,473159.88,471212.72,469265.56,467318.4,465371.24,463424.08,461476.92,459529.76,457582.6,455635.44,453688.28,451741.12,449793.96,447846.8,445899.64,443952.48,442005.32,440058.16,438111,436163.84,434216.68,432269.52,430322.36,428375.2,426428.04,424480.88,422533.72,420586.56,418639.4,416692.24,414745.08,412797.92,410850.76,408903.6,406956.44,405009.28,403062.12,401114.96,399167.8,397220.64,395273.48,393326.32,391379.16,389432,387484.84,385537.68,383590.52,381643.36,379696.2,377749.04,375801.88,373854.72,371907.56,369960.4,368013.24,366066.08,364118.92,362171.76,360224.6,358277.44,356330.28,354383.12,352435.96,350488.8,348541.64,346594.48,344647.32,342700.16,340753,338805.84,336858.68,334911.52,332964.36,331017.2,329070.04,327122.88,325175.72,323228.56,321281.4,319334.24,317387.08,315439.92,313492.76,311545.6,309598.44,307651.28,305704.12,303756.96,301809.8,299862.64,297915.48,295968.32,294021.16,292074,290126.84,288179.68,286232.52,284285.36,282338.2,280391.04,278443.88,276496.72,274549.56,272602.4,270655.24,268708.08,266760.92,264813.76,262866.6,260919.44,258972.28,257025.12,255077.96,253130.8,251183.64,249236.48,247289.32,245342.16,243395,241447.84,239500.68,237553.52,235606.36,233659.2,231712.04,229764.88,227817.72,225870.56,223923.4,221976.24,220029.08,218081.92,216134.76,214187.6,212240.44,210293.28,208346.12,206398.96,204451.8,202504.64,200557.48,198610.32,196663.16,194716,192768.84,190821.68,188874.52,186927.36,184980.2,183033.04,181085.88,179138.72,177191.56,175244.4,173297.24,171350.08,169402.92,167455.76,165508.6,163561.44,161614.28,159667.12,157719.96,155772.8,153825.64,151878.48,149931.32,147984.16,146037,144089.84,142142.68,140195.52,138248.36,136301.2,134354.04,132406.88,130459.72,128512.56,126565.4,124618.24,122671.08,120723.92,118776.76,116829.6,114882.44,112935.28,110988.12,109040.96,107093.8,105146.64,103199.48,101252.32,99305.16,97358,95410.84,93463.68,91516.52,89569.36,87622.2,85675.04,83727.88,81780.72,79833.56,77886.4,75939.24,73992.08,72044.92,70097.76,68150.6,66203.44,64256.28,62309.12,60361.96,58414.8,56467.64,54520.48,52573.32,50626.16,48679,46731.84,44784.68,42837.52,40890.36,38943.2,36996.04,35048.88,33101.72,31154.56,29207.4,27260.24,25313.08,23365.92,21418.76,19471.6,17524.44,15577.28,13630.12,11682.96,9735.8,7788.64,5841.48,3894.32,1947.16,0,0],"y":[0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,0,2.07873664709206e-07,2.1512101912612e-07,2.22216746444542e-07,2.29140599657991e-07,2.35872360875327e-07,2.4228510883684e-07,2.48433028709404e-07,2.54301751333428e-07,2.59873046623146e-07,2.65035276859511e-07,2.69789241161077e-07,2.74172962953134e-07,2.78172649347329e-07,2.81723480077661e-07,2.84726955451269e-07,2.87297280304159e-07,2.89427122441059e-07,2.91109705347664e-07,2.9215195224133e-07,2.9272573797774e-07,2.92841006536316e-07,2.92498764816892e-07,2.91583555778828e-07,2.90150878659865e-07,2.88283752329519e-07,2.85991102137037e-07,2.83235471458941e-07,2.79967008274531e-07,2.76328668657225e-07,2.72336357381562e-07,2.68006460709372e-07,2.63245783000513e-07,2.58206213350927e-07,2.52916026681078e-07,2.47396469068492e-07,2.41628110730512e-07,2.35675932098965e-07,2.29596453963883e-07,2.23413144937408e-07,2.17145584895146e-07,2.10833152135991e-07,2.04522379685307e-07,1.98236047658888e-07,1.91996777406746e-07,1.85875524396178e-07,1.79877883078423e-07,1.74020938764738e-07,1.68323608607054e-07,1.62859628125034e-07,1.57645609421847e-07,1.52663599225944e-07,1.4792664719438e-07,1.43479001361222e-07,1.39395321335715e-07,1.35600646954174e-07,1.32100881042799e-07,1.28901352504369e-07,1.26129320988996e-07,1.23673396887459e-07,1.21523187987729e-07,1.19676707858023e-07,1.18205184426033e-07,1.1707273160055e-07,1.16219764496519e-07,1.15637960343817e-07,1.15345519365806e-07,1.15371336070277e-07,1.15620347712651e-07,1.16079726523217e-07,1.16736379213156e-07,1.17635546995294e-07,1.1868765547949e-07,1.19872115462493e-07,1.21173856124482e-07,1.22595026183484e-07,1.24097034314665e-07,1.25648203506517e-07,1.27233759210306e-07,1.28838172118106e-07,1.30432625819095e-07,1.31998749466797e-07,1.33523878888001e-07,1.34995564294744e-07,1.36365549444221e-07,1.37640891777093e-07,1.3881469020303e-07,1.39877787257416e-07,1.40787447786764e-07,1.41537440354192e-07,1.42143858609933e-07,1.42601171069748e-07,1.42886930561918e-07,1.4295849916841e-07,1.42863503086795e-07,1.4259985812707e-07,1.42165731700506e-07,1.41492348836236e-07,1.4064047004589e-07,1.39617477256433e-07,1.38424509212095e-07,1.37022623191969e-07,1.35428020304823e-07,1.33674526772817e-07,1.31765789806339e-07,1.29690907035296e-07,1.27427260244113e-07,1.25029371407387e-07,1.22502989781308e-07,1.1985401235066e-07,1.17049832189959e-07,1.14141959083889e-07,1.11142348872409e-07,1.08058564679651e-07,1.04883999346247e-07,1.01640132437814e-07,9.83490634526706e-08,9.50195262610564e-08,9.16591048007769e-08,8.82824652222434e-08,8.49080776324315e-08,8.15451978582783e-08,7.82030932205683e-08,7.49112363077991e-08,7.16739529267501e-08,6.84986889632731e-08,6.53943841857785e-08,6.23936853546677e-08,5.95095831706852e-08,5.67344667003496e-08,5.40761640191466e-08,5.15559354697139e-08,4.9219586094091e-08,4.70318198808895e-08,4.49986931568213e-08,4.31261049784523e-08,4.14876745977523e-08,4.00347970122718e-08,3.87635639493723e-08,3.76776263237645e-08,3.68267833721489e-08,3.62066702243278e-08,3.57827585362664e-08,3.55562680240927e-08,3.55471427341678e-08,3.58029535726507e-08,3.62565940874828e-08,3.69068800338254e-08,3.77524472173432e-08,3.88628345431892e-08,4.01695359640791e-08,4.16598490830347e-08,4.33302210293341e-08,4.52162274795415e-08,4.73006909834172e-08,4.95447846540004e-08,5.19430757301922e-08,5.4502645006981e-08,5.72450667330152e-08,6.01139005272559e-08,6.31021880973492e-08,6.62028672489712e-08,6.94413528476212e-08,7.2770738443555e-08,7.61777521205141e-08,7.96541734335435e-08,8.32015697556459e-08,8.67995384655892e-08,9.04278138416435e-08,9.40772927665991e-08,9.7738280416188e-08,1.01391374683619e-07,1.05023291482402e-07,1.08624299265225e-07,1.12184630012601e-07,1.15666598977907e-07,1.19070104066204e-07,1.22388224211843e-07,1.25610973802368e-07,1.28699152522541e-07,1.3163570169919e-07,1.34432616715107e-07,1.37080389165064e-07,1.39554292779918e-07,1.41792546961908e-07,1.43841579177616e-07,1.45693474614212e-07,1.47340497709102e-07,1.48690674702865e-07,1.49800917399931e-07,1.50678635490654e-07,1.51319288202047e-07,1.51662450166486e-07,1.51709810745099e-07,1.51509563040243e-07,1.51061790818736e-07,1.50346550371067e-07,1.49305354134717e-07,1.48028202158712e-07,1.46520674265169e-07,1.44788783258058e-07,1.42766792556977e-07,1.40537299092342e-07,1.38123831413778e-07,1.35537660885168e-07,1.32760733765646e-07,1.29824784648064e-07,1.26776338804352e-07,1.23630426564102e-07,1.20398087697516e-07,1.17095683259052e-07,1.13767393175675e-07,1.10429530144848e-07,1.07098388143328e-07,1.03812463266427e-07,1.00590635585222e-07,9.74455636397229e-08,9.43916811773664e-08,9.14726532093484e-08,8.87130863477117e-08,8.61008362575046e-08,8.36460063532395e-08,8.13726146015039e-08,7.93444848120975e-08,7.75076372178981e-08,7.58663777946206e-08,7.44245414482641e-08,7.32593978102744e-08,7.23110023254583e-08,7.15645071949563e-08,7.10178379941239e-08,7.07095708683402e-08,7.06276480623182e-08,7.07247085119979e-08,7.0993928504299e-08,7.14394985721176e-08,7.20870680521772e-08,7.28692920011088e-08,7.37765380204878e-08,7.47990483673901e-08,7.5955972056683e-08,7.71991890547615e-08,7.85117506880866e-08,7.98834700840622e-08,8.13102935845722e-08,8.27714552255223e-08,8.42484194420458e-08,8.57324360290488e-08,8.72137310178811e-08,8.86732769148073e-08,9.01056472329297e-08,9.15047960649115e-08,9.2864919719264e-08,9.41611675976314e-08,9.53997445436719e-08,9.65812390434789e-08,9.77031920071545e-08,9.87498572070767e-08,9.9719656465738e-08,1.00626552175887e-07,1.01471478182212e-07,1.02251649972874e-07,1.0295516002109e-07,1.03607503525746e-07,1.04212739560975e-07,1.0477515073222e-07,1.05290600870147e-07,1.05779843147659e-07,1.06252122143694e-07,1.06714310942834e-07,1.07176391873013e-07,1.07655218134641e-07,1.08159467080776e-07,1.08697873124323e-07,1.0928337413334e-07,1.09950866165569e-07,1.10694062160863e-07,1.11522526440013e-07,1.12445833528627e-07,1.13518275182958e-07,1.14727071882776e-07,1.16072920465492e-07,1.1756476685149e-07,1.19247385160963e-07,1.21139822196638e-07,1.23214579063703e-07,1.25478570481542e-07,1.27951939758712e-07,1.30706954991887e-07,1.33676308555367e-07,1.36863808008417e-07,1.40272995126299e-07,1.43987038946443e-07,1.47947675092511e-07,1.52137480059286e-07,1.56556565271199e-07,1.61251318024091e-07,1.66222514859593e-07,1.71416827490641e-07,1.76831640725648e-07,1.82477311708548e-07,1.88411836797004e-07,1.94551762561246e-07,2.00893246185333e-07,2.07432429065717e-07,2.14229540486596e-07,2.21226845945549e-07,2.28405486333335e-07,2.35762342924859e-07,2.43329013416124e-07,2.51104600286294e-07,2.59048627471078e-07,2.67160087251561e-07,2.75448075045319e-07,2.83964254586715e-07,2.92648530366753e-07,3.01502395520781e-07,3.10527514590347e-07,3.19787569543819e-07,3.29242346894921e-07,3.38880309535709e-07,3.48704660168765e-07,3.58758130690983e-07,3.69053109926358e-07,3.79549148644897e-07,3.90249087964623e-07,4.01167617375564e-07,4.12374737119815e-07,4.23794213329053e-07,4.35426249359849e-07,4.47270750181e-07,4.59397724133319e-07,4.71748681928584e-07,4.84300920915366e-07,4.97049609395908e-07,5.10024173254454e-07,5.23214524614744e-07,5.36567093140278e-07,5.50071342243959e-07,5.63722589733886e-07,5.77534445818302e-07,5.91438971918165e-07,6.05420071609458e-07,6.1946125932677e-07,6.33545039751822e-07,6.47627046600583e-07,6.61683892712538e-07,6.75694808340926e-07,6.89616577175453e-07,7.03398334760772e-07,7.17034289344435e-07,7.30501204244775e-07,7.43763621578123e-07,7.56701186128821e-07,7.69363465239918e-07,7.81726875113089e-07,7.93767906133585e-07,8.05329137953966e-07,8.16454799723807e-07,8.27156446883502e-07,8.37412742153767e-07,8.47105135850797e-07,8.56170881477022e-07,8.6470442812394e-07,8.72689122689753e-07,8.80080111963651e-07,8.86656132218318e-07,8.92622128208504e-07,8.97968871043533e-07,9.02687833561339e-07,9.06557042298106e-07,9.09722412756589e-07,9.12245593501881e-07,9.14128515304071e-07,9.15256331423886e-07,9.15614702111578e-07,9.15368779828395e-07,9.14533192255376e-07,9.1309903872292e-07,9.10922420597486e-07,9.08249513721285e-07,9.05108611190567e-07,9.01529042349969e-07,8.9743459891269e-07,8.92985562453273e-07,8.88260775240431e-07,8.83301971411354e-07,8.78134215955065e-07,8.7284911172866e-07,8.67539418391892e-07,8.62255644813371e-07,8.57056276734843e-07,8.52096410561385e-07,8.47398829564477e-07,8.43017092622317e-07,8.39004680950155e-07,8.35593337779721e-07,8.32780173810868e-07,8.30569258905608e-07,8.29009479505683e-07,8.28294759525519e-07,8.2856445830661e-07,8.29682974884263e-07,8.31687758130505e-07,8.34654599212593e-07,8.38980756010392e-07,8.44329728193213e-07,8.50722144288709e-07,8.58177163307818e-07,8.67069599827418e-07,8.77175062129311e-07,8.88382184779313e-07,9.0069023064317e-07,9.14291946829549e-07,9.29236714117313e-07,9.45234837864423e-07,9.62265849807639e-07,9.80343807946161e-07,9.99757473220952e-07,1.02007610679875e-06,1.04126233121386e-06,1.06327767419541e-06,1.08630250748546e-06,1.11008376539096e-06,1.13449110121852e-06,1.15947472472358e-06,1.1850583113527e-06,1.21116244094806e-06,1.23760541357193e-06,1.26433296093575e-06,1.29129529479616e-06,1.31844247743572e-06,1.34563355382824e-06,1.37281798986038e-06,1.3999459729279e-06,1.42690221618172e-06,1.45363019802815e-06,1.48010680727337e-06,1.50629646612683e-06,1.53209928287692e-06,1.55743490495818e-06,1.58237302165523e-06,1.60690299726239e-06,1.63100325830667e-06,1.65452805509951e-06,1.67766379694252e-06,1.70043564752566e-06,1.72287200268015e-06,1.74494624193566e-06,1.76681720680786e-06,1.78858555453752e-06,1.81032503966963e-06,1.8321558726416e-06,1.85429737267501e-06,1.87684825418436e-06,1.89993060235525e-06,1.92369680756774e-06,1.94873580278387e-06,1.97494448856643e-06,2.00248660116647e-06,2.0315283146451e-06,2.06289345486109e-06,2.09658129604461e-06,2.13257505060167e-06,2.17105980643754e-06,2.21274113942952e-06,2.25826126346778e-06,2.30708810688951e-06,2.35938969197041e-06,2.41543497723544e-06,2.4769569308082e-06,2.54260404026958e-06,2.6124797970802e-06,2.68668022193818e-06,2.76669547868952e-06,2.85173628216789e-06,2.94127107394058e-06,3.0352759159493e-06,3.13442672001675e-06,3.23892420465683e-06,3.34744944500844e-06,3.45981889028114e-06,3.57591169409418e-06,3.69649155003676e-06,3.81974294674436e-06,3.9453088335303e-06,4.07281943075848e-06,4.2020496569672e-06,4.33185857746595e-06,4.4615821128283e-06,4.59070617045508e-06,4.7183322610363e-06,4.84309312695304e-06,4.96473798335922e-06,5.08267889480619e-06,5.19621262971678e-06,5.30221844010096e-06,5.40188145594798e-06,5.49464250031309e-06,5.57995019423554e-06,5.65447408486054e-06,5.7187779133464e-06,5.7734571293962e-06,5.81811195853394e-06,5.85057336058667e-06,5.86909179924351e-06,5.87628004993225e-06,5.87197973875005e-06,5.85583931507575e-06,5.82318498743885e-06,5.77888578966961e-06,5.72306619018604e-06,5.65587223621367e-06,0],"text":["density: 5.655872e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: SANTA CRUZ","density: 5.723066e-06<br />TOTAL_VENTAS: 1947.16<br />CANTON: SANTA CRUZ","density: 5.778886e-06<br />TOTAL_VENTAS: 3894.32<br />CANTON: SANTA CRUZ","density: 5.823185e-06<br />TOTAL_VENTAS: 5841.48<br />CANTON: SANTA CRUZ","density: 5.855839e-06<br />TOTAL_VENTAS: 7788.64<br />CANTON: SANTA CRUZ","density: 5.871980e-06<br />TOTAL_VENTAS: 9735.80<br />CANTON: SANTA CRUZ","density: 5.876280e-06<br />TOTAL_VENTAS: 11682.96<br />CANTON: SANTA CRUZ","density: 5.869092e-06<br />TOTAL_VENTAS: 13630.12<br />CANTON: SANTA CRUZ","density: 5.850573e-06<br />TOTAL_VENTAS: 15577.28<br />CANTON: SANTA CRUZ","density: 5.818112e-06<br />TOTAL_VENTAS: 17524.44<br />CANTON: SANTA CRUZ","density: 5.773457e-06<br />TOTAL_VENTAS: 19471.60<br />CANTON: SANTA CRUZ","density: 5.718778e-06<br />TOTAL_VENTAS: 21418.76<br />CANTON: SANTA CRUZ","density: 5.654474e-06<br />TOTAL_VENTAS: 23365.92<br />CANTON: SANTA CRUZ","density: 5.579950e-06<br />TOTAL_VENTAS: 25313.08<br />CANTON: SANTA CRUZ","density: 5.494643e-06<br />TOTAL_VENTAS: 27260.24<br />CANTON: SANTA CRUZ","density: 5.401881e-06<br />TOTAL_VENTAS: 29207.40<br />CANTON: SANTA CRUZ","density: 5.302218e-06<br />TOTAL_VENTAS: 31154.56<br />CANTON: SANTA CRUZ","density: 5.196213e-06<br />TOTAL_VENTAS: 33101.72<br />CANTON: SANTA CRUZ","density: 5.082679e-06<br />TOTAL_VENTAS: 35048.88<br />CANTON: SANTA CRUZ","density: 4.964738e-06<br />TOTAL_VENTAS: 36996.04<br />CANTON: SANTA CRUZ","density: 4.843093e-06<br />TOTAL_VENTAS: 38943.20<br />CANTON: SANTA CRUZ","density: 4.718332e-06<br />TOTAL_VENTAS: 40890.36<br />CANTON: SANTA CRUZ","density: 4.590706e-06<br />TOTAL_VENTAS: 42837.52<br />CANTON: SANTA CRUZ","density: 4.461582e-06<br />TOTAL_VENTAS: 44784.68<br />CANTON: SANTA CRUZ","density: 4.331859e-06<br />TOTAL_VENTAS: 46731.84<br />CANTON: SANTA CRUZ","density: 4.202050e-06<br />TOTAL_VENTAS: 48679.00<br />CANTON: SANTA CRUZ","density: 4.072819e-06<br />TOTAL_VENTAS: 50626.16<br />CANTON: SANTA CRUZ","density: 3.945309e-06<br />TOTAL_VENTAS: 52573.32<br />CANTON: SANTA CRUZ","density: 3.819743e-06<br />TOTAL_VENTAS: 54520.48<br />CANTON: SANTA CRUZ","density: 3.696492e-06<br />TOTAL_VENTAS: 56467.64<br />CANTON: SANTA CRUZ","density: 3.575912e-06<br />TOTAL_VENTAS: 58414.80<br />CANTON: SANTA CRUZ","density: 3.459819e-06<br />TOTAL_VENTAS: 60361.96<br />CANTON: SANTA CRUZ","density: 3.347449e-06<br />TOTAL_VENTAS: 62309.12<br />CANTON: SANTA CRUZ","density: 3.238924e-06<br />TOTAL_VENTAS: 64256.28<br />CANTON: SANTA CRUZ","density: 3.134427e-06<br />TOTAL_VENTAS: 66203.44<br />CANTON: SANTA CRUZ","density: 3.035276e-06<br />TOTAL_VENTAS: 68150.60<br />CANTON: SANTA CRUZ","density: 2.941271e-06<br />TOTAL_VENTAS: 70097.76<br />CANTON: SANTA CRUZ","density: 2.851736e-06<br />TOTAL_VENTAS: 72044.92<br />CANTON: SANTA CRUZ","density: 2.766695e-06<br />TOTAL_VENTAS: 73992.08<br />CANTON: SANTA CRUZ","density: 2.686680e-06<br />TOTAL_VENTAS: 75939.24<br />CANTON: SANTA CRUZ","density: 2.612480e-06<br />TOTAL_VENTAS: 77886.40<br />CANTON: SANTA CRUZ","density: 2.542604e-06<br />TOTAL_VENTAS: 79833.56<br />CANTON: SANTA CRUZ","density: 2.476957e-06<br />TOTAL_VENTAS: 81780.72<br />CANTON: SANTA CRUZ","density: 2.415435e-06<br />TOTAL_VENTAS: 83727.88<br />CANTON: SANTA CRUZ","density: 2.359390e-06<br />TOTAL_VENTAS: 85675.04<br />CANTON: SANTA CRUZ","density: 2.307088e-06<br />TOTAL_VENTAS: 87622.20<br />CANTON: SANTA CRUZ","density: 2.258261e-06<br />TOTAL_VENTAS: 89569.36<br />CANTON: SANTA CRUZ","density: 2.212741e-06<br />TOTAL_VENTAS: 91516.52<br />CANTON: SANTA CRUZ","density: 2.171060e-06<br />TOTAL_VENTAS: 93463.68<br />CANTON: SANTA CRUZ","density: 2.132575e-06<br />TOTAL_VENTAS: 95410.84<br />CANTON: SANTA CRUZ","density: 2.096581e-06<br />TOTAL_VENTAS: 97358.00<br />CANTON: SANTA CRUZ","density: 2.062893e-06<br />TOTAL_VENTAS: 99305.16<br />CANTON: SANTA CRUZ","density: 2.031528e-06<br />TOTAL_VENTAS: 101252.32<br />CANTON: SANTA CRUZ","density: 2.002487e-06<br />TOTAL_VENTAS: 103199.48<br />CANTON: SANTA CRUZ","density: 1.974944e-06<br />TOTAL_VENTAS: 105146.64<br />CANTON: SANTA CRUZ","density: 1.948736e-06<br />TOTAL_VENTAS: 107093.80<br />CANTON: SANTA CRUZ","density: 1.923697e-06<br />TOTAL_VENTAS: 109040.96<br />CANTON: SANTA CRUZ","density: 1.899931e-06<br />TOTAL_VENTAS: 110988.12<br />CANTON: SANTA CRUZ","density: 1.876848e-06<br />TOTAL_VENTAS: 112935.28<br />CANTON: SANTA CRUZ","density: 1.854297e-06<br />TOTAL_VENTAS: 114882.44<br />CANTON: SANTA CRUZ","density: 1.832156e-06<br />TOTAL_VENTAS: 116829.60<br />CANTON: SANTA CRUZ","density: 1.810325e-06<br />TOTAL_VENTAS: 118776.76<br />CANTON: SANTA CRUZ","density: 1.788586e-06<br />TOTAL_VENTAS: 120723.92<br />CANTON: SANTA CRUZ","density: 1.766817e-06<br />TOTAL_VENTAS: 122671.08<br />CANTON: SANTA CRUZ","density: 1.744946e-06<br />TOTAL_VENTAS: 124618.24<br />CANTON: SANTA CRUZ","density: 1.722872e-06<br />TOTAL_VENTAS: 126565.40<br />CANTON: SANTA CRUZ","density: 1.700436e-06<br />TOTAL_VENTAS: 128512.56<br />CANTON: SANTA CRUZ","density: 1.677664e-06<br />TOTAL_VENTAS: 130459.72<br />CANTON: SANTA CRUZ","density: 1.654528e-06<br />TOTAL_VENTAS: 132406.88<br />CANTON: SANTA CRUZ","density: 1.631003e-06<br />TOTAL_VENTAS: 134354.04<br />CANTON: SANTA CRUZ","density: 1.606903e-06<br />TOTAL_VENTAS: 136301.20<br />CANTON: SANTA CRUZ","density: 1.582373e-06<br />TOTAL_VENTAS: 138248.36<br />CANTON: SANTA CRUZ","density: 1.557435e-06<br />TOTAL_VENTAS: 140195.52<br />CANTON: SANTA CRUZ","density: 1.532099e-06<br />TOTAL_VENTAS: 142142.68<br />CANTON: SANTA CRUZ","density: 1.506296e-06<br />TOTAL_VENTAS: 144089.84<br />CANTON: SANTA CRUZ","density: 1.480107e-06<br />TOTAL_VENTAS: 146037.00<br />CANTON: SANTA CRUZ","density: 1.453630e-06<br />TOTAL_VENTAS: 147984.16<br />CANTON: SANTA CRUZ","density: 1.426902e-06<br />TOTAL_VENTAS: 149931.32<br />CANTON: SANTA CRUZ","density: 1.399946e-06<br />TOTAL_VENTAS: 151878.48<br />CANTON: SANTA CRUZ","density: 1.372818e-06<br />TOTAL_VENTAS: 153825.64<br />CANTON: SANTA CRUZ","density: 1.345634e-06<br />TOTAL_VENTAS: 155772.80<br />CANTON: SANTA CRUZ","density: 1.318442e-06<br />TOTAL_VENTAS: 157719.96<br />CANTON: SANTA CRUZ","density: 1.291295e-06<br />TOTAL_VENTAS: 159667.12<br />CANTON: SANTA CRUZ","density: 1.264333e-06<br />TOTAL_VENTAS: 161614.28<br />CANTON: SANTA CRUZ","density: 1.237605e-06<br />TOTAL_VENTAS: 163561.44<br />CANTON: SANTA CRUZ","density: 1.211162e-06<br />TOTAL_VENTAS: 165508.60<br />CANTON: SANTA CRUZ","density: 1.185058e-06<br />TOTAL_VENTAS: 167455.76<br />CANTON: SANTA CRUZ","density: 1.159475e-06<br />TOTAL_VENTAS: 169402.92<br />CANTON: SANTA CRUZ","density: 1.134491e-06<br />TOTAL_VENTAS: 171350.08<br />CANTON: SANTA CRUZ","density: 1.110084e-06<br />TOTAL_VENTAS: 173297.24<br />CANTON: SANTA CRUZ","density: 1.086303e-06<br />TOTAL_VENTAS: 175244.40<br />CANTON: SANTA CRUZ","density: 1.063278e-06<br />TOTAL_VENTAS: 177191.56<br />CANTON: SANTA CRUZ","density: 1.041262e-06<br />TOTAL_VENTAS: 179138.72<br />CANTON: SANTA CRUZ","density: 1.020076e-06<br />TOTAL_VENTAS: 181085.88<br />CANTON: SANTA CRUZ","density: 9.997575e-07<br />TOTAL_VENTAS: 183033.04<br />CANTON: SANTA CRUZ","density: 9.803438e-07<br />TOTAL_VENTAS: 184980.20<br />CANTON: SANTA CRUZ","density: 9.622658e-07<br />TOTAL_VENTAS: 186927.36<br />CANTON: SANTA CRUZ","density: 9.452348e-07<br />TOTAL_VENTAS: 188874.52<br />CANTON: SANTA CRUZ","density: 9.292367e-07<br />TOTAL_VENTAS: 190821.68<br />CANTON: SANTA CRUZ","density: 9.142919e-07<br />TOTAL_VENTAS: 192768.84<br />CANTON: SANTA CRUZ","density: 9.006902e-07<br />TOTAL_VENTAS: 194716.00<br />CANTON: SANTA CRUZ","density: 8.883822e-07<br />TOTAL_VENTAS: 196663.16<br />CANTON: SANTA CRUZ","density: 8.771751e-07<br />TOTAL_VENTAS: 198610.32<br />CANTON: SANTA CRUZ","density: 8.670696e-07<br />TOTAL_VENTAS: 200557.48<br />CANTON: SANTA CRUZ","density: 8.581772e-07<br />TOTAL_VENTAS: 202504.64<br />CANTON: SANTA CRUZ","density: 8.507221e-07<br />TOTAL_VENTAS: 204451.80<br />CANTON: SANTA CRUZ","density: 8.443297e-07<br />TOTAL_VENTAS: 206398.96<br />CANTON: SANTA CRUZ","density: 8.389808e-07<br />TOTAL_VENTAS: 208346.12<br />CANTON: SANTA CRUZ","density: 8.346546e-07<br />TOTAL_VENTAS: 210293.28<br />CANTON: SANTA CRUZ","density: 8.316878e-07<br />TOTAL_VENTAS: 212240.44<br />CANTON: SANTA CRUZ","density: 8.296830e-07<br />TOTAL_VENTAS: 214187.60<br />CANTON: SANTA CRUZ","density: 8.285645e-07<br />TOTAL_VENTAS: 216134.76<br />CANTON: SANTA CRUZ","density: 8.282948e-07<br />TOTAL_VENTAS: 218081.92<br />CANTON: SANTA CRUZ","density: 8.290095e-07<br />TOTAL_VENTAS: 220029.08<br />CANTON: SANTA CRUZ","density: 8.305693e-07<br />TOTAL_VENTAS: 221976.24<br />CANTON: SANTA CRUZ","density: 8.327802e-07<br />TOTAL_VENTAS: 223923.40<br />CANTON: SANTA CRUZ","density: 8.355933e-07<br />TOTAL_VENTAS: 225870.56<br />CANTON: SANTA CRUZ","density: 8.390047e-07<br />TOTAL_VENTAS: 227817.72<br />CANTON: SANTA CRUZ","density: 8.430171e-07<br />TOTAL_VENTAS: 229764.88<br />CANTON: SANTA CRUZ","density: 8.473988e-07<br />TOTAL_VENTAS: 231712.04<br />CANTON: SANTA CRUZ","density: 8.520964e-07<br />TOTAL_VENTAS: 233659.20<br />CANTON: SANTA CRUZ","density: 8.570563e-07<br />TOTAL_VENTAS: 235606.36<br />CANTON: SANTA CRUZ","density: 8.622556e-07<br />TOTAL_VENTAS: 237553.52<br />CANTON: SANTA CRUZ","density: 8.675394e-07<br />TOTAL_VENTAS: 239500.68<br />CANTON: SANTA CRUZ","density: 8.728491e-07<br />TOTAL_VENTAS: 241447.84<br />CANTON: SANTA CRUZ","density: 8.781342e-07<br />TOTAL_VENTAS: 243395.00<br />CANTON: SANTA CRUZ","density: 8.833020e-07<br />TOTAL_VENTAS: 245342.16<br />CANTON: SANTA CRUZ","density: 8.882608e-07<br />TOTAL_VENTAS: 247289.32<br />CANTON: SANTA CRUZ","density: 8.929856e-07<br />TOTAL_VENTAS: 249236.48<br />CANTON: SANTA CRUZ","density: 8.974346e-07<br />TOTAL_VENTAS: 251183.64<br />CANTON: SANTA CRUZ","density: 9.015290e-07<br />TOTAL_VENTAS: 253130.80<br />CANTON: SANTA CRUZ","density: 9.051086e-07<br />TOTAL_VENTAS: 255077.96<br />CANTON: SANTA CRUZ","density: 9.082495e-07<br />TOTAL_VENTAS: 257025.12<br />CANTON: SANTA CRUZ","density: 9.109224e-07<br />TOTAL_VENTAS: 258972.28<br />CANTON: SANTA CRUZ","density: 9.130990e-07<br />TOTAL_VENTAS: 260919.44<br />CANTON: SANTA CRUZ","density: 9.145332e-07<br />TOTAL_VENTAS: 262866.60<br />CANTON: SANTA CRUZ","density: 9.153688e-07<br />TOTAL_VENTAS: 264813.76<br />CANTON: SANTA CRUZ","density: 9.156147e-07<br />TOTAL_VENTAS: 266760.92<br />CANTON: SANTA CRUZ","density: 9.152563e-07<br />TOTAL_VENTAS: 268708.08<br />CANTON: SANTA CRUZ","density: 9.141285e-07<br />TOTAL_VENTAS: 270655.24<br />CANTON: SANTA CRUZ","density: 9.122456e-07<br />TOTAL_VENTAS: 272602.40<br />CANTON: SANTA CRUZ","density: 9.097224e-07<br />TOTAL_VENTAS: 274549.56<br />CANTON: SANTA CRUZ","density: 9.065570e-07<br />TOTAL_VENTAS: 276496.72<br />CANTON: SANTA CRUZ","density: 9.026878e-07<br />TOTAL_VENTAS: 278443.88<br />CANTON: SANTA CRUZ","density: 8.979689e-07<br />TOTAL_VENTAS: 280391.04<br />CANTON: SANTA CRUZ","density: 8.926221e-07<br />TOTAL_VENTAS: 282338.20<br />CANTON: SANTA CRUZ","density: 8.866561e-07<br />TOTAL_VENTAS: 284285.36<br />CANTON: SANTA CRUZ","density: 8.800801e-07<br />TOTAL_VENTAS: 286232.52<br />CANTON: SANTA CRUZ","density: 8.726891e-07<br />TOTAL_VENTAS: 288179.68<br />CANTON: SANTA CRUZ","density: 8.647044e-07<br />TOTAL_VENTAS: 290126.84<br />CANTON: SANTA CRUZ","density: 8.561709e-07<br />TOTAL_VENTAS: 292074.00<br />CANTON: SANTA CRUZ","density: 8.471051e-07<br />TOTAL_VENTAS: 294021.16<br />CANTON: SANTA CRUZ","density: 8.374127e-07<br />TOTAL_VENTAS: 295968.32<br />CANTON: SANTA CRUZ","density: 8.271564e-07<br />TOTAL_VENTAS: 297915.48<br />CANTON: SANTA CRUZ","density: 8.164548e-07<br />TOTAL_VENTAS: 299862.64<br />CANTON: SANTA CRUZ","density: 8.053291e-07<br />TOTAL_VENTAS: 301809.80<br />CANTON: SANTA CRUZ","density: 7.937679e-07<br />TOTAL_VENTAS: 303756.96<br />CANTON: SANTA CRUZ","density: 7.817269e-07<br />TOTAL_VENTAS: 305704.12<br />CANTON: SANTA CRUZ","density: 7.693635e-07<br />TOTAL_VENTAS: 307651.28<br />CANTON: SANTA CRUZ","density: 7.567012e-07<br />TOTAL_VENTAS: 309598.44<br />CANTON: SANTA CRUZ","density: 7.437636e-07<br />TOTAL_VENTAS: 311545.60<br />CANTON: SANTA CRUZ","density: 7.305012e-07<br />TOTAL_VENTAS: 313492.76<br />CANTON: SANTA CRUZ","density: 7.170343e-07<br />TOTAL_VENTAS: 315439.92<br />CANTON: SANTA CRUZ","density: 7.033983e-07<br />TOTAL_VENTAS: 317387.08<br />CANTON: SANTA CRUZ","density: 6.896166e-07<br />TOTAL_VENTAS: 319334.24<br />CANTON: SANTA CRUZ","density: 6.756948e-07<br />TOTAL_VENTAS: 321281.40<br />CANTON: SANTA CRUZ","density: 6.616839e-07<br />TOTAL_VENTAS: 323228.56<br />CANTON: SANTA CRUZ","density: 6.476270e-07<br />TOTAL_VENTAS: 325175.72<br />CANTON: SANTA CRUZ","density: 6.335450e-07<br />TOTAL_VENTAS: 327122.88<br />CANTON: SANTA CRUZ","density: 6.194613e-07<br />TOTAL_VENTAS: 329070.04<br />CANTON: SANTA CRUZ","density: 6.054201e-07<br />TOTAL_VENTAS: 331017.20<br />CANTON: SANTA CRUZ","density: 5.914390e-07<br />TOTAL_VENTAS: 332964.36<br />CANTON: SANTA CRUZ","density: 5.775344e-07<br />TOTAL_VENTAS: 334911.52<br />CANTON: SANTA CRUZ","density: 5.637226e-07<br />TOTAL_VENTAS: 336858.68<br />CANTON: SANTA CRUZ","density: 5.500713e-07<br />TOTAL_VENTAS: 338805.84<br />CANTON: SANTA CRUZ","density: 5.365671e-07<br />TOTAL_VENTAS: 340753.00<br />CANTON: SANTA CRUZ","density: 5.232145e-07<br />TOTAL_VENTAS: 342700.16<br />CANTON: SANTA CRUZ","density: 5.100242e-07<br />TOTAL_VENTAS: 344647.32<br />CANTON: SANTA CRUZ","density: 4.970496e-07<br />TOTAL_VENTAS: 346594.48<br />CANTON: SANTA CRUZ","density: 4.843009e-07<br />TOTAL_VENTAS: 348541.64<br />CANTON: SANTA CRUZ","density: 4.717487e-07<br />TOTAL_VENTAS: 350488.80<br />CANTON: SANTA CRUZ","density: 4.593977e-07<br />TOTAL_VENTAS: 352435.96<br />CANTON: SANTA CRUZ","density: 4.472708e-07<br />TOTAL_VENTAS: 354383.12<br />CANTON: SANTA CRUZ","density: 4.354262e-07<br />TOTAL_VENTAS: 356330.28<br />CANTON: SANTA CRUZ","density: 4.237942e-07<br />TOTAL_VENTAS: 358277.44<br />CANTON: SANTA CRUZ","density: 4.123747e-07<br />TOTAL_VENTAS: 360224.60<br />CANTON: SANTA CRUZ","density: 4.011676e-07<br />TOTAL_VENTAS: 362171.76<br />CANTON: SANTA CRUZ","density: 3.902491e-07<br />TOTAL_VENTAS: 364118.92<br />CANTON: SANTA CRUZ","density: 3.795491e-07<br />TOTAL_VENTAS: 366066.08<br />CANTON: SANTA CRUZ","density: 3.690531e-07<br />TOTAL_VENTAS: 368013.24<br />CANTON: SANTA CRUZ","density: 3.587581e-07<br />TOTAL_VENTAS: 369960.40<br />CANTON: SANTA CRUZ","density: 3.487047e-07<br />TOTAL_VENTAS: 371907.56<br />CANTON: SANTA CRUZ","density: 3.388803e-07<br />TOTAL_VENTAS: 373854.72<br />CANTON: SANTA CRUZ","density: 3.292423e-07<br />TOTAL_VENTAS: 375801.88<br />CANTON: SANTA CRUZ","density: 3.197876e-07<br />TOTAL_VENTAS: 377749.04<br />CANTON: SANTA CRUZ","density: 3.105275e-07<br />TOTAL_VENTAS: 379696.20<br />CANTON: SANTA CRUZ","density: 3.015024e-07<br />TOTAL_VENTAS: 381643.36<br />CANTON: SANTA CRUZ","density: 2.926485e-07<br />TOTAL_VENTAS: 383590.52<br />CANTON: SANTA CRUZ","density: 2.839643e-07<br />TOTAL_VENTAS: 385537.68<br />CANTON: SANTA CRUZ","density: 2.754481e-07<br />TOTAL_VENTAS: 387484.84<br />CANTON: SANTA CRUZ","density: 2.671601e-07<br />TOTAL_VENTAS: 389432.00<br />CANTON: SANTA CRUZ","density: 2.590486e-07<br />TOTAL_VENTAS: 391379.16<br />CANTON: SANTA CRUZ","density: 2.511046e-07<br />TOTAL_VENTAS: 393326.32<br />CANTON: SANTA CRUZ","density: 2.433290e-07<br />TOTAL_VENTAS: 395273.48<br />CANTON: SANTA CRUZ","density: 2.357623e-07<br />TOTAL_VENTAS: 397220.64<br />CANTON: SANTA CRUZ","density: 2.284055e-07<br />TOTAL_VENTAS: 399167.80<br />CANTON: SANTA CRUZ","density: 2.212268e-07<br />TOTAL_VENTAS: 401114.96<br />CANTON: SANTA CRUZ","density: 2.142295e-07<br />TOTAL_VENTAS: 403062.12<br />CANTON: SANTA CRUZ","density: 2.074324e-07<br />TOTAL_VENTAS: 405009.28<br />CANTON: SANTA CRUZ","density: 2.008932e-07<br />TOTAL_VENTAS: 406956.44<br />CANTON: SANTA CRUZ","density: 1.945518e-07<br />TOTAL_VENTAS: 408903.60<br />CANTON: SANTA CRUZ","density: 1.884118e-07<br />TOTAL_VENTAS: 410850.76<br />CANTON: SANTA CRUZ","density: 1.824773e-07<br />TOTAL_VENTAS: 412797.92<br />CANTON: SANTA CRUZ","density: 1.768316e-07<br />TOTAL_VENTAS: 414745.08<br />CANTON: SANTA CRUZ","density: 1.714168e-07<br />TOTAL_VENTAS: 416692.24<br />CANTON: SANTA CRUZ","density: 1.662225e-07<br />TOTAL_VENTAS: 418639.40<br />CANTON: SANTA CRUZ","density: 1.612513e-07<br />TOTAL_VENTAS: 420586.56<br />CANTON: SANTA CRUZ","density: 1.565566e-07<br />TOTAL_VENTAS: 422533.72<br />CANTON: SANTA CRUZ","density: 1.521375e-07<br />TOTAL_VENTAS: 424480.88<br />CANTON: SANTA CRUZ","density: 1.479477e-07<br />TOTAL_VENTAS: 426428.04<br />CANTON: SANTA CRUZ","density: 1.439870e-07<br />TOTAL_VENTAS: 428375.20<br />CANTON: SANTA CRUZ","density: 1.402730e-07<br />TOTAL_VENTAS: 430322.36<br />CANTON: SANTA CRUZ","density: 1.368638e-07<br />TOTAL_VENTAS: 432269.52<br />CANTON: SANTA CRUZ","density: 1.336763e-07<br />TOTAL_VENTAS: 434216.68<br />CANTON: SANTA CRUZ","density: 1.307070e-07<br />TOTAL_VENTAS: 436163.84<br />CANTON: SANTA CRUZ","density: 1.279519e-07<br />TOTAL_VENTAS: 438111.00<br />CANTON: SANTA CRUZ","density: 1.254786e-07<br />TOTAL_VENTAS: 440058.16<br />CANTON: SANTA CRUZ","density: 1.232146e-07<br />TOTAL_VENTAS: 442005.32<br />CANTON: SANTA CRUZ","density: 1.211398e-07<br />TOTAL_VENTAS: 443952.48<br />CANTON: SANTA CRUZ","density: 1.192474e-07<br />TOTAL_VENTAS: 445899.64<br />CANTON: SANTA CRUZ","density: 1.175648e-07<br />TOTAL_VENTAS: 447846.80<br />CANTON: SANTA CRUZ","density: 1.160729e-07<br />TOTAL_VENTAS: 449793.96<br />CANTON: SANTA CRUZ","density: 1.147271e-07<br />TOTAL_VENTAS: 451741.12<br />CANTON: SANTA CRUZ","density: 1.135183e-07<br />TOTAL_VENTAS: 453688.28<br />CANTON: SANTA CRUZ","density: 1.124458e-07<br />TOTAL_VENTAS: 455635.44<br />CANTON: SANTA CRUZ","density: 1.115225e-07<br />TOTAL_VENTAS: 457582.60<br />CANTON: SANTA CRUZ","density: 1.106941e-07<br />TOTAL_VENTAS: 459529.76<br />CANTON: SANTA CRUZ","density: 1.099509e-07<br />TOTAL_VENTAS: 461476.92<br />CANTON: SANTA CRUZ","density: 1.092834e-07<br />TOTAL_VENTAS: 463424.08<br />CANTON: SANTA CRUZ","density: 1.086979e-07<br />TOTAL_VENTAS: 465371.24<br />CANTON: SANTA CRUZ","density: 1.081595e-07<br />TOTAL_VENTAS: 467318.40<br />CANTON: SANTA CRUZ","density: 1.076552e-07<br />TOTAL_VENTAS: 469265.56<br />CANTON: SANTA CRUZ","density: 1.071764e-07<br />TOTAL_VENTAS: 471212.72<br />CANTON: SANTA CRUZ","density: 1.067143e-07<br />TOTAL_VENTAS: 473159.88<br />CANTON: SANTA CRUZ","density: 1.062521e-07<br />TOTAL_VENTAS: 475107.04<br />CANTON: SANTA CRUZ","density: 1.057798e-07<br />TOTAL_VENTAS: 477054.20<br />CANTON: SANTA CRUZ","density: 1.052906e-07<br />TOTAL_VENTAS: 479001.36<br />CANTON: SANTA CRUZ","density: 1.047752e-07<br />TOTAL_VENTAS: 480948.52<br />CANTON: SANTA CRUZ","density: 1.042127e-07<br />TOTAL_VENTAS: 482895.68<br />CANTON: SANTA CRUZ","density: 1.036075e-07<br />TOTAL_VENTAS: 484842.84<br />CANTON: SANTA CRUZ","density: 1.029552e-07<br />TOTAL_VENTAS: 486790.00<br />CANTON: SANTA CRUZ","density: 1.022516e-07<br />TOTAL_VENTAS: 488737.16<br />CANTON: SANTA CRUZ","density: 1.014715e-07<br />TOTAL_VENTAS: 490684.32<br />CANTON: SANTA CRUZ","density: 1.006266e-07<br />TOTAL_VENTAS: 492631.48<br />CANTON: SANTA CRUZ","density: 9.971966e-08<br />TOTAL_VENTAS: 494578.64<br />CANTON: SANTA CRUZ","density: 9.874986e-08<br />TOTAL_VENTAS: 496525.80<br />CANTON: SANTA CRUZ","density: 9.770319e-08<br />TOTAL_VENTAS: 498472.96<br />CANTON: SANTA CRUZ","density: 9.658124e-08<br />TOTAL_VENTAS: 500420.12<br />CANTON: SANTA CRUZ","density: 9.539974e-08<br />TOTAL_VENTAS: 502367.28<br />CANTON: SANTA CRUZ","density: 9.416117e-08<br />TOTAL_VENTAS: 504314.44<br />CANTON: SANTA CRUZ","density: 9.286492e-08<br />TOTAL_VENTAS: 506261.60<br />CANTON: SANTA CRUZ","density: 9.150480e-08<br />TOTAL_VENTAS: 508208.76<br />CANTON: SANTA CRUZ","density: 9.010565e-08<br />TOTAL_VENTAS: 510155.92<br />CANTON: SANTA CRUZ","density: 8.867328e-08<br />TOTAL_VENTAS: 512103.08<br />CANTON: SANTA CRUZ","density: 8.721373e-08<br />TOTAL_VENTAS: 514050.24<br />CANTON: SANTA CRUZ","density: 8.573244e-08<br />TOTAL_VENTAS: 515997.40<br />CANTON: SANTA CRUZ","density: 8.424842e-08<br />TOTAL_VENTAS: 517944.56<br />CANTON: SANTA CRUZ","density: 8.277146e-08<br />TOTAL_VENTAS: 519891.72<br />CANTON: SANTA CRUZ","density: 8.131029e-08<br />TOTAL_VENTAS: 521838.88<br />CANTON: SANTA CRUZ","density: 7.988347e-08<br />TOTAL_VENTAS: 523786.04<br />CANTON: SANTA CRUZ","density: 7.851175e-08<br />TOTAL_VENTAS: 525733.20<br />CANTON: SANTA CRUZ","density: 7.719919e-08<br />TOTAL_VENTAS: 527680.36<br />CANTON: SANTA CRUZ","density: 7.595597e-08<br />TOTAL_VENTAS: 529627.52<br />CANTON: SANTA CRUZ","density: 7.479905e-08<br />TOTAL_VENTAS: 531574.68<br />CANTON: SANTA CRUZ","density: 7.377654e-08<br />TOTAL_VENTAS: 533521.84<br />CANTON: SANTA CRUZ","density: 7.286929e-08<br />TOTAL_VENTAS: 535469.00<br />CANTON: SANTA CRUZ","density: 7.208707e-08<br />TOTAL_VENTAS: 537416.16<br />CANTON: SANTA CRUZ","density: 7.143950e-08<br />TOTAL_VENTAS: 539363.32<br />CANTON: SANTA CRUZ","density: 7.099393e-08<br />TOTAL_VENTAS: 541310.48<br />CANTON: SANTA CRUZ","density: 7.072471e-08<br />TOTAL_VENTAS: 543257.64<br />CANTON: SANTA CRUZ","density: 7.062765e-08<br />TOTAL_VENTAS: 545204.80<br />CANTON: SANTA CRUZ","density: 7.070957e-08<br />TOTAL_VENTAS: 547151.96<br />CANTON: SANTA CRUZ","density: 7.101784e-08<br />TOTAL_VENTAS: 549099.12<br />CANTON: SANTA CRUZ","density: 7.156451e-08<br />TOTAL_VENTAS: 551046.28<br />CANTON: SANTA CRUZ","density: 7.231100e-08<br />TOTAL_VENTAS: 552993.44<br />CANTON: SANTA CRUZ","density: 7.325940e-08<br />TOTAL_VENTAS: 554940.60<br />CANTON: SANTA CRUZ","density: 7.442454e-08<br />TOTAL_VENTAS: 556887.76<br />CANTON: SANTA CRUZ","density: 7.586638e-08<br />TOTAL_VENTAS: 558834.92<br />CANTON: SANTA CRUZ","density: 7.750764e-08<br />TOTAL_VENTAS: 560782.08<br />CANTON: SANTA CRUZ","density: 7.934448e-08<br />TOTAL_VENTAS: 562729.24<br />CANTON: SANTA CRUZ","density: 8.137261e-08<br />TOTAL_VENTAS: 564676.40<br />CANTON: SANTA CRUZ","density: 8.364601e-08<br />TOTAL_VENTAS: 566623.56<br />CANTON: SANTA CRUZ","density: 8.610084e-08<br />TOTAL_VENTAS: 568570.72<br />CANTON: SANTA CRUZ","density: 8.871309e-08<br />TOTAL_VENTAS: 570517.88<br />CANTON: SANTA CRUZ","density: 9.147265e-08<br />TOTAL_VENTAS: 572465.04<br />CANTON: SANTA CRUZ","density: 9.439168e-08<br />TOTAL_VENTAS: 574412.20<br />CANTON: SANTA CRUZ","density: 9.744556e-08<br />TOTAL_VENTAS: 576359.36<br />CANTON: SANTA CRUZ","density: 1.005906e-07<br />TOTAL_VENTAS: 578306.52<br />CANTON: SANTA CRUZ","density: 1.038125e-07<br />TOTAL_VENTAS: 580253.68<br />CANTON: SANTA CRUZ","density: 1.070984e-07<br />TOTAL_VENTAS: 582200.84<br />CANTON: SANTA CRUZ","density: 1.104295e-07<br />TOTAL_VENTAS: 584148.00<br />CANTON: SANTA CRUZ","density: 1.137674e-07<br />TOTAL_VENTAS: 586095.16<br />CANTON: SANTA CRUZ","density: 1.170957e-07<br />TOTAL_VENTAS: 588042.32<br />CANTON: SANTA CRUZ","density: 1.203981e-07<br />TOTAL_VENTAS: 589989.48<br />CANTON: SANTA CRUZ","density: 1.236304e-07<br />TOTAL_VENTAS: 591936.64<br />CANTON: SANTA CRUZ","density: 1.267763e-07<br />TOTAL_VENTAS: 593883.80<br />CANTON: SANTA CRUZ","density: 1.298248e-07<br />TOTAL_VENTAS: 595830.96<br />CANTON: SANTA CRUZ","density: 1.327607e-07<br />TOTAL_VENTAS: 597778.12<br />CANTON: SANTA CRUZ","density: 1.355377e-07<br />TOTAL_VENTAS: 599725.28<br />CANTON: SANTA CRUZ","density: 1.381238e-07<br />TOTAL_VENTAS: 601672.44<br />CANTON: SANTA CRUZ","density: 1.405373e-07<br />TOTAL_VENTAS: 603619.60<br />CANTON: SANTA CRUZ","density: 1.427668e-07<br />TOTAL_VENTAS: 605566.76<br />CANTON: SANTA CRUZ","density: 1.447888e-07<br />TOTAL_VENTAS: 607513.92<br />CANTON: SANTA CRUZ","density: 1.465207e-07<br />TOTAL_VENTAS: 609461.08<br />CANTON: SANTA CRUZ","density: 1.480282e-07<br />TOTAL_VENTAS: 611408.24<br />CANTON: SANTA CRUZ","density: 1.493054e-07<br />TOTAL_VENTAS: 613355.40<br />CANTON: SANTA CRUZ","density: 1.503466e-07<br />TOTAL_VENTAS: 615302.56<br />CANTON: SANTA CRUZ","density: 1.510618e-07<br />TOTAL_VENTAS: 617249.72<br />CANTON: SANTA CRUZ","density: 1.515096e-07<br />TOTAL_VENTAS: 619196.88<br />CANTON: SANTA CRUZ","density: 1.517098e-07<br />TOTAL_VENTAS: 621144.04<br />CANTON: SANTA CRUZ","density: 1.516625e-07<br />TOTAL_VENTAS: 623091.20<br />CANTON: SANTA CRUZ","density: 1.513193e-07<br />TOTAL_VENTAS: 625038.36<br />CANTON: SANTA CRUZ","density: 1.506786e-07<br />TOTAL_VENTAS: 626985.52<br />CANTON: SANTA CRUZ","density: 1.498009e-07<br />TOTAL_VENTAS: 628932.68<br />CANTON: SANTA CRUZ","density: 1.486907e-07<br />TOTAL_VENTAS: 630879.84<br />CANTON: SANTA CRUZ","density: 1.473405e-07<br />TOTAL_VENTAS: 632827.00<br />CANTON: SANTA CRUZ","density: 1.456935e-07<br />TOTAL_VENTAS: 634774.16<br />CANTON: SANTA CRUZ","density: 1.438416e-07<br />TOTAL_VENTAS: 636721.32<br />CANTON: SANTA CRUZ","density: 1.417925e-07<br />TOTAL_VENTAS: 638668.48<br />CANTON: SANTA CRUZ","density: 1.395543e-07<br />TOTAL_VENTAS: 640615.64<br />CANTON: SANTA CRUZ","density: 1.370804e-07<br />TOTAL_VENTAS: 642562.80<br />CANTON: SANTA CRUZ","density: 1.344326e-07<br />TOTAL_VENTAS: 644509.96<br />CANTON: SANTA CRUZ","density: 1.316357e-07<br />TOTAL_VENTAS: 646457.12<br />CANTON: SANTA CRUZ","density: 1.286992e-07<br />TOTAL_VENTAS: 648404.28<br />CANTON: SANTA CRUZ","density: 1.256110e-07<br />TOTAL_VENTAS: 650351.44<br />CANTON: SANTA CRUZ","density: 1.223882e-07<br />TOTAL_VENTAS: 652298.60<br />CANTON: SANTA CRUZ","density: 1.190701e-07<br />TOTAL_VENTAS: 654245.76<br />CANTON: SANTA CRUZ","density: 1.156666e-07<br />TOTAL_VENTAS: 656192.92<br />CANTON: SANTA CRUZ","density: 1.121846e-07<br />TOTAL_VENTAS: 658140.08<br />CANTON: SANTA CRUZ","density: 1.086243e-07<br />TOTAL_VENTAS: 660087.24<br />CANTON: SANTA CRUZ","density: 1.050233e-07<br />TOTAL_VENTAS: 662034.40<br />CANTON: SANTA CRUZ","density: 1.013914e-07<br />TOTAL_VENTAS: 663981.56<br />CANTON: SANTA CRUZ","density: 9.773828e-08<br />TOTAL_VENTAS: 665928.72<br />CANTON: SANTA CRUZ","density: 9.407729e-08<br />TOTAL_VENTAS: 667875.88<br />CANTON: SANTA CRUZ","density: 9.042781e-08<br />TOTAL_VENTAS: 669823.04<br />CANTON: SANTA CRUZ","density: 8.679954e-08<br />TOTAL_VENTAS: 671770.20<br />CANTON: SANTA CRUZ","density: 8.320157e-08<br />TOTAL_VENTAS: 673717.36<br />CANTON: SANTA CRUZ","density: 7.965417e-08<br />TOTAL_VENTAS: 675664.52<br />CANTON: SANTA CRUZ","density: 7.617775e-08<br />TOTAL_VENTAS: 677611.68<br />CANTON: SANTA CRUZ","density: 7.277074e-08<br />TOTAL_VENTAS: 679558.84<br />CANTON: SANTA CRUZ","density: 6.944135e-08<br />TOTAL_VENTAS: 681506.00<br />CANTON: SANTA CRUZ","density: 6.620287e-08<br />TOTAL_VENTAS: 683453.16<br />CANTON: SANTA CRUZ","density: 6.310219e-08<br />TOTAL_VENTAS: 685400.32<br />CANTON: SANTA CRUZ","density: 6.011390e-08<br />TOTAL_VENTAS: 687347.48<br />CANTON: SANTA CRUZ","density: 5.724507e-08<br />TOTAL_VENTAS: 689294.64<br />CANTON: SANTA CRUZ","density: 5.450265e-08<br />TOTAL_VENTAS: 691241.80<br />CANTON: SANTA CRUZ","density: 5.194308e-08<br />TOTAL_VENTAS: 693188.96<br />CANTON: SANTA CRUZ","density: 4.954478e-08<br />TOTAL_VENTAS: 695136.12<br />CANTON: SANTA CRUZ","density: 4.730069e-08<br />TOTAL_VENTAS: 697083.28<br />CANTON: SANTA CRUZ","density: 4.521623e-08<br />TOTAL_VENTAS: 699030.44<br />CANTON: SANTA CRUZ","density: 4.333022e-08<br />TOTAL_VENTAS: 700977.60<br />CANTON: SANTA CRUZ","density: 4.165985e-08<br />TOTAL_VENTAS: 702924.76<br />CANTON: SANTA CRUZ","density: 4.016954e-08<br />TOTAL_VENTAS: 704871.92<br />CANTON: SANTA CRUZ","density: 3.886283e-08<br />TOTAL_VENTAS: 706819.08<br />CANTON: SANTA CRUZ","density: 3.775245e-08<br />TOTAL_VENTAS: 708766.24<br />CANTON: SANTA CRUZ","density: 3.690688e-08<br />TOTAL_VENTAS: 710713.40<br />CANTON: SANTA CRUZ","density: 3.625659e-08<br />TOTAL_VENTAS: 712660.56<br />CANTON: SANTA CRUZ","density: 3.580295e-08<br />TOTAL_VENTAS: 714607.72<br />CANTON: SANTA CRUZ","density: 3.554714e-08<br />TOTAL_VENTAS: 716554.88<br />CANTON: SANTA CRUZ","density: 3.555627e-08<br />TOTAL_VENTAS: 718502.04<br />CANTON: SANTA CRUZ","density: 3.578276e-08<br />TOTAL_VENTAS: 720449.20<br />CANTON: SANTA CRUZ","density: 3.620667e-08<br />TOTAL_VENTAS: 722396.36<br />CANTON: SANTA CRUZ","density: 3.682678e-08<br />TOTAL_VENTAS: 724343.52<br />CANTON: SANTA CRUZ","density: 3.767763e-08<br />TOTAL_VENTAS: 726290.68<br />CANTON: SANTA CRUZ","density: 3.876356e-08<br />TOTAL_VENTAS: 728237.84<br />CANTON: SANTA CRUZ","density: 4.003480e-08<br />TOTAL_VENTAS: 730185.00<br />CANTON: SANTA CRUZ","density: 4.148767e-08<br />TOTAL_VENTAS: 732132.16<br />CANTON: SANTA CRUZ","density: 4.312610e-08<br />TOTAL_VENTAS: 734079.32<br />CANTON: SANTA CRUZ","density: 4.499869e-08<br />TOTAL_VENTAS: 736026.48<br />CANTON: SANTA CRUZ","density: 4.703182e-08<br />TOTAL_VENTAS: 737973.64<br />CANTON: SANTA CRUZ","density: 4.921959e-08<br />TOTAL_VENTAS: 739920.80<br />CANTON: SANTA CRUZ","density: 5.155594e-08<br />TOTAL_VENTAS: 741867.96<br />CANTON: SANTA CRUZ","density: 5.407616e-08<br />TOTAL_VENTAS: 743815.12<br />CANTON: SANTA CRUZ","density: 5.673447e-08<br />TOTAL_VENTAS: 745762.28<br />CANTON: SANTA CRUZ","density: 5.950958e-08<br />TOTAL_VENTAS: 747709.44<br />CANTON: SANTA CRUZ","density: 6.239369e-08<br />TOTAL_VENTAS: 749656.60<br />CANTON: SANTA CRUZ","density: 6.539438e-08<br />TOTAL_VENTAS: 751603.76<br />CANTON: SANTA CRUZ","density: 6.849869e-08<br />TOTAL_VENTAS: 753550.92<br />CANTON: SANTA CRUZ","density: 7.167395e-08<br />TOTAL_VENTAS: 755498.08<br />CANTON: SANTA CRUZ","density: 7.491124e-08<br />TOTAL_VENTAS: 757445.24<br />CANTON: SANTA CRUZ","density: 7.820309e-08<br />TOTAL_VENTAS: 759392.40<br />CANTON: SANTA CRUZ","density: 8.154520e-08<br />TOTAL_VENTAS: 761339.56<br />CANTON: SANTA CRUZ","density: 8.490808e-08<br />TOTAL_VENTAS: 763286.72<br />CANTON: SANTA CRUZ","density: 8.828247e-08<br />TOTAL_VENTAS: 765233.88<br />CANTON: SANTA CRUZ","density: 9.165910e-08<br />TOTAL_VENTAS: 767181.04<br />CANTON: SANTA CRUZ","density: 9.501953e-08<br />TOTAL_VENTAS: 769128.20<br />CANTON: SANTA CRUZ","density: 9.834906e-08<br />TOTAL_VENTAS: 771075.36<br />CANTON: SANTA CRUZ","density: 1.016401e-07<br />TOTAL_VENTAS: 773022.52<br />CANTON: SANTA CRUZ","density: 1.048840e-07<br />TOTAL_VENTAS: 774969.68<br />CANTON: SANTA CRUZ","density: 1.080586e-07<br />TOTAL_VENTAS: 776916.84<br />CANTON: SANTA CRUZ","density: 1.111423e-07<br />TOTAL_VENTAS: 778864.00<br />CANTON: SANTA CRUZ","density: 1.141420e-07<br />TOTAL_VENTAS: 780811.16<br />CANTON: SANTA CRUZ","density: 1.170498e-07<br />TOTAL_VENTAS: 782758.32<br />CANTON: SANTA CRUZ","density: 1.198540e-07<br />TOTAL_VENTAS: 784705.48<br />CANTON: SANTA CRUZ","density: 1.225030e-07<br />TOTAL_VENTAS: 786652.64<br />CANTON: SANTA CRUZ","density: 1.250294e-07<br />TOTAL_VENTAS: 788599.80<br />CANTON: SANTA CRUZ","density: 1.274273e-07<br />TOTAL_VENTAS: 790546.96<br />CANTON: SANTA CRUZ","density: 1.296909e-07<br />TOTAL_VENTAS: 792494.12<br />CANTON: SANTA CRUZ","density: 1.317658e-07<br />TOTAL_VENTAS: 794441.28<br />CANTON: SANTA CRUZ","density: 1.336745e-07<br />TOTAL_VENTAS: 796388.44<br />CANTON: SANTA CRUZ","density: 1.354280e-07<br />TOTAL_VENTAS: 798335.60<br />CANTON: SANTA CRUZ","density: 1.370226e-07<br />TOTAL_VENTAS: 800282.76<br />CANTON: SANTA CRUZ","density: 1.384245e-07<br />TOTAL_VENTAS: 802229.92<br />CANTON: SANTA CRUZ","density: 1.396175e-07<br />TOTAL_VENTAS: 804177.08<br />CANTON: SANTA CRUZ","density: 1.406405e-07<br />TOTAL_VENTAS: 806124.24<br />CANTON: SANTA CRUZ","density: 1.414923e-07<br />TOTAL_VENTAS: 808071.40<br />CANTON: SANTA CRUZ","density: 1.421657e-07<br />TOTAL_VENTAS: 810018.56<br />CANTON: SANTA CRUZ","density: 1.425999e-07<br />TOTAL_VENTAS: 811965.72<br />CANTON: SANTA CRUZ","density: 1.428635e-07<br />TOTAL_VENTAS: 813912.88<br />CANTON: SANTA CRUZ","density: 1.429585e-07<br />TOTAL_VENTAS: 815860.04<br />CANTON: SANTA CRUZ","density: 1.428869e-07<br />TOTAL_VENTAS: 817807.20<br />CANTON: SANTA CRUZ","density: 1.426012e-07<br />TOTAL_VENTAS: 819754.36<br />CANTON: SANTA CRUZ","density: 1.421439e-07<br />TOTAL_VENTAS: 821701.52<br />CANTON: SANTA CRUZ","density: 1.415374e-07<br />TOTAL_VENTAS: 823648.68<br />CANTON: SANTA CRUZ","density: 1.407874e-07<br />TOTAL_VENTAS: 825595.84<br />CANTON: SANTA CRUZ","density: 1.398778e-07<br />TOTAL_VENTAS: 827543.00<br />CANTON: SANTA CRUZ","density: 1.388147e-07<br />TOTAL_VENTAS: 829490.16<br />CANTON: SANTA CRUZ","density: 1.376409e-07<br />TOTAL_VENTAS: 831437.32<br />CANTON: SANTA CRUZ","density: 1.363655e-07<br />TOTAL_VENTAS: 833384.48<br />CANTON: SANTA CRUZ","density: 1.349956e-07<br />TOTAL_VENTAS: 835331.64<br />CANTON: SANTA CRUZ","density: 1.335239e-07<br />TOTAL_VENTAS: 837278.80<br />CANTON: SANTA CRUZ","density: 1.319987e-07<br />TOTAL_VENTAS: 839225.96<br />CANTON: SANTA CRUZ","density: 1.304326e-07<br />TOTAL_VENTAS: 841173.12<br />CANTON: SANTA CRUZ","density: 1.288382e-07<br />TOTAL_VENTAS: 843120.28<br />CANTON: SANTA CRUZ","density: 1.272338e-07<br />TOTAL_VENTAS: 845067.44<br />CANTON: SANTA CRUZ","density: 1.256482e-07<br />TOTAL_VENTAS: 847014.60<br />CANTON: SANTA CRUZ","density: 1.240970e-07<br />TOTAL_VENTAS: 848961.76<br />CANTON: SANTA CRUZ","density: 1.225950e-07<br />TOTAL_VENTAS: 850908.92<br />CANTON: SANTA CRUZ","density: 1.211739e-07<br />TOTAL_VENTAS: 852856.08<br />CANTON: SANTA CRUZ","density: 1.198721e-07<br />TOTAL_VENTAS: 854803.24<br />CANTON: SANTA CRUZ","density: 1.186877e-07<br />TOTAL_VENTAS: 856750.40<br />CANTON: SANTA CRUZ","density: 1.176355e-07<br />TOTAL_VENTAS: 858697.56<br />CANTON: SANTA CRUZ","density: 1.167364e-07<br />TOTAL_VENTAS: 860644.72<br />CANTON: SANTA CRUZ","density: 1.160797e-07<br />TOTAL_VENTAS: 862591.88<br />CANTON: SANTA CRUZ","density: 1.156203e-07<br />TOTAL_VENTAS: 864539.04<br />CANTON: SANTA CRUZ","density: 1.153713e-07<br />TOTAL_VENTAS: 866486.20<br />CANTON: SANTA CRUZ","density: 1.153455e-07<br />TOTAL_VENTAS: 868433.36<br />CANTON: SANTA CRUZ","density: 1.156380e-07<br />TOTAL_VENTAS: 870380.52<br />CANTON: SANTA CRUZ","density: 1.162198e-07<br />TOTAL_VENTAS: 872327.68<br />CANTON: SANTA CRUZ","density: 1.170727e-07<br />TOTAL_VENTAS: 874274.84<br />CANTON: SANTA CRUZ","density: 1.182052e-07<br />TOTAL_VENTAS: 876222.00<br />CANTON: SANTA CRUZ","density: 1.196767e-07<br />TOTAL_VENTAS: 878169.16<br />CANTON: SANTA CRUZ","density: 1.215232e-07<br />TOTAL_VENTAS: 880116.32<br />CANTON: SANTA CRUZ","density: 1.236734e-07<br />TOTAL_VENTAS: 882063.48<br />CANTON: SANTA CRUZ","density: 1.261293e-07<br />TOTAL_VENTAS: 884010.64<br />CANTON: SANTA CRUZ","density: 1.289014e-07<br />TOTAL_VENTAS: 885957.80<br />CANTON: SANTA CRUZ","density: 1.321009e-07<br />TOTAL_VENTAS: 887904.96<br />CANTON: SANTA CRUZ","density: 1.356006e-07<br />TOTAL_VENTAS: 889852.12<br />CANTON: SANTA CRUZ","density: 1.393953e-07<br />TOTAL_VENTAS: 891799.28<br />CANTON: SANTA CRUZ","density: 1.434790e-07<br />TOTAL_VENTAS: 893746.44<br />CANTON: SANTA CRUZ","density: 1.479266e-07<br />TOTAL_VENTAS: 895693.60<br />CANTON: SANTA CRUZ","density: 1.526636e-07<br />TOTAL_VENTAS: 897640.76<br />CANTON: SANTA CRUZ","density: 1.576456e-07<br />TOTAL_VENTAS: 899587.92<br />CANTON: SANTA CRUZ","density: 1.628596e-07<br />TOTAL_VENTAS: 901535.08<br />CANTON: SANTA CRUZ","density: 1.683236e-07<br />TOTAL_VENTAS: 903482.24<br />CANTON: SANTA CRUZ","density: 1.740209e-07<br />TOTAL_VENTAS: 905429.40<br />CANTON: SANTA CRUZ","density: 1.798779e-07<br />TOTAL_VENTAS: 907376.56<br />CANTON: SANTA CRUZ","density: 1.858755e-07<br />TOTAL_VENTAS: 909323.72<br />CANTON: SANTA CRUZ","density: 1.919968e-07<br />TOTAL_VENTAS: 911270.88<br />CANTON: SANTA CRUZ","density: 1.982360e-07<br />TOTAL_VENTAS: 913218.04<br />CANTON: SANTA CRUZ","density: 2.045224e-07<br />TOTAL_VENTAS: 915165.20<br />CANTON: SANTA CRUZ","density: 2.108332e-07<br />TOTAL_VENTAS: 917112.36<br />CANTON: SANTA CRUZ","density: 2.171456e-07<br />TOTAL_VENTAS: 919059.52<br />CANTON: SANTA CRUZ","density: 2.234131e-07<br />TOTAL_VENTAS: 921006.68<br />CANTON: SANTA CRUZ","density: 2.295965e-07<br />TOTAL_VENTAS: 922953.84<br />CANTON: SANTA CRUZ","density: 2.356759e-07<br />TOTAL_VENTAS: 924901.00<br />CANTON: SANTA CRUZ","density: 2.416281e-07<br />TOTAL_VENTAS: 926848.16<br />CANTON: SANTA CRUZ","density: 2.473965e-07<br />TOTAL_VENTAS: 928795.32<br />CANTON: SANTA CRUZ","density: 2.529160e-07<br />TOTAL_VENTAS: 930742.48<br />CANTON: SANTA CRUZ","density: 2.582062e-07<br />TOTAL_VENTAS: 932689.64<br />CANTON: SANTA CRUZ","density: 2.632458e-07<br />TOTAL_VENTAS: 934636.80<br />CANTON: SANTA CRUZ","density: 2.680065e-07<br />TOTAL_VENTAS: 936583.96<br />CANTON: SANTA CRUZ","density: 2.723364e-07<br />TOTAL_VENTAS: 938531.12<br />CANTON: SANTA CRUZ","density: 2.763287e-07<br />TOTAL_VENTAS: 940478.28<br />CANTON: SANTA CRUZ","density: 2.799670e-07<br />TOTAL_VENTAS: 942425.44<br />CANTON: SANTA CRUZ","density: 2.832355e-07<br />TOTAL_VENTAS: 944372.60<br />CANTON: SANTA CRUZ","density: 2.859911e-07<br />TOTAL_VENTAS: 946319.76<br />CANTON: SANTA CRUZ","density: 2.882838e-07<br />TOTAL_VENTAS: 948266.92<br />CANTON: SANTA CRUZ","density: 2.901509e-07<br />TOTAL_VENTAS: 950214.08<br />CANTON: SANTA CRUZ","density: 2.915836e-07<br />TOTAL_VENTAS: 952161.24<br />CANTON: SANTA CRUZ","density: 2.924988e-07<br />TOTAL_VENTAS: 954108.40<br />CANTON: SANTA CRUZ","density: 2.928410e-07<br />TOTAL_VENTAS: 956055.56<br />CANTON: SANTA CRUZ","density: 2.927257e-07<br />TOTAL_VENTAS: 958002.72<br />CANTON: SANTA CRUZ","density: 2.921520e-07<br />TOTAL_VENTAS: 959949.88<br />CANTON: SANTA CRUZ","density: 2.911097e-07<br />TOTAL_VENTAS: 961897.04<br />CANTON: SANTA CRUZ","density: 2.894271e-07<br />TOTAL_VENTAS: 963844.20<br />CANTON: SANTA CRUZ","density: 2.872973e-07<br />TOTAL_VENTAS: 965791.36<br />CANTON: SANTA CRUZ","density: 2.847270e-07<br />TOTAL_VENTAS: 967738.52<br />CANTON: SANTA CRUZ","density: 2.817235e-07<br />TOTAL_VENTAS: 969685.68<br />CANTON: SANTA CRUZ","density: 2.781726e-07<br />TOTAL_VENTAS: 971632.84<br />CANTON: SANTA CRUZ","density: 2.741730e-07<br />TOTAL_VENTAS: 973580.00<br />CANTON: SANTA CRUZ","density: 2.697892e-07<br />TOTAL_VENTAS: 975527.16<br />CANTON: SANTA CRUZ","density: 2.650353e-07<br />TOTAL_VENTAS: 977474.32<br />CANTON: SANTA CRUZ","density: 2.598730e-07<br />TOTAL_VENTAS: 979421.48<br />CANTON: SANTA CRUZ","density: 2.543018e-07<br />TOTAL_VENTAS: 981368.64<br />CANTON: SANTA CRUZ","density: 2.484330e-07<br />TOTAL_VENTAS: 983315.80<br />CANTON: SANTA CRUZ","density: 2.422851e-07<br />TOTAL_VENTAS: 985262.96<br />CANTON: SANTA CRUZ","density: 2.358724e-07<br />TOTAL_VENTAS: 987210.12<br />CANTON: SANTA CRUZ","density: 2.291406e-07<br />TOTAL_VENTAS: 989157.28<br />CANTON: SANTA CRUZ","density: 2.222167e-07<br />TOTAL_VENTAS: 991104.44<br />CANTON: SANTA CRUZ","density: 2.151210e-07<br />TOTAL_VENTAS: 993051.60<br />CANTON: SANTA CRUZ","density: 2.078737e-07<br />TOTAL_VENTAS: 994998.76<br />CANTON: SANTA CRUZ","density: 2.078737e-07<br />TOTAL_VENTAS: 994998.76<br />CANTON: SANTA CRUZ","density: 2.078737e-07<br />TOTAL_VENTAS: 994998.76<br />CANTON: SANTA CRUZ","density: 2.151210e-07<br />TOTAL_VENTAS: 993051.60<br />CANTON: SANTA CRUZ","density: 2.222167e-07<br />TOTAL_VENTAS: 991104.44<br />CANTON: SANTA CRUZ","density: 2.291406e-07<br />TOTAL_VENTAS: 989157.28<br />CANTON: SANTA CRUZ","density: 2.358724e-07<br />TOTAL_VENTAS: 987210.12<br />CANTON: SANTA CRUZ","density: 2.422851e-07<br />TOTAL_VENTAS: 985262.96<br />CANTON: SANTA CRUZ","density: 2.484330e-07<br />TOTAL_VENTAS: 983315.80<br />CANTON: SANTA CRUZ","density: 2.543018e-07<br />TOTAL_VENTAS: 981368.64<br />CANTON: SANTA CRUZ","density: 2.598730e-07<br />TOTAL_VENTAS: 979421.48<br />CANTON: SANTA CRUZ","density: 2.650353e-07<br />TOTAL_VENTAS: 977474.32<br />CANTON: SANTA CRUZ","density: 2.697892e-07<br />TOTAL_VENTAS: 975527.16<br />CANTON: SANTA CRUZ","density: 2.741730e-07<br />TOTAL_VENTAS: 973580.00<br />CANTON: SANTA CRUZ","density: 2.781726e-07<br />TOTAL_VENTAS: 971632.84<br />CANTON: SANTA CRUZ","density: 2.817235e-07<br />TOTAL_VENTAS: 969685.68<br />CANTON: SANTA CRUZ","density: 2.847270e-07<br />TOTAL_VENTAS: 967738.52<br />CANTON: SANTA CRUZ","density: 2.872973e-07<br />TOTAL_VENTAS: 965791.36<br />CANTON: SANTA CRUZ","density: 2.894271e-07<br />TOTAL_VENTAS: 963844.20<br />CANTON: SANTA CRUZ","density: 2.911097e-07<br />TOTAL_VENTAS: 961897.04<br />CANTON: SANTA CRUZ","density: 2.921520e-07<br />TOTAL_VENTAS: 959949.88<br />CANTON: SANTA CRUZ","density: 2.927257e-07<br />TOTAL_VENTAS: 958002.72<br />CANTON: SANTA CRUZ","density: 2.928410e-07<br />TOTAL_VENTAS: 956055.56<br />CANTON: SANTA CRUZ","density: 2.924988e-07<br />TOTAL_VENTAS: 954108.40<br />CANTON: SANTA CRUZ","density: 2.915836e-07<br />TOTAL_VENTAS: 952161.24<br />CANTON: SANTA CRUZ","density: 2.901509e-07<br />TOTAL_VENTAS: 950214.08<br />CANTON: SANTA CRUZ","density: 2.882838e-07<br />TOTAL_VENTAS: 948266.92<br />CANTON: SANTA CRUZ","density: 2.859911e-07<br />TOTAL_VENTAS: 946319.76<br />CANTON: SANTA CRUZ","density: 2.832355e-07<br />TOTAL_VENTAS: 944372.60<br />CANTON: SANTA CRUZ","density: 2.799670e-07<br />TOTAL_VENTAS: 942425.44<br />CANTON: SANTA CRUZ","density: 2.763287e-07<br />TOTAL_VENTAS: 940478.28<br />CANTON: SANTA CRUZ","density: 2.723364e-07<br />TOTAL_VENTAS: 938531.12<br />CANTON: SANTA CRUZ","density: 2.680065e-07<br />TOTAL_VENTAS: 936583.96<br />CANTON: SANTA CRUZ","density: 2.632458e-07<br />TOTAL_VENTAS: 934636.80<br />CANTON: SANTA CRUZ","density: 2.582062e-07<br />TOTAL_VENTAS: 932689.64<br />CANTON: SANTA CRUZ","density: 2.529160e-07<br />TOTAL_VENTAS: 930742.48<br />CANTON: SANTA CRUZ","density: 2.473965e-07<br />TOTAL_VENTAS: 928795.32<br />CANTON: SANTA CRUZ","density: 2.416281e-07<br />TOTAL_VENTAS: 926848.16<br />CANTON: SANTA CRUZ","density: 2.356759e-07<br />TOTAL_VENTAS: 924901.00<br />CANTON: SANTA CRUZ","density: 2.295965e-07<br />TOTAL_VENTAS: 922953.84<br />CANTON: SANTA CRUZ","density: 2.234131e-07<br />TOTAL_VENTAS: 921006.68<br />CANTON: SANTA CRUZ","density: 2.171456e-07<br />TOTAL_VENTAS: 919059.52<br />CANTON: SANTA CRUZ","density: 2.108332e-07<br />TOTAL_VENTAS: 917112.36<br />CANTON: SANTA CRUZ","density: 2.045224e-07<br />TOTAL_VENTAS: 915165.20<br />CANTON: SANTA CRUZ","density: 1.982360e-07<br />TOTAL_VENTAS: 913218.04<br />CANTON: SANTA CRUZ","density: 1.919968e-07<br />TOTAL_VENTAS: 911270.88<br />CANTON: SANTA CRUZ","density: 1.858755e-07<br />TOTAL_VENTAS: 909323.72<br />CANTON: SANTA CRUZ","density: 1.798779e-07<br />TOTAL_VENTAS: 907376.56<br />CANTON: SANTA CRUZ","density: 1.740209e-07<br />TOTAL_VENTAS: 905429.40<br />CANTON: SANTA CRUZ","density: 1.683236e-07<br />TOTAL_VENTAS: 903482.24<br />CANTON: SANTA CRUZ","density: 1.628596e-07<br />TOTAL_VENTAS: 901535.08<br />CANTON: SANTA CRUZ","density: 1.576456e-07<br />TOTAL_VENTAS: 899587.92<br />CANTON: SANTA CRUZ","density: 1.526636e-07<br />TOTAL_VENTAS: 897640.76<br />CANTON: SANTA CRUZ","density: 1.479266e-07<br />TOTAL_VENTAS: 895693.60<br />CANTON: SANTA CRUZ","density: 1.434790e-07<br />TOTAL_VENTAS: 893746.44<br />CANTON: SANTA CRUZ","density: 1.393953e-07<br />TOTAL_VENTAS: 891799.28<br />CANTON: SANTA CRUZ","density: 1.356006e-07<br />TOTAL_VENTAS: 889852.12<br />CANTON: SANTA CRUZ","density: 1.321009e-07<br />TOTAL_VENTAS: 887904.96<br />CANTON: SANTA CRUZ","density: 1.289014e-07<br />TOTAL_VENTAS: 885957.80<br />CANTON: SANTA CRUZ","density: 1.261293e-07<br />TOTAL_VENTAS: 884010.64<br />CANTON: SANTA CRUZ","density: 1.236734e-07<br />TOTAL_VENTAS: 882063.48<br />CANTON: SANTA CRUZ","density: 1.215232e-07<br />TOTAL_VENTAS: 880116.32<br />CANTON: SANTA CRUZ","density: 1.196767e-07<br />TOTAL_VENTAS: 878169.16<br />CANTON: SANTA CRUZ","density: 1.182052e-07<br />TOTAL_VENTAS: 876222.00<br />CANTON: SANTA CRUZ","density: 1.170727e-07<br />TOTAL_VENTAS: 874274.84<br />CANTON: SANTA CRUZ","density: 1.162198e-07<br />TOTAL_VENTAS: 872327.68<br />CANTON: SANTA CRUZ","density: 1.156380e-07<br />TOTAL_VENTAS: 870380.52<br />CANTON: SANTA CRUZ","density: 1.153455e-07<br />TOTAL_VENTAS: 868433.36<br />CANTON: SANTA CRUZ","density: 1.153713e-07<br />TOTAL_VENTAS: 866486.20<br />CANTON: SANTA CRUZ","density: 1.156203e-07<br />TOTAL_VENTAS: 864539.04<br />CANTON: SANTA CRUZ","density: 1.160797e-07<br />TOTAL_VENTAS: 862591.88<br />CANTON: SANTA CRUZ","density: 1.167364e-07<br />TOTAL_VENTAS: 860644.72<br />CANTON: SANTA CRUZ","density: 1.176355e-07<br />TOTAL_VENTAS: 858697.56<br />CANTON: SANTA CRUZ","density: 1.186877e-07<br />TOTAL_VENTAS: 856750.40<br />CANTON: SANTA CRUZ","density: 1.198721e-07<br />TOTAL_VENTAS: 854803.24<br />CANTON: SANTA CRUZ","density: 1.211739e-07<br />TOTAL_VENTAS: 852856.08<br />CANTON: SANTA CRUZ","density: 1.225950e-07<br />TOTAL_VENTAS: 850908.92<br />CANTON: SANTA CRUZ","density: 1.240970e-07<br />TOTAL_VENTAS: 848961.76<br />CANTON: SANTA CRUZ","density: 1.256482e-07<br />TOTAL_VENTAS: 847014.60<br />CANTON: SANTA CRUZ","density: 1.272338e-07<br />TOTAL_VENTAS: 845067.44<br />CANTON: SANTA CRUZ","density: 1.288382e-07<br />TOTAL_VENTAS: 843120.28<br />CANTON: SANTA CRUZ","density: 1.304326e-07<br />TOTAL_VENTAS: 841173.12<br />CANTON: SANTA CRUZ","density: 1.319987e-07<br />TOTAL_VENTAS: 839225.96<br />CANTON: SANTA CRUZ","density: 1.335239e-07<br />TOTAL_VENTAS: 837278.80<br />CANTON: SANTA CRUZ","density: 1.349956e-07<br />TOTAL_VENTAS: 835331.64<br />CANTON: SANTA CRUZ","density: 1.363655e-07<br />TOTAL_VENTAS: 833384.48<br />CANTON: SANTA CRUZ","density: 1.376409e-07<br />TOTAL_VENTAS: 831437.32<br />CANTON: SANTA CRUZ","density: 1.388147e-07<br />TOTAL_VENTAS: 829490.16<br />CANTON: SANTA CRUZ","density: 1.398778e-07<br />TOTAL_VENTAS: 827543.00<br />CANTON: SANTA CRUZ","density: 1.407874e-07<br />TOTAL_VENTAS: 825595.84<br />CANTON: SANTA CRUZ","density: 1.415374e-07<br />TOTAL_VENTAS: 823648.68<br />CANTON: SANTA CRUZ","density: 1.421439e-07<br />TOTAL_VENTAS: 821701.52<br />CANTON: SANTA CRUZ","density: 1.426012e-07<br />TOTAL_VENTAS: 819754.36<br />CANTON: SANTA CRUZ","density: 1.428869e-07<br />TOTAL_VENTAS: 817807.20<br />CANTON: SANTA CRUZ","density: 1.429585e-07<br />TOTAL_VENTAS: 815860.04<br />CANTON: SANTA CRUZ","density: 1.428635e-07<br />TOTAL_VENTAS: 813912.88<br />CANTON: SANTA CRUZ","density: 1.425999e-07<br />TOTAL_VENTAS: 811965.72<br />CANTON: SANTA CRUZ","density: 1.421657e-07<br />TOTAL_VENTAS: 810018.56<br />CANTON: SANTA CRUZ","density: 1.414923e-07<br />TOTAL_VENTAS: 808071.40<br />CANTON: SANTA CRUZ","density: 1.406405e-07<br />TOTAL_VENTAS: 806124.24<br />CANTON: SANTA CRUZ","density: 1.396175e-07<br />TOTAL_VENTAS: 804177.08<br />CANTON: SANTA CRUZ","density: 1.384245e-07<br />TOTAL_VENTAS: 802229.92<br />CANTON: SANTA CRUZ","density: 1.370226e-07<br />TOTAL_VENTAS: 800282.76<br />CANTON: SANTA CRUZ","density: 1.354280e-07<br />TOTAL_VENTAS: 798335.60<br />CANTON: SANTA CRUZ","density: 1.336745e-07<br />TOTAL_VENTAS: 796388.44<br />CANTON: SANTA CRUZ","density: 1.317658e-07<br />TOTAL_VENTAS: 794441.28<br />CANTON: SANTA CRUZ","density: 1.296909e-07<br />TOTAL_VENTAS: 792494.12<br />CANTON: SANTA CRUZ","density: 1.274273e-07<br />TOTAL_VENTAS: 790546.96<br />CANTON: SANTA CRUZ","density: 1.250294e-07<br />TOTAL_VENTAS: 788599.80<br />CANTON: SANTA CRUZ","density: 1.225030e-07<br />TOTAL_VENTAS: 786652.64<br />CANTON: SANTA CRUZ","density: 1.198540e-07<br />TOTAL_VENTAS: 784705.48<br />CANTON: SANTA CRUZ","density: 1.170498e-07<br />TOTAL_VENTAS: 782758.32<br />CANTON: SANTA CRUZ","density: 1.141420e-07<br />TOTAL_VENTAS: 780811.16<br />CANTON: SANTA CRUZ","density: 1.111423e-07<br />TOTAL_VENTAS: 778864.00<br />CANTON: SANTA CRUZ","density: 1.080586e-07<br />TOTAL_VENTAS: 776916.84<br />CANTON: SANTA CRUZ","density: 1.048840e-07<br />TOTAL_VENTAS: 774969.68<br />CANTON: SANTA CRUZ","density: 1.016401e-07<br />TOTAL_VENTAS: 773022.52<br />CANTON: SANTA CRUZ","density: 9.834906e-08<br />TOTAL_VENTAS: 771075.36<br />CANTON: SANTA CRUZ","density: 9.501953e-08<br />TOTAL_VENTAS: 769128.20<br />CANTON: SANTA CRUZ","density: 9.165910e-08<br />TOTAL_VENTAS: 767181.04<br />CANTON: SANTA CRUZ","density: 8.828247e-08<br />TOTAL_VENTAS: 765233.88<br />CANTON: SANTA CRUZ","density: 8.490808e-08<br />TOTAL_VENTAS: 763286.72<br />CANTON: SANTA CRUZ","density: 8.154520e-08<br />TOTAL_VENTAS: 761339.56<br />CANTON: SANTA CRUZ","density: 7.820309e-08<br />TOTAL_VENTAS: 759392.40<br />CANTON: SANTA CRUZ","density: 7.491124e-08<br />TOTAL_VENTAS: 757445.24<br />CANTON: SANTA CRUZ","density: 7.167395e-08<br />TOTAL_VENTAS: 755498.08<br />CANTON: SANTA CRUZ","density: 6.849869e-08<br />TOTAL_VENTAS: 753550.92<br />CANTON: SANTA CRUZ","density: 6.539438e-08<br />TOTAL_VENTAS: 751603.76<br />CANTON: SANTA CRUZ","density: 6.239369e-08<br />TOTAL_VENTAS: 749656.60<br />CANTON: SANTA CRUZ","density: 5.950958e-08<br />TOTAL_VENTAS: 747709.44<br />CANTON: SANTA CRUZ","density: 5.673447e-08<br />TOTAL_VENTAS: 745762.28<br />CANTON: SANTA CRUZ","density: 5.407616e-08<br />TOTAL_VENTAS: 743815.12<br />CANTON: SANTA CRUZ","density: 5.155594e-08<br />TOTAL_VENTAS: 741867.96<br />CANTON: SANTA CRUZ","density: 4.921959e-08<br />TOTAL_VENTAS: 739920.80<br />CANTON: SANTA CRUZ","density: 4.703182e-08<br />TOTAL_VENTAS: 737973.64<br />CANTON: SANTA CRUZ","density: 4.499869e-08<br />TOTAL_VENTAS: 736026.48<br />CANTON: SANTA CRUZ","density: 4.312610e-08<br />TOTAL_VENTAS: 734079.32<br />CANTON: SANTA CRUZ","density: 4.148767e-08<br />TOTAL_VENTAS: 732132.16<br />CANTON: SANTA CRUZ","density: 4.003480e-08<br />TOTAL_VENTAS: 730185.00<br />CANTON: SANTA CRUZ","density: 3.876356e-08<br />TOTAL_VENTAS: 728237.84<br />CANTON: SANTA CRUZ","density: 3.767763e-08<br />TOTAL_VENTAS: 726290.68<br />CANTON: SANTA CRUZ","density: 3.682678e-08<br />TOTAL_VENTAS: 724343.52<br />CANTON: SANTA CRUZ","density: 3.620667e-08<br />TOTAL_VENTAS: 722396.36<br />CANTON: SANTA CRUZ","density: 3.578276e-08<br />TOTAL_VENTAS: 720449.20<br />CANTON: SANTA CRUZ","density: 3.555627e-08<br />TOTAL_VENTAS: 718502.04<br />CANTON: SANTA CRUZ","density: 3.554714e-08<br />TOTAL_VENTAS: 716554.88<br />CANTON: SANTA CRUZ","density: 3.580295e-08<br />TOTAL_VENTAS: 714607.72<br />CANTON: SANTA CRUZ","density: 3.625659e-08<br />TOTAL_VENTAS: 712660.56<br />CANTON: SANTA CRUZ","density: 3.690688e-08<br />TOTAL_VENTAS: 710713.40<br />CANTON: SANTA CRUZ","density: 3.775245e-08<br />TOTAL_VENTAS: 708766.24<br />CANTON: SANTA CRUZ","density: 3.886283e-08<br />TOTAL_VENTAS: 706819.08<br />CANTON: SANTA CRUZ","density: 4.016954e-08<br />TOTAL_VENTAS: 704871.92<br />CANTON: SANTA CRUZ","density: 4.165985e-08<br />TOTAL_VENTAS: 702924.76<br />CANTON: SANTA CRUZ","density: 4.333022e-08<br />TOTAL_VENTAS: 700977.60<br />CANTON: SANTA CRUZ","density: 4.521623e-08<br />TOTAL_VENTAS: 699030.44<br />CANTON: SANTA CRUZ","density: 4.730069e-08<br />TOTAL_VENTAS: 697083.28<br />CANTON: SANTA CRUZ","density: 4.954478e-08<br />TOTAL_VENTAS: 695136.12<br />CANTON: SANTA CRUZ","density: 5.194308e-08<br />TOTAL_VENTAS: 693188.96<br />CANTON: SANTA CRUZ","density: 5.450265e-08<br />TOTAL_VENTAS: 691241.80<br />CANTON: SANTA CRUZ","density: 5.724507e-08<br />TOTAL_VENTAS: 689294.64<br />CANTON: SANTA CRUZ","density: 6.011390e-08<br />TOTAL_VENTAS: 687347.48<br />CANTON: SANTA CRUZ","density: 6.310219e-08<br />TOTAL_VENTAS: 685400.32<br />CANTON: SANTA CRUZ","density: 6.620287e-08<br />TOTAL_VENTAS: 683453.16<br />CANTON: SANTA CRUZ","density: 6.944135e-08<br />TOTAL_VENTAS: 681506.00<br />CANTON: SANTA CRUZ","density: 7.277074e-08<br />TOTAL_VENTAS: 679558.84<br />CANTON: SANTA CRUZ","density: 7.617775e-08<br />TOTAL_VENTAS: 677611.68<br />CANTON: SANTA CRUZ","density: 7.965417e-08<br />TOTAL_VENTAS: 675664.52<br />CANTON: SANTA CRUZ","density: 8.320157e-08<br />TOTAL_VENTAS: 673717.36<br />CANTON: SANTA CRUZ","density: 8.679954e-08<br />TOTAL_VENTAS: 671770.20<br />CANTON: SANTA CRUZ","density: 9.042781e-08<br />TOTAL_VENTAS: 669823.04<br />CANTON: SANTA CRUZ","density: 9.407729e-08<br />TOTAL_VENTAS: 667875.88<br />CANTON: SANTA CRUZ","density: 9.773828e-08<br />TOTAL_VENTAS: 665928.72<br />CANTON: SANTA CRUZ","density: 1.013914e-07<br />TOTAL_VENTAS: 663981.56<br />CANTON: SANTA CRUZ","density: 1.050233e-07<br />TOTAL_VENTAS: 662034.40<br />CANTON: SANTA CRUZ","density: 1.086243e-07<br />TOTAL_VENTAS: 660087.24<br />CANTON: SANTA CRUZ","density: 1.121846e-07<br />TOTAL_VENTAS: 658140.08<br />CANTON: SANTA CRUZ","density: 1.156666e-07<br />TOTAL_VENTAS: 656192.92<br />CANTON: SANTA CRUZ","density: 1.190701e-07<br />TOTAL_VENTAS: 654245.76<br />CANTON: SANTA CRUZ","density: 1.223882e-07<br />TOTAL_VENTAS: 652298.60<br />CANTON: SANTA CRUZ","density: 1.256110e-07<br />TOTAL_VENTAS: 650351.44<br />CANTON: SANTA CRUZ","density: 1.286992e-07<br />TOTAL_VENTAS: 648404.28<br />CANTON: SANTA CRUZ","density: 1.316357e-07<br />TOTAL_VENTAS: 646457.12<br />CANTON: SANTA CRUZ","density: 1.344326e-07<br />TOTAL_VENTAS: 644509.96<br />CANTON: SANTA CRUZ","density: 1.370804e-07<br />TOTAL_VENTAS: 642562.80<br />CANTON: SANTA CRUZ","density: 1.395543e-07<br />TOTAL_VENTAS: 640615.64<br />CANTON: SANTA CRUZ","density: 1.417925e-07<br />TOTAL_VENTAS: 638668.48<br />CANTON: SANTA CRUZ","density: 1.438416e-07<br />TOTAL_VENTAS: 636721.32<br />CANTON: SANTA CRUZ","density: 1.456935e-07<br />TOTAL_VENTAS: 634774.16<br />CANTON: SANTA CRUZ","density: 1.473405e-07<br />TOTAL_VENTAS: 632827.00<br />CANTON: SANTA CRUZ","density: 1.486907e-07<br />TOTAL_VENTAS: 630879.84<br />CANTON: SANTA CRUZ","density: 1.498009e-07<br />TOTAL_VENTAS: 628932.68<br />CANTON: SANTA CRUZ","density: 1.506786e-07<br />TOTAL_VENTAS: 626985.52<br />CANTON: SANTA CRUZ","density: 1.513193e-07<br />TOTAL_VENTAS: 625038.36<br />CANTON: SANTA CRUZ","density: 1.516625e-07<br />TOTAL_VENTAS: 623091.20<br />CANTON: SANTA CRUZ","density: 1.517098e-07<br />TOTAL_VENTAS: 621144.04<br />CANTON: SANTA CRUZ","density: 1.515096e-07<br />TOTAL_VENTAS: 619196.88<br />CANTON: SANTA CRUZ","density: 1.510618e-07<br />TOTAL_VENTAS: 617249.72<br />CANTON: SANTA CRUZ","density: 1.503466e-07<br />TOTAL_VENTAS: 615302.56<br />CANTON: SANTA CRUZ","density: 1.493054e-07<br />TOTAL_VENTAS: 613355.40<br />CANTON: SANTA CRUZ","density: 1.480282e-07<br />TOTAL_VENTAS: 611408.24<br />CANTON: SANTA CRUZ","density: 1.465207e-07<br />TOTAL_VENTAS: 609461.08<br />CANTON: SANTA CRUZ","density: 1.447888e-07<br />TOTAL_VENTAS: 607513.92<br />CANTON: SANTA CRUZ","density: 1.427668e-07<br />TOTAL_VENTAS: 605566.76<br />CANTON: SANTA CRUZ","density: 1.405373e-07<br />TOTAL_VENTAS: 603619.60<br />CANTON: SANTA CRUZ","density: 1.381238e-07<br />TOTAL_VENTAS: 601672.44<br />CANTON: SANTA CRUZ","density: 1.355377e-07<br />TOTAL_VENTAS: 599725.28<br />CANTON: SANTA CRUZ","density: 1.327607e-07<br />TOTAL_VENTAS: 597778.12<br />CANTON: SANTA CRUZ","density: 1.298248e-07<br />TOTAL_VENTAS: 595830.96<br />CANTON: SANTA CRUZ","density: 1.267763e-07<br />TOTAL_VENTAS: 593883.80<br />CANTON: SANTA CRUZ","density: 1.236304e-07<br />TOTAL_VENTAS: 591936.64<br />CANTON: SANTA CRUZ","density: 1.203981e-07<br />TOTAL_VENTAS: 589989.48<br />CANTON: SANTA CRUZ","density: 1.170957e-07<br />TOTAL_VENTAS: 588042.32<br />CANTON: SANTA CRUZ","density: 1.137674e-07<br />TOTAL_VENTAS: 586095.16<br />CANTON: SANTA CRUZ","density: 1.104295e-07<br />TOTAL_VENTAS: 584148.00<br />CANTON: SANTA CRUZ","density: 1.070984e-07<br />TOTAL_VENTAS: 582200.84<br />CANTON: SANTA CRUZ","density: 1.038125e-07<br />TOTAL_VENTAS: 580253.68<br />CANTON: SANTA CRUZ","density: 1.005906e-07<br />TOTAL_VENTAS: 578306.52<br />CANTON: SANTA CRUZ","density: 9.744556e-08<br />TOTAL_VENTAS: 576359.36<br />CANTON: SANTA CRUZ","density: 9.439168e-08<br />TOTAL_VENTAS: 574412.20<br />CANTON: SANTA CRUZ","density: 9.147265e-08<br />TOTAL_VENTAS: 572465.04<br />CANTON: SANTA CRUZ","density: 8.871309e-08<br />TOTAL_VENTAS: 570517.88<br />CANTON: SANTA CRUZ","density: 8.610084e-08<br />TOTAL_VENTAS: 568570.72<br />CANTON: SANTA CRUZ","density: 8.364601e-08<br />TOTAL_VENTAS: 566623.56<br />CANTON: SANTA CRUZ","density: 8.137261e-08<br />TOTAL_VENTAS: 564676.40<br />CANTON: SANTA CRUZ","density: 7.934448e-08<br />TOTAL_VENTAS: 562729.24<br />CANTON: SANTA CRUZ","density: 7.750764e-08<br />TOTAL_VENTAS: 560782.08<br />CANTON: SANTA CRUZ","density: 7.586638e-08<br />TOTAL_VENTAS: 558834.92<br />CANTON: SANTA CRUZ","density: 7.442454e-08<br />TOTAL_VENTAS: 556887.76<br />CANTON: SANTA CRUZ","density: 7.325940e-08<br />TOTAL_VENTAS: 554940.60<br />CANTON: SANTA CRUZ","density: 7.231100e-08<br />TOTAL_VENTAS: 552993.44<br />CANTON: SANTA CRUZ","density: 7.156451e-08<br />TOTAL_VENTAS: 551046.28<br />CANTON: SANTA CRUZ","density: 7.101784e-08<br />TOTAL_VENTAS: 549099.12<br />CANTON: SANTA CRUZ","density: 7.070957e-08<br />TOTAL_VENTAS: 547151.96<br />CANTON: SANTA CRUZ","density: 7.062765e-08<br />TOTAL_VENTAS: 545204.80<br />CANTON: SANTA CRUZ","density: 7.072471e-08<br />TOTAL_VENTAS: 543257.64<br />CANTON: SANTA CRUZ","density: 7.099393e-08<br />TOTAL_VENTAS: 541310.48<br />CANTON: SANTA CRUZ","density: 7.143950e-08<br />TOTAL_VENTAS: 539363.32<br />CANTON: SANTA CRUZ","density: 7.208707e-08<br />TOTAL_VENTAS: 537416.16<br />CANTON: SANTA CRUZ","density: 7.286929e-08<br />TOTAL_VENTAS: 535469.00<br />CANTON: SANTA CRUZ","density: 7.377654e-08<br />TOTAL_VENTAS: 533521.84<br />CANTON: SANTA CRUZ","density: 7.479905e-08<br />TOTAL_VENTAS: 531574.68<br />CANTON: SANTA CRUZ","density: 7.595597e-08<br />TOTAL_VENTAS: 529627.52<br />CANTON: SANTA CRUZ","density: 7.719919e-08<br />TOTAL_VENTAS: 527680.36<br />CANTON: SANTA CRUZ","density: 7.851175e-08<br />TOTAL_VENTAS: 525733.20<br />CANTON: SANTA CRUZ","density: 7.988347e-08<br />TOTAL_VENTAS: 523786.04<br />CANTON: SANTA CRUZ","density: 8.131029e-08<br />TOTAL_VENTAS: 521838.88<br />CANTON: SANTA CRUZ","density: 8.277146e-08<br />TOTAL_VENTAS: 519891.72<br />CANTON: SANTA CRUZ","density: 8.424842e-08<br />TOTAL_VENTAS: 517944.56<br />CANTON: SANTA CRUZ","density: 8.573244e-08<br />TOTAL_VENTAS: 515997.40<br />CANTON: SANTA CRUZ","density: 8.721373e-08<br />TOTAL_VENTAS: 514050.24<br />CANTON: SANTA CRUZ","density: 8.867328e-08<br />TOTAL_VENTAS: 512103.08<br />CANTON: SANTA CRUZ","density: 9.010565e-08<br />TOTAL_VENTAS: 510155.92<br />CANTON: SANTA CRUZ","density: 9.150480e-08<br />TOTAL_VENTAS: 508208.76<br />CANTON: SANTA CRUZ","density: 9.286492e-08<br />TOTAL_VENTAS: 506261.60<br />CANTON: SANTA CRUZ","density: 9.416117e-08<br />TOTAL_VENTAS: 504314.44<br />CANTON: SANTA CRUZ","density: 9.539974e-08<br />TOTAL_VENTAS: 502367.28<br />CANTON: SANTA CRUZ","density: 9.658124e-08<br />TOTAL_VENTAS: 500420.12<br />CANTON: SANTA CRUZ","density: 9.770319e-08<br />TOTAL_VENTAS: 498472.96<br />CANTON: SANTA CRUZ","density: 9.874986e-08<br />TOTAL_VENTAS: 496525.80<br />CANTON: SANTA CRUZ","density: 9.971966e-08<br />TOTAL_VENTAS: 494578.64<br />CANTON: SANTA CRUZ","density: 1.006266e-07<br />TOTAL_VENTAS: 492631.48<br />CANTON: SANTA CRUZ","density: 1.014715e-07<br />TOTAL_VENTAS: 490684.32<br />CANTON: SANTA CRUZ","density: 1.022516e-07<br />TOTAL_VENTAS: 488737.16<br />CANTON: SANTA CRUZ","density: 1.029552e-07<br />TOTAL_VENTAS: 486790.00<br />CANTON: SANTA CRUZ","density: 1.036075e-07<br />TOTAL_VENTAS: 484842.84<br />CANTON: SANTA CRUZ","density: 1.042127e-07<br />TOTAL_VENTAS: 482895.68<br />CANTON: SANTA CRUZ","density: 1.047752e-07<br />TOTAL_VENTAS: 480948.52<br />CANTON: SANTA CRUZ","density: 1.052906e-07<br />TOTAL_VENTAS: 479001.36<br />CANTON: SANTA CRUZ","density: 1.057798e-07<br />TOTAL_VENTAS: 477054.20<br />CANTON: SANTA CRUZ","density: 1.062521e-07<br />TOTAL_VENTAS: 475107.04<br />CANTON: SANTA CRUZ","density: 1.067143e-07<br />TOTAL_VENTAS: 473159.88<br />CANTON: SANTA CRUZ","density: 1.071764e-07<br />TOTAL_VENTAS: 471212.72<br />CANTON: SANTA CRUZ","density: 1.076552e-07<br />TOTAL_VENTAS: 469265.56<br />CANTON: SANTA CRUZ","density: 1.081595e-07<br />TOTAL_VENTAS: 467318.40<br />CANTON: SANTA CRUZ","density: 1.086979e-07<br />TOTAL_VENTAS: 465371.24<br />CANTON: SANTA CRUZ","density: 1.092834e-07<br />TOTAL_VENTAS: 463424.08<br />CANTON: SANTA CRUZ","density: 1.099509e-07<br />TOTAL_VENTAS: 461476.92<br />CANTON: SANTA CRUZ","density: 1.106941e-07<br />TOTAL_VENTAS: 459529.76<br />CANTON: SANTA CRUZ","density: 1.115225e-07<br />TOTAL_VENTAS: 457582.60<br />CANTON: SANTA CRUZ","density: 1.124458e-07<br />TOTAL_VENTAS: 455635.44<br />CANTON: SANTA CRUZ","density: 1.135183e-07<br />TOTAL_VENTAS: 453688.28<br />CANTON: SANTA CRUZ","density: 1.147271e-07<br />TOTAL_VENTAS: 451741.12<br />CANTON: SANTA CRUZ","density: 1.160729e-07<br />TOTAL_VENTAS: 449793.96<br />CANTON: SANTA CRUZ","density: 1.175648e-07<br />TOTAL_VENTAS: 447846.80<br />CANTON: SANTA CRUZ","density: 1.192474e-07<br />TOTAL_VENTAS: 445899.64<br />CANTON: SANTA CRUZ","density: 1.211398e-07<br />TOTAL_VENTAS: 443952.48<br />CANTON: SANTA CRUZ","density: 1.232146e-07<br />TOTAL_VENTAS: 442005.32<br />CANTON: SANTA CRUZ","density: 1.254786e-07<br />TOTAL_VENTAS: 440058.16<br />CANTON: SANTA CRUZ","density: 1.279519e-07<br />TOTAL_VENTAS: 438111.00<br />CANTON: SANTA CRUZ","density: 1.307070e-07<br />TOTAL_VENTAS: 436163.84<br />CANTON: SANTA CRUZ","density: 1.336763e-07<br />TOTAL_VENTAS: 434216.68<br />CANTON: SANTA CRUZ","density: 1.368638e-07<br />TOTAL_VENTAS: 432269.52<br />CANTON: SANTA CRUZ","density: 1.402730e-07<br />TOTAL_VENTAS: 430322.36<br />CANTON: SANTA CRUZ","density: 1.439870e-07<br />TOTAL_VENTAS: 428375.20<br />CANTON: SANTA CRUZ","density: 1.479477e-07<br />TOTAL_VENTAS: 426428.04<br />CANTON: SANTA CRUZ","density: 1.521375e-07<br />TOTAL_VENTAS: 424480.88<br />CANTON: SANTA CRUZ","density: 1.565566e-07<br />TOTAL_VENTAS: 422533.72<br />CANTON: SANTA CRUZ","density: 1.612513e-07<br />TOTAL_VENTAS: 420586.56<br />CANTON: SANTA CRUZ","density: 1.662225e-07<br />TOTAL_VENTAS: 418639.40<br />CANTON: SANTA CRUZ","density: 1.714168e-07<br />TOTAL_VENTAS: 416692.24<br />CANTON: SANTA CRUZ","density: 1.768316e-07<br />TOTAL_VENTAS: 414745.08<br />CANTON: SANTA CRUZ","density: 1.824773e-07<br />TOTAL_VENTAS: 412797.92<br />CANTON: SANTA CRUZ","density: 1.884118e-07<br />TOTAL_VENTAS: 410850.76<br />CANTON: SANTA CRUZ","density: 1.945518e-07<br />TOTAL_VENTAS: 408903.60<br />CANTON: SANTA CRUZ","density: 2.008932e-07<br />TOTAL_VENTAS: 406956.44<br />CANTON: SANTA CRUZ","density: 2.074324e-07<br />TOTAL_VENTAS: 405009.28<br />CANTON: SANTA CRUZ","density: 2.142295e-07<br />TOTAL_VENTAS: 403062.12<br />CANTON: SANTA CRUZ","density: 2.212268e-07<br />TOTAL_VENTAS: 401114.96<br />CANTON: SANTA CRUZ","density: 2.284055e-07<br />TOTAL_VENTAS: 399167.80<br />CANTON: SANTA CRUZ","density: 2.357623e-07<br />TOTAL_VENTAS: 397220.64<br />CANTON: SANTA CRUZ","density: 2.433290e-07<br />TOTAL_VENTAS: 395273.48<br />CANTON: SANTA CRUZ","density: 2.511046e-07<br />TOTAL_VENTAS: 393326.32<br />CANTON: SANTA CRUZ","density: 2.590486e-07<br />TOTAL_VENTAS: 391379.16<br />CANTON: SANTA CRUZ","density: 2.671601e-07<br />TOTAL_VENTAS: 389432.00<br />CANTON: SANTA CRUZ","density: 2.754481e-07<br />TOTAL_VENTAS: 387484.84<br />CANTON: SANTA CRUZ","density: 2.839643e-07<br />TOTAL_VENTAS: 385537.68<br />CANTON: SANTA CRUZ","density: 2.926485e-07<br />TOTAL_VENTAS: 383590.52<br />CANTON: SANTA CRUZ","density: 3.015024e-07<br />TOTAL_VENTAS: 381643.36<br />CANTON: SANTA CRUZ","density: 3.105275e-07<br />TOTAL_VENTAS: 379696.20<br />CANTON: SANTA CRUZ","density: 3.197876e-07<br />TOTAL_VENTAS: 377749.04<br />CANTON: SANTA CRUZ","density: 3.292423e-07<br />TOTAL_VENTAS: 375801.88<br />CANTON: SANTA CRUZ","density: 3.388803e-07<br />TOTAL_VENTAS: 373854.72<br />CANTON: SANTA CRUZ","density: 3.487047e-07<br />TOTAL_VENTAS: 371907.56<br />CANTON: SANTA CRUZ","density: 3.587581e-07<br />TOTAL_VENTAS: 369960.40<br />CANTON: SANTA CRUZ","density: 3.690531e-07<br />TOTAL_VENTAS: 368013.24<br />CANTON: SANTA CRUZ","density: 3.795491e-07<br />TOTAL_VENTAS: 366066.08<br />CANTON: SANTA CRUZ","density: 3.902491e-07<br />TOTAL_VENTAS: 364118.92<br />CANTON: SANTA CRUZ","density: 4.011676e-07<br />TOTAL_VENTAS: 362171.76<br />CANTON: SANTA CRUZ","density: 4.123747e-07<br />TOTAL_VENTAS: 360224.60<br />CANTON: SANTA CRUZ","density: 4.237942e-07<br />TOTAL_VENTAS: 358277.44<br />CANTON: SANTA CRUZ","density: 4.354262e-07<br />TOTAL_VENTAS: 356330.28<br />CANTON: SANTA CRUZ","density: 4.472708e-07<br />TOTAL_VENTAS: 354383.12<br />CANTON: SANTA CRUZ","density: 4.593977e-07<br />TOTAL_VENTAS: 352435.96<br />CANTON: SANTA CRUZ","density: 4.717487e-07<br />TOTAL_VENTAS: 350488.80<br />CANTON: SANTA CRUZ","density: 4.843009e-07<br />TOTAL_VENTAS: 348541.64<br />CANTON: SANTA CRUZ","density: 4.970496e-07<br />TOTAL_VENTAS: 346594.48<br />CANTON: SANTA CRUZ","density: 5.100242e-07<br />TOTAL_VENTAS: 344647.32<br />CANTON: SANTA CRUZ","density: 5.232145e-07<br />TOTAL_VENTAS: 342700.16<br />CANTON: SANTA CRUZ","density: 5.365671e-07<br />TOTAL_VENTAS: 340753.00<br />CANTON: SANTA CRUZ","density: 5.500713e-07<br />TOTAL_VENTAS: 338805.84<br />CANTON: SANTA CRUZ","density: 5.637226e-07<br />TOTAL_VENTAS: 336858.68<br />CANTON: SANTA CRUZ","density: 5.775344e-07<br />TOTAL_VENTAS: 334911.52<br />CANTON: SANTA CRUZ","density: 5.914390e-07<br />TOTAL_VENTAS: 332964.36<br />CANTON: SANTA CRUZ","density: 6.054201e-07<br />TOTAL_VENTAS: 331017.20<br />CANTON: SANTA CRUZ","density: 6.194613e-07<br />TOTAL_VENTAS: 329070.04<br />CANTON: SANTA CRUZ","density: 6.335450e-07<br />TOTAL_VENTAS: 327122.88<br />CANTON: SANTA CRUZ","density: 6.476270e-07<br />TOTAL_VENTAS: 325175.72<br />CANTON: SANTA CRUZ","density: 6.616839e-07<br />TOTAL_VENTAS: 323228.56<br />CANTON: SANTA CRUZ","density: 6.756948e-07<br />TOTAL_VENTAS: 321281.40<br />CANTON: SANTA CRUZ","density: 6.896166e-07<br />TOTAL_VENTAS: 319334.24<br />CANTON: SANTA CRUZ","density: 7.033983e-07<br />TOTAL_VENTAS: 317387.08<br />CANTON: SANTA CRUZ","density: 7.170343e-07<br />TOTAL_VENTAS: 315439.92<br />CANTON: SANTA CRUZ","density: 7.305012e-07<br />TOTAL_VENTAS: 313492.76<br />CANTON: SANTA CRUZ","density: 7.437636e-07<br />TOTAL_VENTAS: 311545.60<br />CANTON: SANTA CRUZ","density: 7.567012e-07<br />TOTAL_VENTAS: 309598.44<br />CANTON: SANTA CRUZ","density: 7.693635e-07<br />TOTAL_VENTAS: 307651.28<br />CANTON: SANTA CRUZ","density: 7.817269e-07<br />TOTAL_VENTAS: 305704.12<br />CANTON: SANTA CRUZ","density: 7.937679e-07<br />TOTAL_VENTAS: 303756.96<br />CANTON: SANTA CRUZ","density: 8.053291e-07<br />TOTAL_VENTAS: 301809.80<br />CANTON: SANTA CRUZ","density: 8.164548e-07<br />TOTAL_VENTAS: 299862.64<br />CANTON: SANTA CRUZ","density: 8.271564e-07<br />TOTAL_VENTAS: 297915.48<br />CANTON: SANTA CRUZ","density: 8.374127e-07<br />TOTAL_VENTAS: 295968.32<br />CANTON: SANTA CRUZ","density: 8.471051e-07<br />TOTAL_VENTAS: 294021.16<br />CANTON: SANTA CRUZ","density: 8.561709e-07<br />TOTAL_VENTAS: 292074.00<br />CANTON: SANTA CRUZ","density: 8.647044e-07<br />TOTAL_VENTAS: 290126.84<br />CANTON: SANTA CRUZ","density: 8.726891e-07<br />TOTAL_VENTAS: 288179.68<br />CANTON: SANTA CRUZ","density: 8.800801e-07<br />TOTAL_VENTAS: 286232.52<br />CANTON: SANTA CRUZ","density: 8.866561e-07<br />TOTAL_VENTAS: 284285.36<br />CANTON: SANTA CRUZ","density: 8.926221e-07<br />TOTAL_VENTAS: 282338.20<br />CANTON: SANTA CRUZ","density: 8.979689e-07<br />TOTAL_VENTAS: 280391.04<br />CANTON: SANTA CRUZ","density: 9.026878e-07<br />TOTAL_VENTAS: 278443.88<br />CANTON: SANTA CRUZ","density: 9.065570e-07<br />TOTAL_VENTAS: 276496.72<br />CANTON: SANTA CRUZ","density: 9.097224e-07<br />TOTAL_VENTAS: 274549.56<br />CANTON: SANTA CRUZ","density: 9.122456e-07<br />TOTAL_VENTAS: 272602.40<br />CANTON: SANTA CRUZ","density: 9.141285e-07<br />TOTAL_VENTAS: 270655.24<br />CANTON: SANTA CRUZ","density: 9.152563e-07<br />TOTAL_VENTAS: 268708.08<br />CANTON: SANTA CRUZ","density: 9.156147e-07<br />TOTAL_VENTAS: 266760.92<br />CANTON: SANTA CRUZ","density: 9.153688e-07<br />TOTAL_VENTAS: 264813.76<br />CANTON: SANTA CRUZ","density: 9.145332e-07<br />TOTAL_VENTAS: 262866.60<br />CANTON: SANTA CRUZ","density: 9.130990e-07<br />TOTAL_VENTAS: 260919.44<br />CANTON: SANTA CRUZ","density: 9.109224e-07<br />TOTAL_VENTAS: 258972.28<br />CANTON: SANTA CRUZ","density: 9.082495e-07<br />TOTAL_VENTAS: 257025.12<br />CANTON: SANTA CRUZ","density: 9.051086e-07<br />TOTAL_VENTAS: 255077.96<br />CANTON: SANTA CRUZ","density: 9.015290e-07<br />TOTAL_VENTAS: 253130.80<br />CANTON: SANTA CRUZ","density: 8.974346e-07<br />TOTAL_VENTAS: 251183.64<br />CANTON: SANTA CRUZ","density: 8.929856e-07<br />TOTAL_VENTAS: 249236.48<br />CANTON: SANTA CRUZ","density: 8.882608e-07<br />TOTAL_VENTAS: 247289.32<br />CANTON: SANTA CRUZ","density: 8.833020e-07<br />TOTAL_VENTAS: 245342.16<br />CANTON: SANTA CRUZ","density: 8.781342e-07<br />TOTAL_VENTAS: 243395.00<br />CANTON: SANTA CRUZ","density: 8.728491e-07<br />TOTAL_VENTAS: 241447.84<br />CANTON: SANTA CRUZ","density: 8.675394e-07<br />TOTAL_VENTAS: 239500.68<br />CANTON: SANTA CRUZ","density: 8.622556e-07<br />TOTAL_VENTAS: 237553.52<br />CANTON: SANTA CRUZ","density: 8.570563e-07<br />TOTAL_VENTAS: 235606.36<br />CANTON: SANTA CRUZ","density: 8.520964e-07<br />TOTAL_VENTAS: 233659.20<br />CANTON: SANTA CRUZ","density: 8.473988e-07<br />TOTAL_VENTAS: 231712.04<br />CANTON: SANTA CRUZ","density: 8.430171e-07<br />TOTAL_VENTAS: 229764.88<br />CANTON: SANTA CRUZ","density: 8.390047e-07<br />TOTAL_VENTAS: 227817.72<br />CANTON: SANTA CRUZ","density: 8.355933e-07<br />TOTAL_VENTAS: 225870.56<br />CANTON: SANTA CRUZ","density: 8.327802e-07<br />TOTAL_VENTAS: 223923.40<br />CANTON: SANTA CRUZ","density: 8.305693e-07<br />TOTAL_VENTAS: 221976.24<br />CANTON: SANTA CRUZ","density: 8.290095e-07<br />TOTAL_VENTAS: 220029.08<br />CANTON: SANTA CRUZ","density: 8.282948e-07<br />TOTAL_VENTAS: 218081.92<br />CANTON: SANTA CRUZ","density: 8.285645e-07<br />TOTAL_VENTAS: 216134.76<br />CANTON: SANTA CRUZ","density: 8.296830e-07<br />TOTAL_VENTAS: 214187.60<br />CANTON: SANTA CRUZ","density: 8.316878e-07<br />TOTAL_VENTAS: 212240.44<br />CANTON: SANTA CRUZ","density: 8.346546e-07<br />TOTAL_VENTAS: 210293.28<br />CANTON: SANTA CRUZ","density: 8.389808e-07<br />TOTAL_VENTAS: 208346.12<br />CANTON: SANTA CRUZ","density: 8.443297e-07<br />TOTAL_VENTAS: 206398.96<br />CANTON: SANTA CRUZ","density: 8.507221e-07<br />TOTAL_VENTAS: 204451.80<br />CANTON: SANTA CRUZ","density: 8.581772e-07<br />TOTAL_VENTAS: 202504.64<br />CANTON: SANTA CRUZ","density: 8.670696e-07<br />TOTAL_VENTAS: 200557.48<br />CANTON: SANTA CRUZ","density: 8.771751e-07<br />TOTAL_VENTAS: 198610.32<br />CANTON: SANTA CRUZ","density: 8.883822e-07<br />TOTAL_VENTAS: 196663.16<br />CANTON: SANTA CRUZ","density: 9.006902e-07<br />TOTAL_VENTAS: 194716.00<br />CANTON: SANTA CRUZ","density: 9.142919e-07<br />TOTAL_VENTAS: 192768.84<br />CANTON: SANTA CRUZ","density: 9.292367e-07<br />TOTAL_VENTAS: 190821.68<br />CANTON: SANTA CRUZ","density: 9.452348e-07<br />TOTAL_VENTAS: 188874.52<br />CANTON: SANTA CRUZ","density: 9.622658e-07<br />TOTAL_VENTAS: 186927.36<br />CANTON: SANTA CRUZ","density: 9.803438e-07<br />TOTAL_VENTAS: 184980.20<br />CANTON: SANTA CRUZ","density: 9.997575e-07<br />TOTAL_VENTAS: 183033.04<br />CANTON: SANTA CRUZ","density: 1.020076e-06<br />TOTAL_VENTAS: 181085.88<br />CANTON: SANTA CRUZ","density: 1.041262e-06<br />TOTAL_VENTAS: 179138.72<br />CANTON: SANTA CRUZ","density: 1.063278e-06<br />TOTAL_VENTAS: 177191.56<br />CANTON: SANTA CRUZ","density: 1.086303e-06<br />TOTAL_VENTAS: 175244.40<br />CANTON: SANTA CRUZ","density: 1.110084e-06<br />TOTAL_VENTAS: 173297.24<br />CANTON: SANTA CRUZ","density: 1.134491e-06<br />TOTAL_VENTAS: 171350.08<br />CANTON: SANTA CRUZ","density: 1.159475e-06<br />TOTAL_VENTAS: 169402.92<br />CANTON: SANTA CRUZ","density: 1.185058e-06<br />TOTAL_VENTAS: 167455.76<br />CANTON: SANTA CRUZ","density: 1.211162e-06<br />TOTAL_VENTAS: 165508.60<br />CANTON: SANTA CRUZ","density: 1.237605e-06<br />TOTAL_VENTAS: 163561.44<br />CANTON: SANTA CRUZ","density: 1.264333e-06<br />TOTAL_VENTAS: 161614.28<br />CANTON: SANTA CRUZ","density: 1.291295e-06<br />TOTAL_VENTAS: 159667.12<br />CANTON: SANTA CRUZ","density: 1.318442e-06<br />TOTAL_VENTAS: 157719.96<br />CANTON: SANTA CRUZ","density: 1.345634e-06<br />TOTAL_VENTAS: 155772.80<br />CANTON: SANTA CRUZ","density: 1.372818e-06<br />TOTAL_VENTAS: 153825.64<br />CANTON: SANTA CRUZ","density: 1.399946e-06<br />TOTAL_VENTAS: 151878.48<br />CANTON: SANTA CRUZ","density: 1.426902e-06<br />TOTAL_VENTAS: 149931.32<br />CANTON: SANTA CRUZ","density: 1.453630e-06<br />TOTAL_VENTAS: 147984.16<br />CANTON: SANTA CRUZ","density: 1.480107e-06<br />TOTAL_VENTAS: 146037.00<br />CANTON: SANTA CRUZ","density: 1.506296e-06<br />TOTAL_VENTAS: 144089.84<br />CANTON: SANTA CRUZ","density: 1.532099e-06<br />TOTAL_VENTAS: 142142.68<br />CANTON: SANTA CRUZ","density: 1.557435e-06<br />TOTAL_VENTAS: 140195.52<br />CANTON: SANTA CRUZ","density: 1.582373e-06<br />TOTAL_VENTAS: 138248.36<br />CANTON: SANTA CRUZ","density: 1.606903e-06<br />TOTAL_VENTAS: 136301.20<br />CANTON: SANTA CRUZ","density: 1.631003e-06<br />TOTAL_VENTAS: 134354.04<br />CANTON: SANTA CRUZ","density: 1.654528e-06<br />TOTAL_VENTAS: 132406.88<br />CANTON: SANTA CRUZ","density: 1.677664e-06<br />TOTAL_VENTAS: 130459.72<br />CANTON: SANTA CRUZ","density: 1.700436e-06<br />TOTAL_VENTAS: 128512.56<br />CANTON: SANTA CRUZ","density: 1.722872e-06<br />TOTAL_VENTAS: 126565.40<br />CANTON: SANTA CRUZ","density: 1.744946e-06<br />TOTAL_VENTAS: 124618.24<br />CANTON: SANTA CRUZ","density: 1.766817e-06<br />TOTAL_VENTAS: 122671.08<br />CANTON: SANTA CRUZ","density: 1.788586e-06<br />TOTAL_VENTAS: 120723.92<br />CANTON: SANTA CRUZ","density: 1.810325e-06<br />TOTAL_VENTAS: 118776.76<br />CANTON: SANTA CRUZ","density: 1.832156e-06<br />TOTAL_VENTAS: 116829.60<br />CANTON: SANTA CRUZ","density: 1.854297e-06<br />TOTAL_VENTAS: 114882.44<br />CANTON: SANTA CRUZ","density: 1.876848e-06<br />TOTAL_VENTAS: 112935.28<br />CANTON: SANTA CRUZ","density: 1.899931e-06<br />TOTAL_VENTAS: 110988.12<br />CANTON: SANTA CRUZ","density: 1.923697e-06<br />TOTAL_VENTAS: 109040.96<br />CANTON: SANTA CRUZ","density: 1.948736e-06<br />TOTAL_VENTAS: 107093.80<br />CANTON: SANTA CRUZ","density: 1.974944e-06<br />TOTAL_VENTAS: 105146.64<br />CANTON: SANTA CRUZ","density: 2.002487e-06<br />TOTAL_VENTAS: 103199.48<br />CANTON: SANTA CRUZ","density: 2.031528e-06<br />TOTAL_VENTAS: 101252.32<br />CANTON: SANTA CRUZ","density: 2.062893e-06<br />TOTAL_VENTAS: 99305.16<br />CANTON: SANTA CRUZ","density: 2.096581e-06<br />TOTAL_VENTAS: 97358.00<br />CANTON: SANTA CRUZ","density: 2.132575e-06<br />TOTAL_VENTAS: 95410.84<br />CANTON: SANTA CRUZ","density: 2.171060e-06<br />TOTAL_VENTAS: 93463.68<br />CANTON: SANTA CRUZ","density: 2.212741e-06<br />TOTAL_VENTAS: 91516.52<br />CANTON: SANTA CRUZ","density: 2.258261e-06<br />TOTAL_VENTAS: 89569.36<br />CANTON: SANTA CRUZ","density: 2.307088e-06<br />TOTAL_VENTAS: 87622.20<br />CANTON: SANTA CRUZ","density: 2.359390e-06<br />TOTAL_VENTAS: 85675.04<br />CANTON: SANTA CRUZ","density: 2.415435e-06<br />TOTAL_VENTAS: 83727.88<br />CANTON: SANTA CRUZ","density: 2.476957e-06<br />TOTAL_VENTAS: 81780.72<br />CANTON: SANTA CRUZ","density: 2.542604e-06<br />TOTAL_VENTAS: 79833.56<br />CANTON: SANTA CRUZ","density: 2.612480e-06<br />TOTAL_VENTAS: 77886.40<br />CANTON: SANTA CRUZ","density: 2.686680e-06<br />TOTAL_VENTAS: 75939.24<br />CANTON: SANTA CRUZ","density: 2.766695e-06<br />TOTAL_VENTAS: 73992.08<br />CANTON: SANTA CRUZ","density: 2.851736e-06<br />TOTAL_VENTAS: 72044.92<br />CANTON: SANTA CRUZ","density: 2.941271e-06<br />TOTAL_VENTAS: 70097.76<br />CANTON: SANTA CRUZ","density: 3.035276e-06<br />TOTAL_VENTAS: 68150.60<br />CANTON: SANTA CRUZ","density: 3.134427e-06<br />TOTAL_VENTAS: 66203.44<br />CANTON: SANTA CRUZ","density: 3.238924e-06<br />TOTAL_VENTAS: 64256.28<br />CANTON: SANTA CRUZ","density: 3.347449e-06<br />TOTAL_VENTAS: 62309.12<br />CANTON: SANTA CRUZ","density: 3.459819e-06<br />TOTAL_VENTAS: 60361.96<br />CANTON: SANTA CRUZ","density: 3.575912e-06<br />TOTAL_VENTAS: 58414.80<br />CANTON: SANTA CRUZ","density: 3.696492e-06<br />TOTAL_VENTAS: 56467.64<br />CANTON: SANTA CRUZ","density: 3.819743e-06<br />TOTAL_VENTAS: 54520.48<br />CANTON: SANTA CRUZ","density: 3.945309e-06<br />TOTAL_VENTAS: 52573.32<br />CANTON: SANTA CRUZ","density: 4.072819e-06<br />TOTAL_VENTAS: 50626.16<br />CANTON: SANTA CRUZ","density: 4.202050e-06<br />TOTAL_VENTAS: 48679.00<br />CANTON: SANTA CRUZ","density: 4.331859e-06<br />TOTAL_VENTAS: 46731.84<br />CANTON: SANTA CRUZ","density: 4.461582e-06<br />TOTAL_VENTAS: 44784.68<br />CANTON: SANTA CRUZ","density: 4.590706e-06<br />TOTAL_VENTAS: 42837.52<br />CANTON: SANTA CRUZ","density: 4.718332e-06<br />TOTAL_VENTAS: 40890.36<br />CANTON: SANTA CRUZ","density: 4.843093e-06<br />TOTAL_VENTAS: 38943.20<br />CANTON: SANTA CRUZ","density: 4.964738e-06<br />TOTAL_VENTAS: 36996.04<br />CANTON: SANTA CRUZ","density: 5.082679e-06<br />TOTAL_VENTAS: 35048.88<br />CANTON: SANTA CRUZ","density: 5.196213e-06<br />TOTAL_VENTAS: 33101.72<br />CANTON: SANTA CRUZ","density: 5.302218e-06<br />TOTAL_VENTAS: 31154.56<br />CANTON: SANTA CRUZ","density: 5.401881e-06<br />TOTAL_VENTAS: 29207.40<br />CANTON: SANTA CRUZ","density: 5.494643e-06<br />TOTAL_VENTAS: 27260.24<br />CANTON: SANTA CRUZ","density: 5.579950e-06<br />TOTAL_VENTAS: 25313.08<br />CANTON: SANTA CRUZ","density: 5.654474e-06<br />TOTAL_VENTAS: 23365.92<br />CANTON: SANTA CRUZ","density: 5.718778e-06<br />TOTAL_VENTAS: 21418.76<br />CANTON: SANTA CRUZ","density: 5.773457e-06<br />TOTAL_VENTAS: 19471.60<br />CANTON: SANTA CRUZ","density: 5.818112e-06<br />TOTAL_VENTAS: 17524.44<br />CANTON: SANTA CRUZ","density: 5.850573e-06<br />TOTAL_VENTAS: 15577.28<br />CANTON: SANTA CRUZ","density: 5.869092e-06<br />TOTAL_VENTAS: 13630.12<br />CANTON: SANTA CRUZ","density: 5.876280e-06<br />TOTAL_VENTAS: 11682.96<br />CANTON: SANTA CRUZ","density: 5.871980e-06<br />TOTAL_VENTAS: 9735.80<br />CANTON: SANTA CRUZ","density: 5.855839e-06<br />TOTAL_VENTAS: 7788.64<br />CANTON: SANTA CRUZ","density: 5.823185e-06<br />TOTAL_VENTAS: 5841.48<br />CANTON: SANTA CRUZ","density: 5.778886e-06<br />TOTAL_VENTAS: 3894.32<br />CANTON: SANTA CRUZ","density: 5.723066e-06<br />TOTAL_VENTAS: 1947.16<br />CANTON: SANTA CRUZ","density: 5.655872e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: SANTA CRUZ","density: 5.655872e-06<br />TOTAL_VENTAS: 0.00<br />CANTON: SANTA CRUZ"],"type":"scatter","mode":"lines","line":{"width":null,"color":"rgba(0,0,0,0.4)","dash":"solid"},"fill":"toself","fillcolor":"rgba(97,156,255,0.4)","hoveron":"points","name":"SANTA CRUZ","legendgroup":"SANTA CRUZ","showlegend":true,"xaxis":"x","yaxis":"y","hoverinfo":"text","frame":null}],"layout":{"margin":{"t":40.2990021985456,"r":7.30593607305936,"b":36.7190935227465,"l":72.3287671232877},"plot_bgcolor":"rgba(235,235,235,1)","paper_bgcolor":"rgba(255,255,255,1)","font":{"color":"rgba(0,0,0,1)","family":"","size":14.6118721461187},"title":{"text":"Total de Ventas - Densidad","font":{"color":"rgba(0,0,0,1)","family":"","size":17.5342465753425},"x":0,"xref":"paper"},"xaxis":{"domain":[0,1],"automargin":true,"type":"linear","autorange":false,"range":[-49749.938,1044748.698],"tickmode":"array","ticktext":["0","250000","500000","750000","1000000"],"tickvals":[0,250000,500000,750000,1000000],"categoryorder":"array","categoryarray":["0","250000","500000","750000","1000000"],"nticks":null,"ticks":"outside","tickcolor":"rgba(51,51,51,1)","ticklen":3.65296803652968,"tickwidth":0,"showticklabels":true,"tickfont":{"color":"rgba(77,77,77,1)","family":"","size":11.689497716895},"tickangle":-0,"showline":false,"linecolor":null,"linewidth":0,"showgrid":true,"gridcolor":"rgba(255,255,255,1)","gridwidth":0,"zeroline":false,"anchor":"y","title":{"text":"Total de Ventas (USD)","font":{"color":"rgba(0,0,0,1)","family":"","size":14.6118721461187}},"hoverformat":".2f"},"yaxis":{"domain":[0,1],"automargin":true,"type":"linear","autorange":false,"range":[-3.30744586740116e-07,6.94563632154244e-06],"tickmode":"array","ticktext":["0.000000","0.000002","0.000004","0.000006"],"tickvals":[0,2e-06,4e-06,6e-06],"categoryorder":"array","categoryarray":["0.000000","0.000002","0.000004","0.000006"],"nticks":null,"ticks":"outside","tickcolor":"rgba(51,51,51,1)","ticklen":3.65296803652968,"tickwidth":0,"showticklabels":true,"tickfont":{"color":"rgba(77,77,77,1)","family":"","size":11.689497716895},"tickangle":-0,"showline":false,"linecolor":null,"linewidth":0,"showgrid":true,"gridcolor":"rgba(255,255,255,1)","gridwidth":0,"zeroline":false,"anchor":"x","title":{"text":"Densidad","font":{"color":"rgba(0,0,0,1)","family":"","size":14.6118721461187}},"hoverformat":".2f"},"shapes":[{"type":"rect","fillcolor":null,"line":{"color":null,"width":0,"linetype":[]},"yref":"paper","xref":"paper","x0":0,"x1":1,"y0":0,"y1":1}],"showlegend":true,"legend":{"bgcolor":"rgba(255,255,255,1)","bordercolor":"transparent","borderwidth":0,"font":{"color":"rgba(0,0,0,1)","family":"","size":11.689497716895},"title":{"text":"Canton","font":{"color":"rgba(0,0,0,1)","family":"","size":14.6118721461187}}},"hovermode":"closest","barmode":"relative"},"config":{"doubleClick":"reset","modeBarButtonsToAdd":["hoverclosest","hovercompare"],"showSendToCloud":false},"source":"A","attrs":{"5d4021263ec8":{"x":{},"fill":{},"type":"scatter"}},"cur_data":"5d4021263ec8","visdat":{"5d4021263ec8":["function (y) ","x"]},"highlight":{"on":"plotly_click","persistent":false,"dynamic":false,"selectize":false,"opacityDim":0.2,"selected":{"opacity":1},"debounce":0},"shinyEvents":["plotly_hover","plotly_click","plotly_selected","plotly_relayout","plotly_brushed","plotly_brushing","plotly_clickannotation","plotly_doubleclick","plotly_deselect","plotly_afterplot","plotly_sunburstclick"],"base_url":"https://plot.ly"},"evals":[],"jsHooks":[]}</script> ] --- class: middle, center, inverse <br> <br> # Gramática de gráficos con `ggplot2` ## **CAPÍTULO 4** <br> <br> .center[ ### [@MasappEC <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M504 256C504 119 393 8 256 8S8 119 8 256c0 123.78 90.69 226.38 209.25 245V327.69h-63V256h63v-54.64c0-62.15 37-96.48 93.67-96.48 27.14 0 55.52 4.84 55.52 4.84v61h-31.28c-30.8 0-40.41 19.12-40.41 38.73V256h68.78l-11 71.69h-57.78V501C413.31 482.38 504 379.78 504 256z"/></svg>](https://www.facebook.com/MasappEC/) ### [@Masappdata <svg aria-hidden="true" role="img" viewBox="0 0 512 512" style="height:1em;width:1em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M459.37 151.716c.325 4.548.325 9.097.325 13.645 0 138.72-105.583 298.558-298.558 298.558-59.452 0-114.68-17.219-161.137-47.106 8.447.974 16.568 1.299 25.34 1.299 49.055 0 94.213-16.568 130.274-44.832-46.132-.975-84.792-31.188-98.112-72.772 6.498.974 12.995 1.624 19.818 1.624 9.421 0 18.843-1.3 27.614-3.573-48.081-9.747-84.143-51.98-84.143-102.985v-1.299c13.969 7.797 30.214 12.67 47.431 13.319-28.264-18.843-46.781-51.005-46.781-87.391 0-19.492 5.197-37.36 14.294-52.954 51.655 63.675 129.3 105.258 216.365 109.807-1.624-7.797-2.599-15.918-2.599-24.04 0-57.828 46.782-104.934 104.934-104.934 30.213 0 57.502 12.67 76.67 33.137 23.715-4.548 46.456-13.32 66.599-25.34-7.798 24.366-24.366 44.833-46.132 57.827 21.117-2.273 41.584-8.122 60.426-16.243-14.292 20.791-32.161 39.308-52.628 54.253z"/></svg>](https://twitter.com/Masappdata) ] .pull-right[ Para dudas y preguntas: <svg aria-hidden="true" role="img" viewBox="0 0 448 512" style="height:1em;width:0.88em;vertical-align:-0.125em;margin-left:auto;margin-right:auto;font-size:inherit;fill:currentColor;overflow:visible;position:relative;"><path d="M380.9 97.1C339 55.1 283.2 32 223.9 32c-122.4 0-222 99.6-222 222 0 39.1 10.2 77.3 29.6 111L0 480l117.7-30.9c32.4 17.7 68.9 27 106.1 27h.1c122.3 0 224.1-99.6 224.1-222 0-59.3-25.2-115-67.1-157zm-157 341.6c-33.2 0-65.7-8.9-94-25.7l-6.7-4-69.8 18.3L72 359.2l-4.4-7c-18.5-29.4-28.2-63.3-28.2-98.2 0-101.7 82.8-184.5 184.6-184.5 49.3 0 95.6 19.2 130.4 54.1 34.8 34.9 56.2 81.2 56.1 130.5 0 101.8-84.9 184.6-186.6 184.6zm101.2-138.2c-5.5-2.8-32.8-16.2-37.9-18-5.1-1.9-8.8-2.8-12.5 2.8-3.7 5.6-14.3 18-17.6 21.8-3.2 3.7-6.5 4.2-12 1.4-32.6-16.3-54-29.1-75.5-66-5.7-9.8 5.7-9.1 16.3-30.3 1.8-3.7.9-6.9-.5-9.7-1.4-2.8-12.5-30.1-17.1-41.2-4.5-10.8-9.1-9.3-12.5-9.5-3.2-.2-6.9-.2-10.6-.2-3.7 0-9.7 1.4-14.8 6.9-5.1 5.6-19.4 19-19.4 46.3 0 27.3 19.9 53.7 22.6 57.4 2.8 3.7 39.1 59.7 94.8 83.8 35.2 15.2 49 16.5 66.6 13.9 10.7-1.6 32.8-13.4 37.4-26.4 4.6-13 4.6-24.1 3.2-26.4-1.3-2.5-5-3.9-10.5-6.6z"/></svg> Linda Cabrera O. (+34 924 609 588) ]